苹果发布第三代 Apple Foundation Models(AFM)
Introducing the Third Generation of Apple’s Foundation Models
苹果推出第三代 Apple Foundation Models(AFM)基础模型家族,与 Google 合作定制,包含五个模型,覆盖从设备端到基于 Private Cloud Compute 的服务器端模型。这些模型旨在驱动 Apple Intelligence 功能,包括全新 Siri 和智能工具,以用户为中心深度融合操作系统,隐私为核心设计原则。
Apple与Google罕见联手推出的第三代基础模型,直接为下一代Siri和系统级AI功能铺路,标志着消费级AI的深度整合,产品经理和iOS开发者必须关注。

我们的下一代 Apple Intelligence 以用户为中心,深度集成于我们的操作系统之中,并由一套以隐私为核心的大胆新架构驱动。
这套架构的核心是我们的第三代 Apple Foundation Models(AFM),这是与 Google 合作定制构建的五个基础模型组成的模型家族,涵盖从端侧模型到运行在 Private Cloud Compute 上的服务器端模型。
Apple Foundation Models 旨在为用户解锁丰富多样的实用体验,例如全新的 Siri,以及让日常应用更智能、更好用的智能工具。
这一模型家族包括两个端侧模型:
- AFM 3 Core,我们 30 亿参数稠密模型的下一代,质量显著提升。
- AFM 3 Core Advanced,我们最强大的端侧模型。它原生支持多模态,可实现富有表现力的语音和更高准确率的听写等实用功能。基于 Apple 前沿研究成果,这个 200 亿参数的模型采用稀疏架构,可根据请求仅激活 10 亿至 40 亿参数。AFM 3 Core Advanced 由我们最强大的 Apple 芯片系统解锁,并针对其进行了优化。
我们最新的 Apple Foundation Models 还包括三个运行在 Private Cloud Compute 上的服务器端模型,该机制确保用户数据绝不会被存储或与任何人共享,包括 Apple 在内。这些模型是:
- AFM 3 Cloud,我们的服务器端主力模型,针对速度、效率和性能进行了优化。
- ADM 3 Cloud (Image),用于图像生成与编辑,解锁了高级照片编辑工具、全新的 Image Playground 等功能。
- AFM 3 Cloud Pro,我们能力最强的服务器端模型,支撑着我们要求最严苛的使用场景,如智能体工具使用和复杂推理。
AFM 3 Core、AFM 3 Core Advanced 和 AFM 3 Cloud,以及 ADM 3 Cloud,全部是为 Apple 芯片量身定制的。
对于 AFM 3 Cloud Pro,我们与 Google 和 NVIDIA 合作,将 Private Cloud Compute 扩展至 Google Cloud 中的 NVIDIA GPU,同时保持同等保障以保护用户隐私。更多详情请访问我们的 安全研究网站。
我们的第三代 Apple Foundation Models 在能力和质量方面都取得了重大进展。在下面的概述中,我们将深入探讨驱动我们端侧模型和服务器端模型的可扩展架构、我们的训练方法等更多内容。
模型架构
我们为端侧和服务器端模型设计了相应的架构,以便为用户带来强大的 Apple Intelligence 体验,并将我们最新的模型深度集成到操作系统中。
最大化端侧 AI 能力
我们最强大的端侧模型 AFM 3 Core Advanced 是深度创新的一个领域。传统大语言模型——无论是稠密还是稀疏激活架构——都需要将所有权重驻留在活动内存(DRAM)中,由此产生的巨大占用限制了其在消费级硬件上的可扩展性。为突破这一瓶颈,AFM 3 Core Advanced 引入了一种基于 指令遵循剪枝(Instruction-Following Pruning, IFP)的新型稀疏激活架构,该技术由 Apple 研究人员开发(见 图 1)。
AFM 3 Core Advanced 并不强迫整个模型装入 DRAM,而是将完整模型存储在闪存(NAND)中。由于 NAND 到 DRAM 的带宽太慢,无法像标准 MoE 模型要求的那样逐 token 交换权重,因此 AFM 3 Core Advanced 按提示词(prompt)做出路由决策。一个轻量的稠密块在初始处理阶段选出一组固定的专家,并在生成过程中周期性地重新选择。为最大限度减少数据搬运,该模型依赖高比例的始终激活的“共享专家”,同时搭配仅在需要时才换入 DRAM 的、依赖输入的“路由专家”。
AFM 3 Core Advanced 模型架构
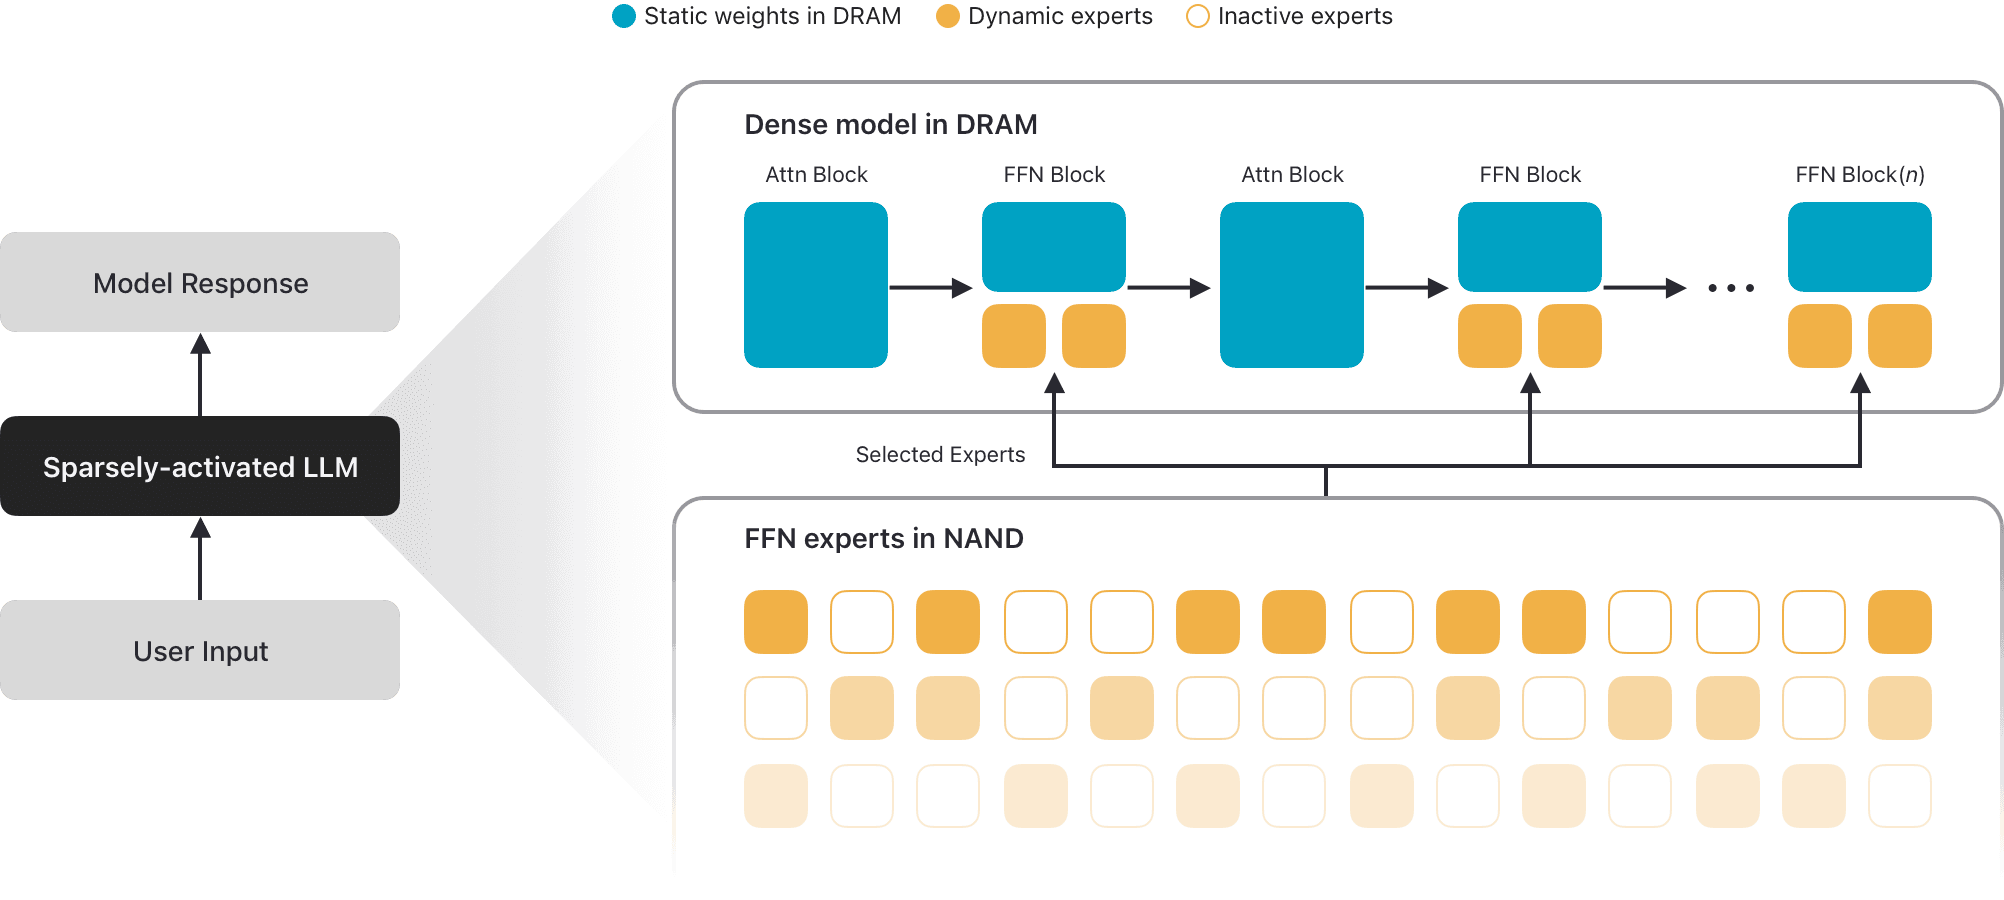
图 1:AFM 3 Core Advanced 模型架构示意图。模型的绝大部分参数是与堆叠 Transformer 架构中的前馈(FFN)块相关联的“专家”权重。给定用户查询后,模型会选择性地加载一小部分专家,并将其与共享的静态权重拼接,在 DRAM 中构成一个稠密模型。在 token 生成过程中,模型会周期性地重新选择并更新被激活的专家。
这种设计还带来了关键的推理时弹性。AFM 3 Core Advanced 不再对所有任务使用单一模型,也不用管理一组较小模型的集合,而是为每个具体使用场景使用预先确定的激活参数量。这使得权重可以根据不同难度的请求逐步加载,将模型规模扩展到远超传统 DRAM 上限,同时将延迟降到最低。
扩展服务器端基础模型
除了在端侧 AI 上的创新之外,我们还在基于服务器的模型方面迈出了一大步。例如,我们的服务器端模型 AFM 3 Cloud 是由 Private Cloud Compute 驱动的多模态推理能力的重大进步。为实现这一点,我们对去年推出的 Parallel-Track Mixture-of-Experts(PT-MoE) 基础架构进行了多项关键升级。这些架构上的改进稳定了训练,并提升了模型在其上下文窗口内进行推理以及准确回忆信息的能力,以应对复杂的服务器端查询。
使用 ADM 3 Cloud 创建和编辑图像
我们在模型架构上取得进展的另一个例子是我们最新的图像模型 ADM 3 Cloud。为支持高质量图像生成(见 图 2)、图像编辑和 Genmoji,我们开发了 ADM 3 Cloud,以实现强大的可控性和参数效率。它能泛化到不同的宽高比和分辨率,并借助更广泛的 Apple Foundation Model 模型族来引导生成与编辑。基础模型本身即可处理图像生成、编辑和 Genmoji,我们还使用专门的适配器来驱动特定的下游编辑体验,例如照片应用中的空间重构(Spatial Reframing),以及 Image Playground 中基于触控的图像修改和个性化功能。
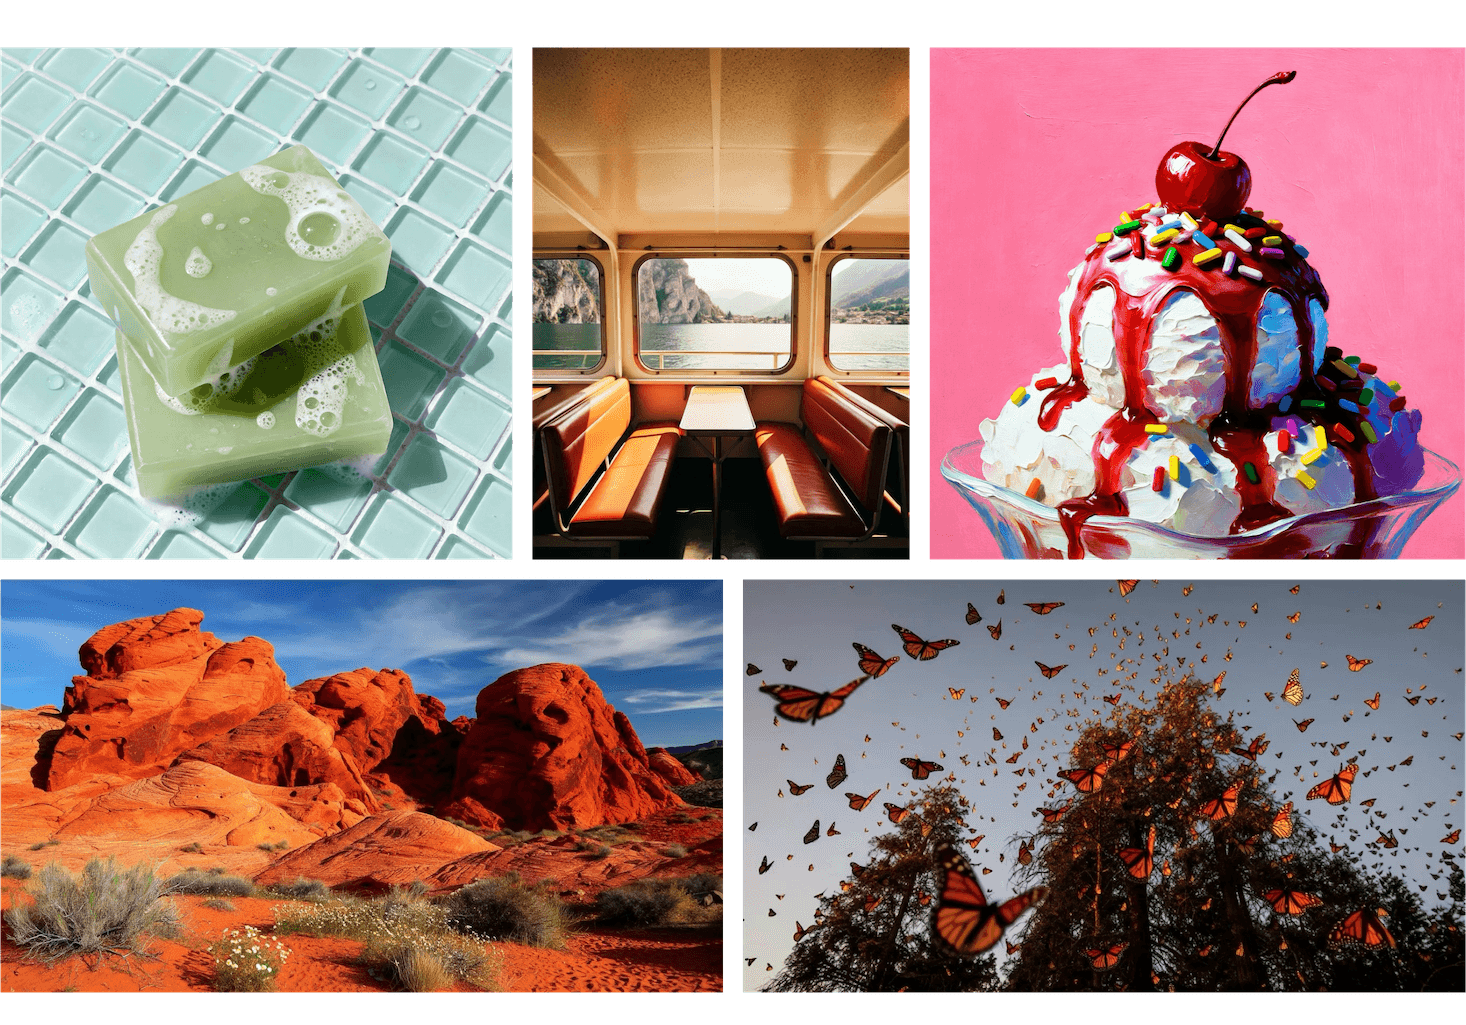
图 2:由 ADM 3 Cloud 驱动的原生图像生成示例。该模型在多样化主体和复杂光照条件下均展现出照片级的真实感。
训练数据
强大的基础模型需要多样化、高质量的数据。为训练我们的基础模型,我们使用的数据组合包括公开可获取的信息、从第三方获得授权或购买的数据、开源数据、通过专项研究获得的数据,以及合成数据。我们在训练基础模型时不会使用用户的私人个人数据或用户交互数据。我们也尊重网页发布者选择退出基础模型训练的权利。
训练方案
为了支持全新的 Apple Intelligence 体验,我们在最新一代云 TPU 加速器上大幅扩展了预训练。所有模型在针对各自架构和用例进行专门化之前,共享一个通用的初始基础,并加入了多模态能力,如音频、图像理解、长上下文推理和高质量视觉生成。随后我们扩展了后训练流程,将监督微调与多阶段强化学习相结合。
最后,我们针对每个模型的目标硬件进行了优化。AFM 3 Core、AFM 3 Core Advanced、AFM 3 Cloud 和 ADM 3 Cloud(Image)经过优化,可在 Apple 芯片上高效运行,而 AFM 3 Cloud Pro 则针对 NVIDIA GPU 进行了优化。通过量化感知训练(Quantization Aware Training),我们在保持高准确率的同时大幅压缩了模型,共同为用户带来了响应迅速、高质量且符合预期的体验。
评测
我们的第三代 Apple 基础模型旨在驱动一体化的 Apple Intelligence 体验,让我们的操作系统更智能、更有用,我们在模型和功能两个层面都进行了质量评测。
下面,我们先详细介绍模型层面的评测,随后是这些模型所解锁功能的结果。这些评测反映了模型当前的开发阶段。在测试期间,我们将持续改进,为用户带来出色的体验。
模型层面评测
为确保卓越的使用体验,内部人工评估员会从关键维度评估模型的回复,包括指令遵循、真实性和呈现效果。对于基于图像的提示词,我们还会评估图像理解能力,衡量模型成功识别、提取视觉内容并对其进行推理的能力。
在这些维度上,我们的端侧模型展现出了显著的代际进步。在通用文本能力方面,更新后的 AFM 3 Core 模型较前代有所提升,在 45.6% 的提示词上获得偏好,而 2025 年基线模型仅为 23.3%(见 图 3)。这一进步同样延伸到了视觉输入;在图像理解方面,在用户偏好其中一方的情形下,超过 61% 的情况下用户更偏好 AFM 3 Core 而非上一代模型(见 图 4)。
我们的服务器端模型 AFM 3 Cloud 也较前代有了显著提升。在通用文本能力的成对人工评估中,它在 64.7% 的提示词上获得偏好,而 2025 年的 AFM Server 模型仅为 8.7%,这一代际飞跃在所有地区均保持一致。在单侧评估中(即从多个维度对回复独立打分),我们也看到了一致的提升:与 2025 年的 AFM Server 模型相比,AFM 3 Cloud 在整体回复满意度上实现了约 36% 的相对提升,在指令遵循表现上实现了 21% 的相对提升。此外,在图像理解方面(即模型对视觉输入进行解读和推理),AFM 3 Cloud 较去年前代有显著改进,在 37.8% 的提示词上获得偏好,而其 2025 年基线模型仅为 9.6%。
最后,AFM 3 Cloud Pro 相比我们的 AFM 3 Cloud 带来了进一步提升,在整体回复满意度上实现了约 10%(文本)和 14%(图像理解)的相对提升。AFM 3 Cloud Pro 在数学等特定任务类别中表现出色,相比 AFM 3 Cloud 实现了 14% 的相对提升。
文本能力的人工评估
图 3:在通用文本能力的并排人工评估中,AFM 3 Core 和 AFM 3 Cloud 对比我们上一代模型时获得偏好的回复比例。结果按四个不同的地区组呈现,以展示其在各国际版本中的一致表现。“English”1 代表我们的全球英语评估集,而“PFIGSCJK”2、“DDNSTV”3 和“AFIHHMPRTU”4 代表我们其余支持的全球地区。
图像理解的人工评估
针对特定功能的评估
除了模型层面的评估之外,我们还评估了由基础模型驱动的所有功能。下面我们重点展示其中几项结果。
为了衡量全新富表现力语音的质量,人类评估员使用 5 分制平均主观评分(MOS)量表,将 AFM 3 Core Advanced 与 Apple 现有的生产级文本转语音(TTS)系统进行了对比评分(见 表 1)。在 1B 参数激活规模的高效配置下,AFM 3 Core Advanced 获得了 4.15 的总分——相比当前生产基线提升了 0.28,表现强劲,尤其考虑到 MOS 量表上 0.1 的提升即代表客户体验中非常明显的改善(见音频 1)。在会话类文本上,这一质量差距进一步拉大,例如朗读文本时常用的口语化语言。在这些会话场景中,AFM 3 Core Advanced 得分为 4.24,而生产系统为 3.82,0.42 的差值甚至更大,表明其带来了明显更自然、更具表现力的音频体验。
| 指标 | 当前 TTS | AFM 3 Core Advanced | ||
|---|---|---|---|---|
通用语音 | 3.87 | 4.15 | ||
| 会话语音 | 3.82 | 4.24 |
表 1:文本转语音(TTS)生成的人类评估结果,按 5 分制平均意见得分(MOS)评分。结果对比了 AFM 3 Core Advanced 与 Apple 现有的生产级 TTS 系统。每个类别中的最高分以粗体标示。
当前 TTS | AFM 3 Core Advanced | ||
|---|---|---|---|
音频 1:会话式文本转语音生成的并排对比。上排展示了一个涉及三人讨论读书会的多人群聊通知。下排展示了一组对话式的步行导航指令:“继续直走,你不会错过的。你会看到左边有一排商店,包括一家带着鲜红色遮阳篷的鞋店。看到了吗?这就是我们快到了的提示。”在两个示例中,左列展示的是当前的生产基线,右列展示的是 AFM 3 Core Advanced 更自然、更富表现力的韵律。
作为对这些文本转语音改进的补充,AFM 3 Core Advanced 在语音转文本能力方面也展现出显著进展(见图 5)。针对听写等特定的下游功能,我们沿七个维度收集了与上一代听写系统的并排偏好评判:整体质量、标点、大小写、排版、语义捕捉、不流畅处理和风格。在 10 亿参数的激活规模下,AFM 3 Core Advanced 在整体质量上以 44.7% 对 17.6% 的差距获得偏好,且这种偏好一致地延续到其余六个维度中的每一个。
音频人工评估
负责任的 AI
我们最新的 Apple Foundation Models 在每一步设计中都秉承我们的核心价值观,并建立在业界领先的隐私保护基础之上。此外,在开发和推进 Apple Intelligence 与 Apple Foundation Models 的每个阶段,我们都以负责任的 AI 原则来指导我们的功能与模型:
- 用智能工具赋能用户:我们确定可以负责任地运用 AI 来打造工具、满足特定用户需求的领域。我们尊重用户选择使用这些工具来实现其目标的方式。
- 代表我们的用户:我们构建深度个性化的产品,目标是真实地代表全球各地的用户。我们持续努力,避免在 AI 工具和模型中延续刻板印象和系统性偏见。
- 精心设计:我们在整个流程中——包括设计、模型训练、功能开发和质量评估——采取预防措施,识别我们的 AI 工具可能被滥用或造成潜在伤害的方式。我们将借助用户反馈持续监控并主动改进我们的 AI 工具。
- 保护隐私:我们通过强大的设备端处理能力和 Private Cloud Compute 等开创性基础设施来保护用户隐私。在训练我们的基础模型时,我们不使用用户的私人个人数据或用户交互数据。
我们的安全分类体系帮助识别需要谨慎处理的敏感内容。为确保我们的模型在不同语言和文化语境中都尊重这些边界,我们开展多语言后训练对齐,使用针对特定语言的防护栏模型,并由覆盖所有受支持地区的母语使用者开展经过精细化的人工红队测试。我们持续致力于提升模型与负责任 AI 方法的对齐程度,我们的最新模型已展现出显著进展。
结论
我们的第三代 Apple Foundation Models 代表了一次重大飞跃,为全新的 Apple Intelligence 体验提供支撑,让我们的操作系统对用户更加有用。其中包括全新版本的 Siri、先进的照片编辑工具、Image Playground 的强大更新、极具表现力的语音等。为保护用户隐私,这些模型完全在设备端和 Private Cloud Compute 上运行。我们期待在今年夏天晚些时候的技术报告中分享关于最新基础模型的更多细节,包括更新后的评估和基准测试结果。
脚注
英语指各国的英语方言(例如美国、英国、澳大利亚、印度)。
PFIGSCJK 指葡萄牙语、法语、意大利语、德语、西班牙语、中文、日语和韩语。
- DDNSTV 指丹麦语、荷兰语、挪威语、瑞典语、土耳其语和越南语。
AFIHHMPRTU 指阿拉伯语、芬兰语、印尼语、希伯来语、印地语、马来语、波兰语、俄语、泰语和乌克兰语。
来源:Apple Machine Learning Research(RSS) · machinelearning.apple.com