Bun 被 Anthropic 收购后用 Rust 重写,月下载超 2200 万
重写《Rust 中的 Bun》
Bun 于 2025 年 12 月被 Anthropic 收购,作者使用预发布版 Claude Fable 5 进行了大量 Rust 重写。Bun 最初用 Zig 在一年内构建,如今 CLI 月下载超 2200 万,被 Claude Code 等采用。广泛功能带来稳定性挑战,v1.3.14 修复了多项 use-after-free、内存泄漏等 bug。团队通过 ASAN、Fuzzilli 模糊测试等系统性预防,并借助 Rust 的内存安全特性减少此类缺陷。
Bun 创始人把 54 万行 Zig 用 Claude 11 天重写为 Rust,对抗式审查和动态工作流的细节是近期最值得看的 AI 辅助工程实战复盘,做基础设施的可以认真读。
披露:Bun 已于 2025 年 12 月被 Anthropic 收购。我和 Bun 团队的其他成员都在 Anthropic 工作。在这次 Rust 重写的大部分过程中,我使用的是预发布版本的 Claude Fable 5。
Bun 最初是将 esbuild 的 JavaScript 与 TypeScript 转译器从 Go 逐行移植到 Zig。我在 2021 年 4 月 16 日写下了我的第一行 Zig 代码。我在 Hacker News 上看到那篇单页的 Zig 语言参考后,对它的底层控制能力和对性能的极致追求感到非常兴奋,于是决定押注 Zig。
从一开始,Bun 的覆盖范围就极为庞大:
- JavaScript、TypeScript 和 CSS 的转译器、压缩器和打包器
- 兼容 npm 的包管理器
- 类 Jest 的测试运行器
- 兼容 Node.js 与 TypeScript 的模块解析
- HTTP/1.1 与 WebSocket 客户端
- Node.js API 实现,例如
fs、net、tls,以及数十个其他模块
Bun 的初始版本是我在一年内写出来的,当时身处奥克兰一间狭小的公寓里,那还是在 LLM 出现之前,用的是 Zig。像 Bun 这样雄心勃勃的项目,默认的结局往往是沦为 GitHub 个人主页上又一个死掉的副项目。是 Zig 让 Bun 成为可能。如果不是因为 Zig,我绝不可能在一年内构建出这么多东西。
如今,Bun 的 CLI 每月下载量超过 2200 万次。Claude Code 和 OpenCode 等热门工具都选择 Bun 作为其运行时。Vercel、Railway、DigitalOcean 等更多平台都为 Bun 提供了一方支持。
Bun 的庞大范围也给稳定性带来了挑战。以下是我们在 Bun v1.3.14 中修复的一小部分 bug 示例:
- 在
node:zlib中,当对 zlib、Brotli 或 Zstd 流调用.reset(),而线程池上仍有异步.write()正在进行时,出现堆释放后使用崩溃 - 在
node:zlib中,当onerror回调对原生句柄发起重入式write(),随后又调用close()时,出现释放后使用崩溃 - 在
node:http2中,当重入式 JS 回调(例如 timeout 监听器内部的session.request()、options getter 或 write 回调)触发 hashmap rehash,导致内部流指针失效时,出现释放后使用崩溃 - 在
UDPSocket.send()和sendMany()中出现释放后使用,其中valueOf()或toString()回调中的用户代码可能在载荷捕获与实际发送之间分离ArrayBuffer - 崩溃和越界读取,发生在
Buffer#copy以及Buffer#fill当valueOf回调分离或调整底层ArrayBuffer在参数强制转换期间 UDPSocket.sendMany()中存在堆越界写入,当 socket 的连接状态在迭代过程中通过用户 JS 回调发生变化时触发crypto.scrypt中存在内存泄漏,当输出缓冲区分配失败时,回调和受保护的密码/盐缓冲区从未被释放SSLWrapper.init在错误路径上泄露了 strdup 后的口令短语- 内存泄漏发生在
tlsSocket.setSession()每次调用都会泄漏一个SSL_SESSION(每次调用约 6.5 KB),原因是缺少SSL_SESSION_free在之后d2i_SSL_SESSION - 内存泄漏,其中
fs.watch()watcher 在以下情况后从未被垃圾回收.close(),由引用计数下溢导致,使每个 watcher 被永久固定为 GC 根 - 当
background-clip带有厂商前缀和多层背景时,CSS 解析器中出现双重释放崩溃 DuplexUpgradeContext从未被释放——每次tls.connect({ socket: duplex })都会造成完整泄漏- 竞态条件崩溃发生在
MessageEvent其中 GC 标记线程可能观察到撕裂的变体,位于m_data在来自以下对象的并发访问期间BroadcastChannel或MessagePort
我们本可以永远这样逐个修补这类 bug,但我们对依赖我们的用户负有责任,应当做得更好,系统性地防止这类 bug 再次发生。
我们已经在做的事情
- 我们给 Zig 编译器打了补丁,添加了 Address Sanitizer 支持。我们在每次提交时都用 ASAN 运行测试套件。
- 我们在 Windows 上发布经过 Zig 安全检查的 ReleaseSafe 构建
- 我们使用 Fuzzilli 对 Bun 的运行时 API 进行 7×24 小时模糊测试,这是 V8 和 JavaScriptCore 所使用的 JavaScript 引擎模糊测试工具
- 我们有大量端到端内存泄漏测试
这已经比许多项目做得更多了。
只要足够聪明、不犯错误就行了?
我们的 bug 修复清单让人感觉糟糕,我也厌倦了带着对 Bun 崩溃的担忧入睡。我不为此怪罪 Zig——Zig 的其他用户没有遇到我们遇到的这些 bug,而将 GC 与手动管理内存混合使用,对软件来说是一种足够罕见的需求,以至于没有语言真正为此做过设计。如果没有 Zig,我们走不到今天,我会永远心怀感激。直到不久之前,对于像 Bun 这样的项目来说,编程语言的选择还是一个单向决定。
JavaScript 是一门带垃圾回收的语言,而像 JavaScriptCore(以及 V8)这样的现代 JavaScript 引擎,在异常处理和垃圾回收器方面有着严格的规则。Zig 和 C 一样,不会替你管理内存,这是一种权衡,而对许多项目来说,这正是使用 Zig 的一个绝佳理由。Zig 没有构造函数/析构函数,大多数清理工作都应当在每个调用点用 defer 显式写出。
对于 Bun 来说,正确处理垃圾回收值和手动管理值的生命周期,一直是稳定性问题的主要来源——最常见的是小的内存泄漏,偶尔还会崩溃。每一次内存分配都必须被一丝不苟地审查。这些字节在哪里被释放?我们如何确保它只被释放一次?我们是否正确检查了 JavaScript 异常?这个垃圾回收指针是否对保守式栈扫描器可见?这是垃圾回收的内存,还是手动管理的内存?
对于稳定性问题,越早发现越好。模糊测试发生在代码合并之后。CI 发生在代码推送时。运行时安全检查与地址消毒器发生在代码运行时(希望是在开发阶段,早于 CI)。
减少这类问题的一个常见方法,是确保对于需要清理的代码,清理代码总是恰好运行一次。Zig 被设计成一门没有隐藏控制流的简单语言,因此它更倾向于使用显式的 defer 关键字在作用域结束时运行代码,而不是 C++ 隐式的 ~Destructor 或 Rust 隐式的 Drop。
| 语言 | 清理 |
|---|---|
| Zig | defer、errdefer |
| C++ | ~析构函数、&&移动 |
| Rust | Drop |
对于 Zig 代码,我们究竟应该在什么时候运行清理代码?如果我们将同一个 *T 传递给许多不同的函数,我们如何知道它何时不再可访问、可以被清理?当某些函数在调用结束后仍需要继续引用该内存时,这又该如何运作?我们目前的做法是以下几种方式的混合:
- arena 生命周期,即何时可访问的作用域是明确的(解析器状态不会逃逸出调用函数,因此 AST 节点在那里是个好选择)
- 引用计数
- 格外密切地关注
许多项目选择通过风格指南来回答这类问题。TigerBeetle 的 TigerStyle 是 Zig 中的一个例子,Google 长达 31,000 词的 C++ 风格指南 则是另一个。风格指南的挑战在于执行。你如何确保风格指南得到遵守?历史上,代码审查是答案,并通过 linter 和静态分析器进行尽力而为的执行。
对于 Bun 来说,采用一份严格的风格指南,并在类型系统中明确写出清晰的所有权预期,本是一个切实可行的选项。由于 Zig 不支持运算符重载,我们最终很可能会写出大量类似这样的代码:
fnfoo(a_ptr: SharedPtr(TCPSocket)) !void {
const a: *TCPSocket = a_ptr.get();
defer a_ptr.deref();

const b = trydo_something_with_a(a);
defer b.deref();

// ...
}
这比我们期望的 Zig 写法更不顺手:
fnfoo(a: *TCPSocket) !void {
const b = trydo_something_with_a(a);
// ...
}
那 C/C++ 呢?
Bun 大约 20% 的代码是用 C++ 编写的,并且 Bun 内嵌了多个 C/C++ 库:
- JavaScriptCore,即驱动 Safari 的 JavaScript 引擎
- uWebSockets 与 usockets——我们的 HTTP/WebSocket 服务器,以及事件循环
- lshpack 与 lsquic——
HPACK和 HTTP/3 库 - BoringSSL,Google 的 OpenSSL 分支
- SQLite
对 Bun 来说,用 C++ 而非 Zig 会是一个合理的选择。我们能获得构造函数与析构函数。我们可以删掉大量 extern "C" 包装代码。
但是,我们仍将依赖通过代码审查来执行的风格指南,而且即便有 ASAN,内存损坏和内存泄漏仍会发生。
为什么选 Rust?
那个列表中的很大一部分 bug 是 use-after-free、double-free,以及错误处理路径中的“忘记释放”。在安全的 Rust 中,这些都是编译器错误,并且通过 Drop 实现类似 RAII 的自动清理。编译器错误是比风格指南更好的反馈回路。
从历史上看,重写是个糟糕的主意。不计注释,Bun 有 535,496 行 Zig 代码。用另一种语言重写需要一个小型工程师团队花费整整一年。这意味着在那段时间里要冻结 bug 修复、安全修复或功能开发。要让某些东西达到可发布状态,风险最低的方法是从 Zig 到 Rust 进行机械式移植,尽可能减少行为变更,并使用我们已经用于测试 Bun 的完全相同的测试套件。
幸运的是,Bun 自己的测试套件是用 TypeScript 编写的,这意味着它不依赖于运行时的编程语言。
一年对用户毫无影响不是一个我们可以考虑的现实选项。因此,通过代码风格来强制执行以修复稳定性问题是我们最好的选择,这也是我们在向 Bun 代码库添加受 Rust 启发的 智能指针 时的计划。
但说实话,我并不想这么做。自研的智能指针比 Rust 的人机工效更差,而且没有任何保证。
如果换个思路,我花一周时间测试 Anthropic 的新模型能否用 Rust 重写 Bun 呢?
起初,我并不指望它能成功。几天之后,测试套件中已有很高比例开始通过,我也看到新的 Rust 代码与原本的 Zig 代码库匹配到了什么程度。我的看法从“这值得一试”变成了“我要把它合并进去”。
Claude,用 Rust 重写 Bun。
做这件事有很多种搞砸的方式。比如,给 Claude 一个提示词“用 Rust 重写 Bun。不要犯任何错误。”然后祈祷它能成功,这并不是我的做法。
想一想一个人会怎么做这件事。第一个大问题是:
增量重写?还是一次性全部重写?
根据我把 esbuild 的转译器从 Go 移植到 Zig、用于 Bun 最初版本的经验(当时没有用 LLM),一次性全部重写更好。增量重写会引入一些你希望最终能被删掉的临时代码,而且在短中期内会很痛苦。
第二个大问题:怎么做?
我们如何让用 Rust 写的 Bun 仍然是和以前一样的 Bun,拥有相同的架构、性能和功能集,同时又能获得 Rust 的语言特性,比如借用检查器?我们如何确保团队在重写之后仍然能够维护它?
做那种看起来像是我们把 Zig 代码转译成 Rust 的重写。等 Bun v1.4 发布后,我们可以逐步重构它,减少 unsafe 的使用,让它看起来更像地道的 Rust。
这就是仅有的两个大问题。其余的都是战术层面的。
编写与审查代码的循环
作为软件工程师,很多日常工程工作都可以被过度简化为循环。
// Pseudocode, not real code:
let task;
while ((task = todoList.pop())) {
const result =task();
const feedback =awaitPromise.all([review(result), review(result)]);
awaitapply(feedback, result);
}
一个 task 会关联一些上下文(一个 Jira 工单、一个 GitHub issue 等)。result 就是你为修复它而编写的代码。代码审查者 review 这些改动,以检查回归和正确性。然后你再处理反馈。
我使用 Claude Code 中大约 50 个动态工作流,在 11 天里持续运行,用 Rust 重写了 Bun。
每个动态工作流都是这样一个循环——一个用于以下事项的工作流:
- 生成一份移植指南,将 Zig 的模式和类型映射到 Rust 的模式和类型
- 机械地将每个
.zig文件移植为.rs文件,与 PORTING.md 和 LIFETIMES.tsv 保持一致 - 修复每个 crate 的编译器错误
- 让
bun test或bun build这样的子命令能够正常工作 - 让 Bun 整个测试套件中的每一个测试都通过
- 若干次大规模重构和清理
在那 11 天的大部分时间里(以及之后),我都在监控工作流——手动阅读输出以检查问题和 bug,并提示 Claude 修改循环来修复问题。
你如何审查一个新增了超过 100 万行的 PR?你如何开始建立必要的信心,以负责任地合并大量由 LLM 编写的代码?
一个与语言无关、包含上百万条断言的测试套件,对抗式代码审查,以及当真的出问题时,修复生成代码的流程,而不是手动修复代码。
对抗式审查
对抗式审查要求 Claude(在另一个独立的上下文窗口中)穷尽式地列出这些改动会导致 bug 或无法工作的理由。
拆分上下文窗口
在人类的情况下,审查代码的人通常不是编写代码的人。编写代码的人希望合并代码,这可能会使他们的行为产生偏差,在代码还没准备好之前就急于发布。
Claude 也是如此。写代码的 Claude 希望代码被接受。做审查的 Claude 则想找出代码中的问题。
1 个实现者,每个实现者配 2 个或更多对抗性审查者。审查者唯一的职责:找出 bug 以及代码无法工作的原因。实现者不做审查。审查者不做实现。
✻ claude code · 动态工作流
对抗性审查
对抗性审查在合并前捕获的众多 bug 中的 3 个
bug 1 / 3 · 异步关闭
✻
claude
实现者
它的上下文:.zig 原版、移植计划、它自己的推理
✻
claude
对抗性审查者
它的上下文:只有 diff。被要求假定代码是错的。
✻
src/runtime/api/bun/js_bun_spawn_bindings.rs
· 编译通过
for
stdio
in
[spawned_stdout, spawned_stderr] {
match
stdio {
StdioResult
::
Buffer
(
mut
pipe)
=>
{
// pipe: Box<uv::Pipe> — 交给 libuv 关闭
pipe
.
close
(
Subprocess
::
on_pipe_close)
}
StdioResult
::
Fd
(fd)
=>
fd
.
close
(),
StdioResult
::
Unavailable
=>
{}
}
}
✻
uv_close 是异步的:libuv 会保留原始句柄指针直到下一个事件循环 tick,然后调用 on_pipe_close,由它释放该内存分配。但 `pipe` 是一个 Box,在这个 match 分支结束时就被 drop 了——libuv 于是持有了已释放的内存,随后关闭回调又将其释放了第二次。先是 use-after-free,然后是 double-free。
✻
Box
::
leak
(pipe)
.
close
(
Subprocess
::
on_pipe_close)
f0a454376c7 · win-review: js_bun_spawn_bindings.rs 在异步 uv_close 之前泄漏 Box<uv::Pipe>,以避免 on_pipe_close 中的 UAF/double-free
✻
src/runtime/node/node_fs.rs
· 编译无警告
// 将 f64 秒拆分为 timespec 风格的 {sec, nsec}
let
sec
=
t
.
trunc
();
TimeLike
{
sec
:
sec
as
i64
,
nsec
:
((t
-
sec)
*
1e9)
as
i64
,
}
✻
对于负数、非整数的时间——即 1970 年之前的文件 mtime——trunc 会向零取整:-1.5 变成 {sec: -1, nsec: -500_000_000}。负的 nsec 是无效的 timespec。floor 则让 nsec 保持在 [0, 1e9) 范围内:{sec: -2, nsec: 500_000_000}。
✻
let
sec
=
t
.
floor
();
nsec
:
((t
-
秒)
*
1e9)
。
round
()
as
i64
,
7cc88f00141 · 跨平台审查修复:… node_fs win to_sys_time_like floor(),使 nsec∈[0,1e9) 以处理负的 t …
✻
src/css/values/color.rs
· 编译通过
// color-mix() 的每一侧都可以省略其百分比;
// 缺失的一侧默认取另一侧的剩余部分
let
p1
=
first
。
percentage
。
unwrap_or
(
1.0
-
second
。
percentage
。
unwrap
());
✻
unwrap_or 会立即求值它的参数——即使 first.percentage 是 Some,second.percentage.unwrap() 也会执行。所以对于 color-mix(in srgb, red 40%, blue),其中只有第二个百分比被省略,程序会在参数表达式内部 panic,而 unwrap_or 根本来不及忽略它。unwrap_or_else 接受一个闭包,保持惰性求值。
✻
let
p1
=
first
.
percentage
.
unwrap_or_else
(
||
1.0
-
second
.
percentage
.
unwrap
());
90111846a14 · phase-b2:color.rs gated_full_impl 已完全消解(验证:parse_color_mix 的 unwrap_or 会急切 panic,Default CurrentColor 与 transparent 不一致)
对抗性审查者实际抓到的三个 bug——每个被引用的提交都在其主题行中带有对应的审查归属信息。三个都能编译通过;三个看起来都合情合理。审查者是另一个处于独立上下文窗口中的 Claude:它只拿到 diff,别的什么都没有——没有实现者的任何推理过程——并被要求找出它错在哪里。代码是从被引用的提交中精简出来的;同样的 bug,同样的修复。
这看起来是什么样的?
如果你即将做一件规模庞大且代价高昂的事,先降低它的风险既省时又省钱。
准备工作
在写任何代码之前,我花了大约 3 个小时和 Claude 讨论如何把我们的 Zig 代码库中的模式紧密地映射到 Rust。Claude 把这次讨论序列化成了一份PORTING.md文档,这份文档最终登上了Hacker News。
下一个问题:如何为手动管理内存的代码添加 Rust 生命周期?
于是我用类似这样的提示词问 Claude:
我:让我们启动一个动态工作流,来分析代码库中每个结构体字段的合理生命周期。这个工作流应当读取每一个文件中的每一个结构体字段,并追踪控制流。首先,找出那些在 Rust 中难以表达其生命周期的复杂结构体字段,然后为该字段提出一个生命周期,接着用 2 个对抗性审查智能体来审查该生命周期,然后应用所有反馈,并序列化到一个 LIFETIMES.tsv 中,供其他 claude 查看。
然后对 PORTING.md 和 LIFETIMES.tsv 一起进行一轮对抗性审查,以修正任何相互冲突的建议,并复核所有内容。我也会亲自通读一遍。
试运行
在让 Claude 把全部 1,448 个 .zig 文件翻译成 .rs 文件之前,我先从 3 个开始。对于这 3 个文件中的每一个,1 个实现者编写新的 .rs 文件,2 个对抗性审查者检查 .rs 文件是否与 .zig 文件的行为一致,以及它是否遵循了 PORTING.md 和 LIFETIMES.tsv。之后,1 个修复者应用所有建议。
起步失败
我让 Claude 对全部 1,448 个 .zig 文件循环执行这个工作流,大约 2 分钟后,一个 Claude 在提交前运行了 git stash。另一个运行了 git stash pop。接着又运行了 git reset HEAD --hard。它们互相干扰了!而如果我把每个 Claude 放进单独的工作树,磁盘空间就会不够,因为 Bun 的 git 仓库太大了,而且最终这些改动还需要一起编译并查看。
所以,我让 Claude 编辑工作流,指示 Claude 永远不要运行 git stash 或 git reset,也不要运行任何不一次性提交特定文件的 git 命令。也不要用 cargo。完全不要用慢命令。
然后,Claude 恢复了工作流。而且它真的跑起来了!但太慢了,所以我把它拆成只有 4 个工作流分片,每个分片有自己的 worktree(总共 4 个 worktree),每个分片运行 16 个 Claude 来提交和推送文件。
终于开始写代码了
得益于所有这些并行化和前期准备工作,Claude 在峰值时大约每分钟写 1,300 行代码。每一行代码都由两个独立的对抗性审查者(也是 Claude)审查,并在提交前经过一轮修复。但这些东西全都还跑不起来。
11 天 × 24 小时 · 太平洋夏令时
6,502 次提交
1
每小时 695 次提交
移植分支上的每一次提交(不含合并),按小时分桶统计。峰值小时:695 次提交。
注意到时间分布不均匀了吗?我忘了提高这台 EC2 实例上运行的默认 IOPS。仅仅一个慢速的 grep 命令,就足以让磁盘读写冻结好几分钟。
把编译器错误当作工作队列
写完所有代码后,我让 Claude 写一个工作流来修复每一个编译器错误。我们逐个 crate 地推进。
✻ claude code · 动态工作流
≈16,000
剩余错误
太平洋夏令时 5 月 6 日周三 12:40 AM
errors.txt
0 个修复提交
错误
:在字段访问前解引用 *mut EventLoop
错误
:js_parser/ast/E.rs:为 Number/BigInt/RegExp 移植 json_stringify
错误
:NodeHTTPResponse.rs:接通 JSNodeHTTPResponse 缓存访问器 vi
error[E0034]
:作用域中存在多个可用项
错误
:test_command.rs:将覆盖率 façade 接入 bun_sourcemap_jsc::code
错误
:bundler/ungate_support.rs:解除 bun_css shim 的门控,接入真正的 ::bun_cs
错误
:dns.rs:实现 pending_cache_for/get_key/get_or_put_into_reso
错误
:css/css_parser.rs:移植 DefineShorthand 契约、parse_bundler,
错误
:runtime/crypto/mod.rs:create_crypto_error 委托给 boringss
错误
:bun_core/fmt.rs:实现 format_ip 重借用(基于偏移的切片
错误
:event_loop/EventLoopTimer.rs:从 bun.zig 移植 Timespec::ns
分工拆解 · 64 个 claude
工作树 1
→
→
→
→
→
→
→
→
worktree 2
→
→
→
→
→
→
→
→
worktree 3
→
→
→
→
→
→
→
→
worktree 4
→
→
→
→
→
→
→
→
1 项修复
2 项审查
1 项应用
→ 提交按 crate 落地
bun_runtime
0
bun_bundler
0
bun_sql
0
bun_js_parser
0
bun_css
0
bun_http
0
bun_interchange
0
bun_sys
0
bun_core
0
bun_string
0
bun_logger
0
bun_uws_sys
0
bun_alloc
0
bun_collections
0
bun_ptr
0
bun_sourcemap
0
bun_safety
0
bun_glob
0
bun_dotenv
0
bun_router
0
bun_uws
0
bun_io
0
bun_ini
0
bun_lolhtml_sys
0
bun_test_runner
0
bun_cares_sys
0
bun_url
0
bun_picohttp
0
bun_clap
0
bun_boringssl
0
bun_watcher
0
bun_analytics
0
bun_libarchive
0
bun_paths
0
bun_aio
0
bun_options_types
0
bun_zlib
0
bun_crash_handler
0
bun_js_printer
0
bun_resolver
0
bun_http_jsc
0
bun_install
0
阶段 D 是如何运作的,从其 1,610 次真实提交回放(太平洋夏令时 5 月 6 日):cargo check 将约 16,000 个错误写入一个文件,按 crate 分组;工作流将它们分配给 64 个 Claude——16 个循环分布在 4 个 worktree 上,每个循环由一个 Claude 修复、两个审查、一个应用。每个芯片都是一批真实提交:它落在其实际的 crate 上,只有到那时计数器才会移动。错误行是真实的提交主题。
最棘手的一类错误是循环依赖。
我们的 Zig 代码库原本是一个编译单元(实际上相当于一个 crate)。我想把新的 Rust 代码库拆分成约 100 个 crate,这样 Rust 的编译速度会更快,但这需要避免循环依赖,同时尽量减少与原始 Zig 实现相比的改动。我的 PR 在开始 Rust 重写之前立即做这件事,但效果不够。与其从头再来,我运行了另一个工作流来分类存在循环依赖的代码应该归到哪里,并把它全部记录下来——然后又运行了另一个工作流来执行重构。
修复循环依赖后暴露出大约 16,000 个编译器错误。对一个人来说这是天文数字,但对 64 个 claude 同时工作来说并不算离谱。
为了最大化并行度,工作流对每个 crate 进行循环处理。
- 对每个 crate,运行
cargo check,按文件对输出进行分组,并将错误保存到文件中 - 修复该 crate 内的所有编译器错误
- 2 个对抗性审查者审查该 crate 的改动
- 1 个修复者应用修复
为了防止各个 claude 互相干扰,cargo check 只在最开始运行,并且与其他运行一样,直到最后才执行 git。
又一次失败的尝试
Claude 把“让所有 crate 都能编译通过”理解成了“把有编译错误的函数打桩”。Claude 还开始添加长得可疑的解释性注释来记录各种变通做法,于是我加了这条规则,让对抗性审查者予以拒绝:
如果你需要一整段注释来论证这个变通做法为什么没问题,那说明代码本身就是错的——去修代码。
改了一处提示词,几个小时后,这些情况就不再出现了。
冒烟测试
模型特别爱说“冒烟测试”
一旦 cargo check 通过,下一步就是让它编译并运行 bun --version。它出现了链接器错误。接着,它一启动就立刻 panic 了。
下一个目标是让它运行 bun test <file>。一旦这一步成功,我们就能开始跑测试了!又该上另一个工作流了,循环遍历 bun CLI 的各个子命令:
- 把每个失败的堆栈跟踪连同它的子命令一起保存到文件
- 对于按子命令分组的每个失败堆栈跟踪,让 1 个 Claude 来修复
- 2 个对抗性审查者
- 1 个修复者来应用这些建议
让测试套件在本地通过
这个工作流在测试文件上循环执行。
随机运行约 100 个测试文件,按代码库中的文件夹分片到 4 个 worktree 之一。对于每个失败的测试,将堆栈跟踪和错误保存到文件,1 个实现者提出修复方案,2 个对抗性审查者审查,然后 1 个修复者应用修复。
更多的失败尝试
我们的测试套件中有大量内存泄漏测试,以及少数可能需要超过一分钟的集成测试——例如:一个运行 next dev 并检查热模块重载能否捕获变更 100 次的测试。其中几个测试在 debug 构建中会超时。
我们还有耗尽机器上最大 TCP socket 数量的压力测试、读写数 GB 磁盘数据的测试,以及生成约 1 万个进程的测试。
这需要比"拜托了"更强的隔离,所以我们使用了 systemd-run(cgroups)来限制内存和 CPU 使用,并隔离 pid 命名空间。机器还是多次耗尽磁盘空间并崩溃。
让测试套件在 CI 中通过
第一次 CI 运行两天后,失败列表从 972 个测试文件降到了 23 个。又过了一天半,Linux 完全变绿了——这是第一次,感觉这次 Rust 重写真的能成功。
✻ claude code · 动态工作流
buildkite · 竞速变绿,按平台
Windows 排名垫底 · 5 月 11 日,太平洋夏令时上午 6:23
6 / 6
平台已变绿
构建 #54202 · 5 月 14 日周四,太平洋夏令时上午 12:23
macOS x64
· 2 个分片
✓
Linux arm64
· 60 个分片
✓
Linux x64
· 60 个分片
✓
macOS arm64
· 4 个分片
✓
Windows x64
· 8 个分片
✓
Windows arm64
· 8 个分片
✓
✓ 全部 6 个平台通过 · 构建 #54202 → 已合并
每一次 CI 构建的测试分片,按平台划分,涵盖 135 次运行了测试的构建(从 BuildKite 中挖掘出 420 次)。亮绿色:每个分片都通过。暗绿色:没有失败,但运行被提前中断(被取代)。红色:至少有一个分片失败。每条泳道在其完整测试套件首次通过时被打上标记——Linux 的 60 个分片比 Windows 早了将近整整一天变绿。各平台一直反复出现红色,直到最后失败的测试全部被解决;最终全绿的构建是 #54202。
在合并之前的其余时间里,事情都很顺利。一个工作流循环修复每个平台的 CI 测试失败,直到不再有测试失败。还有几个针对 Windows 相关清理的工作流,用于去重代码、减少 unsafe 的使用,以及总体上清理一些代码。
合并 Rust 重写
一旦 Bun 的测试套件在所有平台的 CI 中 100% 通过(并且我手动验证了测试确实在运行、没有被跳过),我就在本地运行了一堆命令来测试各项功能——然后我按下了合并按钮。
合并进 main 并不是一个带版本号的发布。此时,我已经有足够的信心继续推进并投入到重写中,但还没有足够的信心将其发布。
统计
在高峰期,我们同时运行 4 个这样的工作流,每个都在单独的 worktree 中,每个工作流有 16 个 Claude。大约同时有 64 个 Claude。
git log · claude/phase-a-port
峰值:一分钟内 58 次提交
0
次提交
+0
行写入,包含重写
太平洋夏令时 5 月 4 日周一上午 7:05
全部 6,502 次提交(不含合并)已回放。
粉色
柱状条主要是新代码;
青色
柱状条主要是删除。行计数器统计了沿途的每一次重写——最终落地的 diff 是 +1,009,272。日志是真实的提交信息。
0 个测试被跳过或删除
11 天(5 月 3 日 → 5 月 14 日合并)· 6,778 次提交
| 平台 | expect() 调用 | 测试 | 文件 |
|---|---|---|---|
| Debian 13 x64 | 1,386,826 | 60,624 | 4,174 |
| macOS 14 arm64 | 1,259,953 | 58,850 | 4,175 |
| Windows 2019 x64 | 1,007,544 | 57,337 | 4,173 |
合并前,这消耗了 59 亿未缓存输入 token、6.9 亿输出 token,以及 720 亿缓存输入 token 读取——按 API 定价约合 16.5 万美元。如果手工来做,我认为这需要 3 名对代码库有完整上下文的工程师花费大约一年时间,而在这段时间里,我们将无法改进 Node.js 兼容性、修复 bug、修复安全问题或实现新功能。我们永远不会那样做。现实可行的替代方案是什么都不做,然后永远修复本文开头列出的那些 bug。
这是当今可能实现的最前沿水平。我使用了一个预发布版本的 Claude Fable 5,这是一个 Mythos 级模型。Claude Code 的动态工作流让 64 个 Claude 持续运行了 11 天(否则我就得自己编写一套运行框架才能做到这一点)。
工作仍在继续
自合并 Rust 移植版以来,我们已完成 11 轮来自 Claude Code Security 的安全审查,并处理了发现的问题。
我们还为 Bun 中的每一个解析器添加了 24/7 覆盖率引导的模糊测试——包括 JavaScript、TypeScript、JSX、CSS、JSON5、JSONC、TOML、YAML、Markdown、INI、Bun Shell 脚本、semver 范围、.patch 文件以及 CSS 颜色。模糊测试器会自动将它发现的 bug 发送给 Claude,由其提交一个复现并修复该 bug 的 PR,然后由人工审查这些 PR。到目前为止,它已执行我们的解析器 1000 亿次,由此产生了大约 15 个 PR。
在撰写本文时,Bun 的 Rust 代码中约有 4% 位于 unsafe 块内(约 27,000 行 / 约 780,000 行代码中约有 13,000 个 unsafe 关键字),而这些块中有 78% 只有一行——要么是一个来自 C++ 的指针,要么是一次对 C 库的调用。我预计这个数字会随着时间推移而下降,因为我们正在从一个忠实的 Zig 移植版本(其中没有可 grep 的 unsafe 关键字)重构为地道的 Rust,但我们会继续使用像 JavaScriptCore 这样的 C 和 C++ 库,所以它的 unsafe 永远会比纯 Rust 项目多。
移植错误
这次 Rust 重写的重点是稳定性,但发布如此大规模的改动却引入零回归是不可能的。
这次重写引入了 19 个已知回归,每一个都已修复。
大多数回归来自那些在两种语言中语法相同但语义不同的代码。
debug_assert! 内部的副作用
这两段代码看起来相似,但行为不同。Zig 的 assert 是一个函数,所以它的参数在每次构建时都会执行。Rust 的 debug_assert! 是一个宏,所以在 release 构建中整个表达式都会被消除,包括 insert_stale 调用。
// Zig:
if (dev.framework.react_fast_refresh) |rfr| {
assert(try dev.client_graph.insertStale(rfr.import_source, false) ==IncrementalGraph(.client).react_refresh_index);
}

// Rust:
if let Some(rfr) = &dev.framework.react_fast_refresh {
    debug_assert!(dev.client_graph.insert_stale(&rfr.import_source, false)? == react_refresh_index);
}
insert_stale 会将一个文件添加到前端开发服务器的热重载图中。在 release 构建中它停止运行,并且对于使用 React 的 HTML 路由项目,当某个热重载文件被失效时,HMR 在某些情况下会中断:Cannot destructure property 'isLikelyComponentType' of 'k'。Debug 构建则正常工作。#30678
奇数长度的切片
Bun 的 Zig 辅助函数 reinterpretSlice(u16, bytes)(早于支持切片的內建类型转换)使用了 @divTrunc,并忽略了一个末尾的奇数字节。bytemuck::cast_slice 则会对它触发 panic。Blob.text() 在遇到一个 UTF-16 字节顺序标记后跟奇数个字节时,不再返回字符串,而是让进程 panic。我们改回了忽略那个奇数字节的做法:&buf[..buf.len() & !1]。#31188
边界检查
在 macOS 和 Linux 上,我们用 ReleaseFast 编译 Bun 的 Zig 代码,这会移除边界检查。Rust 的 release 构建则保留它们。
Bun 的模块解析器会将长文件名驻留到一个全局列表中,该列表会溢出到溢出块中。原始的 Zig 代码将每个块的大小设为 count / 4,即 2048。移植版本留下了一个占位符:
/// ... so use a nonzero stand-in until Phase B threads the
/// per-instantiation value through.
pubconstBSS_OVERFLOW_BLOCK_SIZE:usize=64;
这使上限从 840 万个驻留文件名降低到 270,272 个,真实项目会触及这一上限,并使得我们从 Zig 移植过来的一个 ptrs[4095] 差一错误变得可触发。Rust 会 panic,而不是越界写入。如果我们使用 ReleaseSafe,Zig 在这种情况下也会 panic(我们只在 Windows 上这么做)。#31503
comptime 格式字符串
Output.pretty 会把 <r> 和 <d> 颜色标记重写为 ANSI 转义序列。在 Zig 中,fmt 就是 comptime,因此在参数被替换之前这些标记就已经消失了。Rust 函数没有 comptime 参数,所以 Output::pretty 只能看到最终生成的字符串,于是也会把标记重写到参数上。
// Zig:
pubinlinefnpretty(comptime fmt: string, args: anytype) void;
Output.pretty("<r>{f}<r>", .{hyperlink});

// Rust:
pubfnpretty(payload: impl PrettyFmtInput);
Output::pretty(format_args!("<r>{}<r>", hyperlink));
bun update -i将包名打印为OSC 8超链接,以ESC \终止。那个反斜杠正好位于<末尾的<r>之前,标记解析器会将其吞掉,而r会作为文本打印出来。
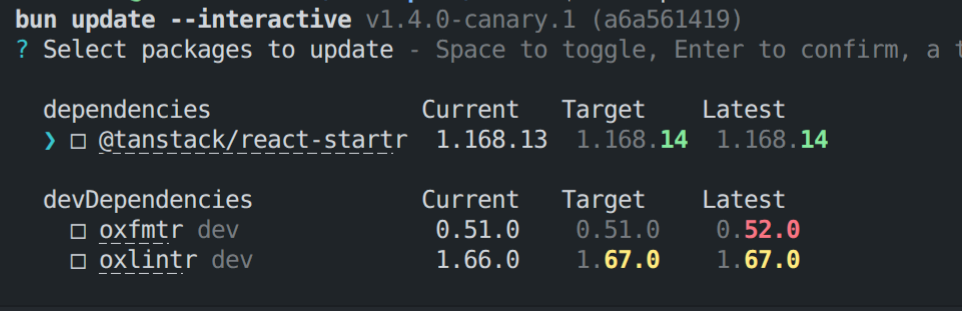
在 Rust 中它必须是一个宏:bun_core::pretty!("<r>{}<r>", hyperlink)。#30693
Bun 用 Rust 更好
到目前为止,Bun v1.4.0 修复了 128 个在 v1.3.14 中可复现的 bug。这些问题涵盖内存泄漏、崩溃以及帮助文本颜色错误等。
降低内存占用
Rust 拥有一种强大的语言级内存清理工具:Drop。当实现了 Drop 后,每次该值离开作用域时,drop 函数都会被自动调用。
implDropforBytes {
fndrop(&mutself) {
if!self.pinned.is_empty() {
JSC__JSValue__unpinArrayBuffer(self.pinned);
        }
    }
}
在 Zig 中,可以用 defer 在作用域结束时运行代码:
const bytes: ArrayBuffer = try .fromPinned(global, value);
defer bytes.unpin();
在 Zig 中,defer 需要添加到每一个可能需要清理的调用点。很容易最终忘记清理(内存泄漏),或者在很少触达的错误处理代码中运行两次清理代码(双重释放)。在 Rust 中,Drop 会在值不再可访问时自动运行——用“没有隐藏的控制流”换取了防止一个常见陷阱。
Drop 修复了 Bun 中若干与错误处理代码里的文件路径相关的内存泄漏。
我们修复了每一处可检测的内存泄漏
我们改进了 Bun 的 LeakSanitizer 集成,以追踪所有 原生代码内存分配。
举个例子:每一次进程内 Bun.build() 调用都会泄漏数 MB 内存——解析后的源文本和 AST 符号表的存活时间超过了它们所属的构建。
// Bundle the same 60-module project 2,000 times in one process
for (let i =0; i <2_000; i++) {
await Bun.build({
    entrypoints: ["./index.js"],
    minify:true,
    sourcemap:"external",
  });
}
在 Bun v1.3.14 中,每次构建都会永久泄漏约 3 MB——像 dev server 这样每次请求都进行打包的工具最终会耗尽内存。在 Bun v1.4.0 中,内存趋于平稳:
| 构建 | Bun v1.3.14 | Bun v1.4.0 |
|---|---|---|
| 500 | 1,914 MB | 526 MB |
| 1,000 | 3,506 MB | 586 MB |
| 1,500 | 5,097 MB | 608 MB |
| 2,000 | 6,745 MB | 609 MB |
此前一次用 Zig 做这件事的尝试没有被合并,因为缺少与 Drop 等价的机制,让人更难有信心去合并。
更小的二进制体积
Rust 重写中的初始改动让二进制体积在 Windows 上减少了 3.8 MB,在 macOS 上减少了 5.5 MB,在 Linux 上减少了 6.8 MB。这很大程度上是因为我们在 Zig 代码里用了太多 comptime。
— Bun (@bunjavascript) May 18, 2026
在最初的体积缩减之后,团队探索了更多通过链接器优化来减小二进制体积的机会,例如相同代码折叠(Identical Code Folding)、从 ICU 中移除未使用的数据,以及借助 zstd 字典按需惰性解压 libicu 的小部分内容。
结合 Rust 重写、ICU 改动以及相同代码折叠,Bun 的二进制体积在 Linux 和 Windows 上缩减了约 20%。
| 版本 | 平台 | 体积 |
|---|---|---|
| Bun v1.4.0(canary) | Windows | 76 MB |
| Bun v1.3.14 | Windows | 94 MB |
| Bun v1.4.0(canary) | Linux | 70 MB |
| Bun v1.3.14 | Linux | 88 MB |
减少栈空间占用
TOML 解析器,以及 Bun 中所有其他递归下降解析器(JSON、YAML、JavaScript、TypeScript 等),现在都使用更少的栈空间。
这在合并 Rust 重写之前导致了一些测试失败:
bun test v1.3.14-canary.1 (e99311e58)
.......

105| });
106|
107|it("Bun.TOML.parse throws on deeply nested inline tables instead of crashing", () => {
108|const depth =25_000;
109|const deepToml ="a = "+"{ b = ".repeat(depth) +"1"+" }".repeat(depth);
110|expect(() => Bun.TOML.parse(deepToml)).toThrow(RangeError);
^
error: expect(received).toThrow(expected)

Expected constructor: RangeError

Received functiondidnotthrow
Receivedvalue: {
  a: {
    b: {
      b: {
        b: {
          b: {
            b: {
              b: {
                b: {
                  b: [Object...],
                },
              },
            },
          },
        },
      },
    },
  },
}

at <anonymous> (/var/lib/buildkite-agent/build/test/js/bun/resolve/toml/toml.test.js:110:42)

✗ Bun.TOML.parse throws on deeply nested inline tables instead of crashing [2907.64ms]
Rust 的 LLVM IR 代码生成会在栈变量不再使用时发出 LLVM 的 llvm.lifetime.start 和 llvm.lifetime.end intrinsic,这让 LLVM 能够复用栈空间槽位。这使得带有嵌套作用域的大型函数能够显著减少栈空间占用。
此前,我们通过手动方式绕过了一个未解决的 issue具体做法是将特别庞大的函数重构为许多更小的函数。
快 2% - 5%
Rust 支持 C/C++ 与 Rust 之间的跨语言链接时优化,这使得跨编程语言的内联成为可能(这有多酷啊!!)。
我们在 Linux x64(EC2,Xeon Platinum 8488C)上对 Bun v1.3.14 与 Bun v1.4.0 进行了基准测试。HTTP 吞吐量使用 oha 针对 hello-world 服务器进行测量,应用工作负载使用 hyperfine 进行测量。
HTTP 吞吐量(req/s,3 轮平均值)
| 服务器 | Bun v1.3.14 | Bun v1.4.0 | Δ |
|---|---|---|---|
| Bun.serve | 169.6k | 177.7k | +4.8% |
| node:http | 103.8k | 108.5k | +4.5% |
| Elysia | 158.9k | 163.3k | +2.8% |
| express | 64.5k | 66.6k | +3.2% |
| fastify | 91.5k | 95.9k | +4.8% |
应用 / CLI(hyperfine)
| 工作负载 | Bun v1.3.14 | Bun v1.4.0 | Δ |
|---|---|---|---|
| next build | 13.62 s | 13.03 s | +4.5% |
| vite build(tsc + vite) | 1.69 s | 1.65 s | +2.2% |
| tsc -b --force | 0.94 s | 0.89 秒 | +4.7% |
生产环境
Prisma 在 Bun 的 Rust 重写版上推出了 Prisma Compute 公开测试版。
“我们遇到了内存泄漏,以及一个在虚拟机暂停并恢复后无法恢复的连接池。当 Rust 重写版出现时,我们针对相同的故障模式进行了测试。它完美地处理了这些问题。”——Alexey Orlenko
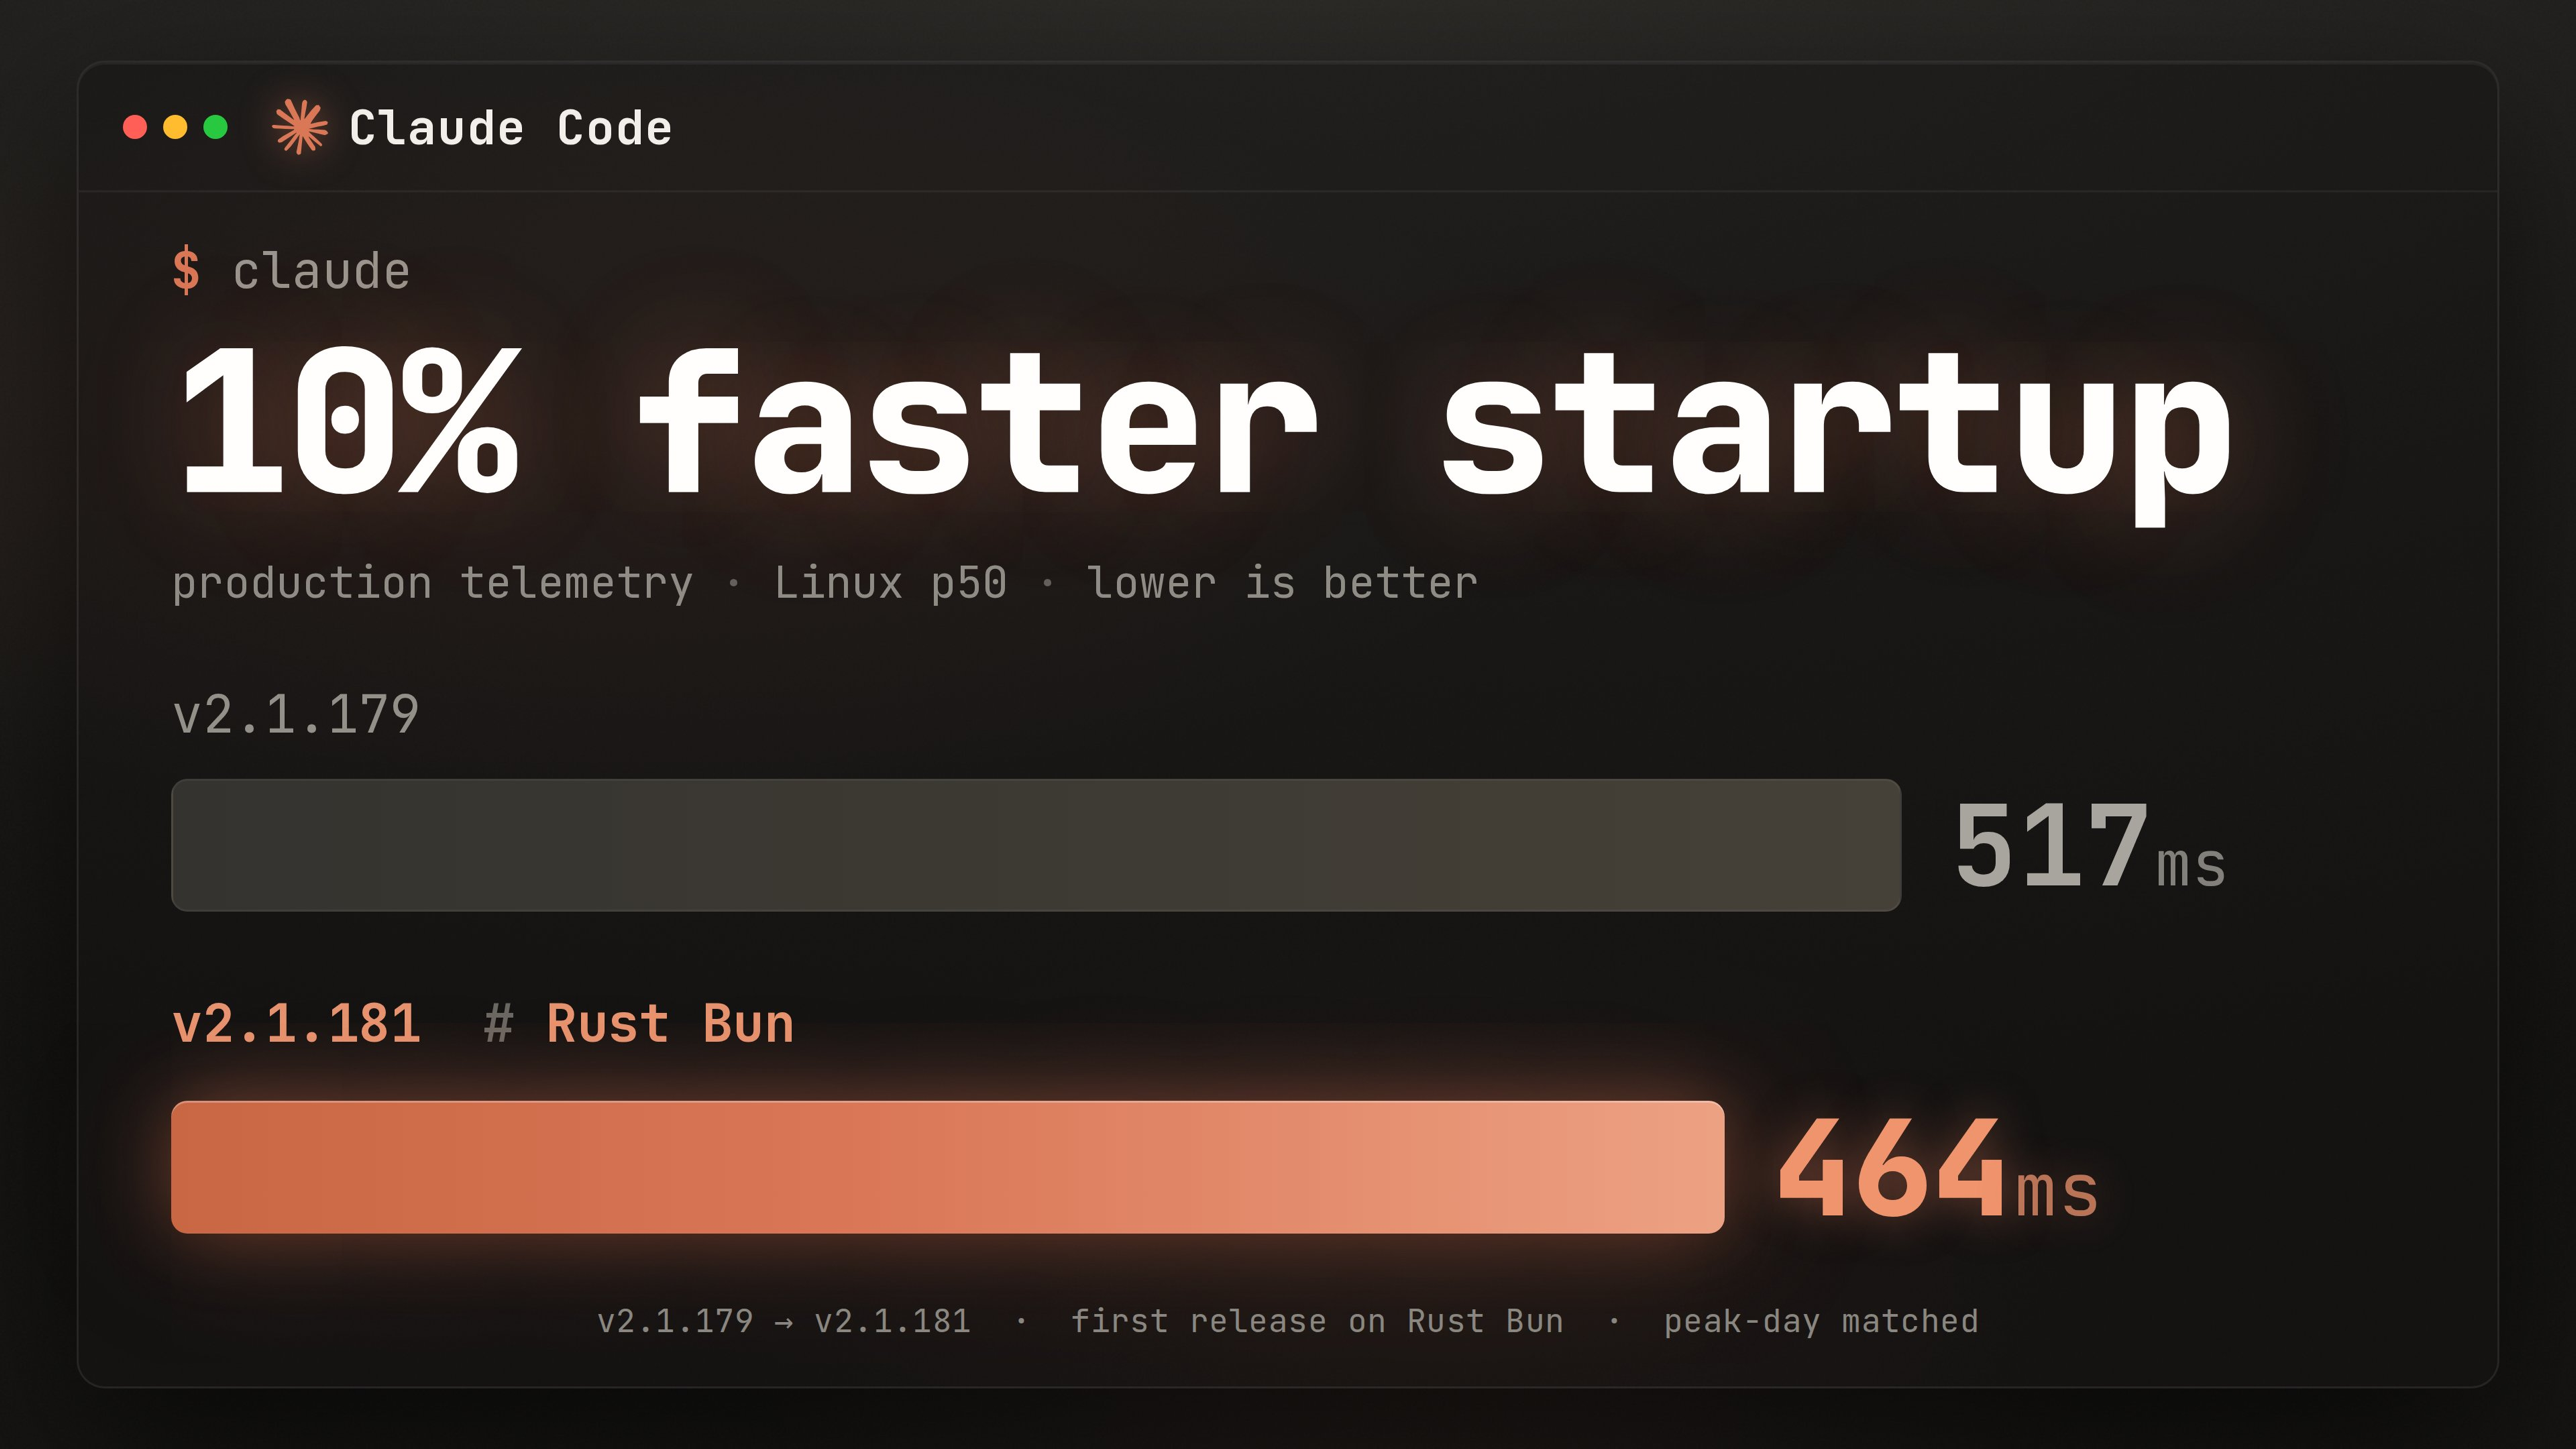
Claude Code v2.1.181(6 月 17 日发布)及之后的版本使用了 Bun 的 Rust 移植版。在 Linux 上启动速度提升了 10%,但除此之外,几乎没有人注意到。无聊是件好事。
发布
Bun v1.3.14 是 Bun 用 Zig 编写的最后一个版本。Bun v1.4.0 将是 Bun 用 Rust 编写的第一个版本。它现在已在 canary 中提供——请报告你发现的任何问题:
bun upgrade --canary可维护性
对我自己和团队来说,我们新的 Rust 代码库感觉与旧的 Zig 代码库非常相似。例如,下面是原始 Zig 代码和新 Rust 代码的一个片段:
pubfncanMergeSymbols(
    scope: *Scope,
    existing: Symbol.Kind,
    new: Symbol.Kind,
comptime is_typescript_enabled: bool,
) SymbolMergeResult {
if (existing == .unbound) {
return .replace_with_new;
    }

if (comptime is_typescript_enabled) {
// In TypeScript, imports are allowed to silently collide with symbols within
// the module. Presumably this is because the imports may be type-only:
//
//   import {Foo} from 'bar'
//   class Foo {}
//
if (existing == .import) {
return .replace_with_new;
        }

// ...
    }

// ...
}
pubfncan_merge_symbol_kinds<constIS_TYPESCRIPT_ENABLED:bool>(
    scope_kind:Kind,
    existing: symbol::Kind,
    new: symbol::Kind,
) ->SymbolMergeResult {

if existing == symbol::Kind::Unbound {
returnSymbolMergeResult::ReplaceWithNew;
    }

ifIS_TYPESCRIPT_ENABLED {
        // In TypeScript, imports are allowed to silently collide with symbols within
        // the module. Presumably this is because the imports may be type-only:
        //
        //   import {Foo} from 'bar'
        //   class Foo {}
        //
if existing == symbol::Kind::Import {
returnSymbolMergeResult::ReplaceWithNew;
        }

        // ...
    }

    // ...
}
任何理解原始 Zig 代码的人都能理解机械翻译后的 Rust 代码。我审查了最初的 Rust 重写 PR,方式是检查对抗性代码审查智能体是否正确捕捉到了 Zig 代码与 Rust 代码之间的差异,是否确保移植指南和生命周期指南得到了遵循,同时我自己也手动逐行对照 Zig 与 Rust 阅读了大量代码。
接下来是什么
Bun v1.4 让 Bun 更快、更小、占用内存更少,并为团队提供了极其强大的工具,以便今后系统性地提升稳定性:Rust 的借用检查器、Miri(在 CI 中运行的代码比例不断增加)、LeakSanitizer,以及针对解析器的 7×24 小时覆盖率引导模糊测试。还有更多内容需要重构,但开局非常出色。
这次 Rust 重写如果交给一支对代码库有完整上下文的工程师团队,需要一年的工作量。而由 1 名工程师使用 Fable 并密切监控 Claude Code,我们从零开始到在所有平台上 100% 通过测试套件,只用了 11 天。
如今一名工程师能做的事,比一年前多得多。
来源:Hacker News 热门(buzzing.cc 中文翻译) · bun.com