Hugging Face 详解 LLM.int8() 8 位量化在 transformers 中的集成与使用
A Gentle Introduction to 8-bit Matrix Multiplication for transformers at scale using transformers, accelerate and bitsandbytes
Hugging Face 与 bitsandbytes 合作,将 LLM.int8() 8 位矩阵乘法完整集成到 transformers 和 accelerate 库,使 BLOOM-176B 等大模型推理显存占用减半且无性能下降。
文章由集成团队亲自讲解 LLM.int8() 的原理、异常值处理和 transformers 集成细节,并附基准数据与代码示例。
引言
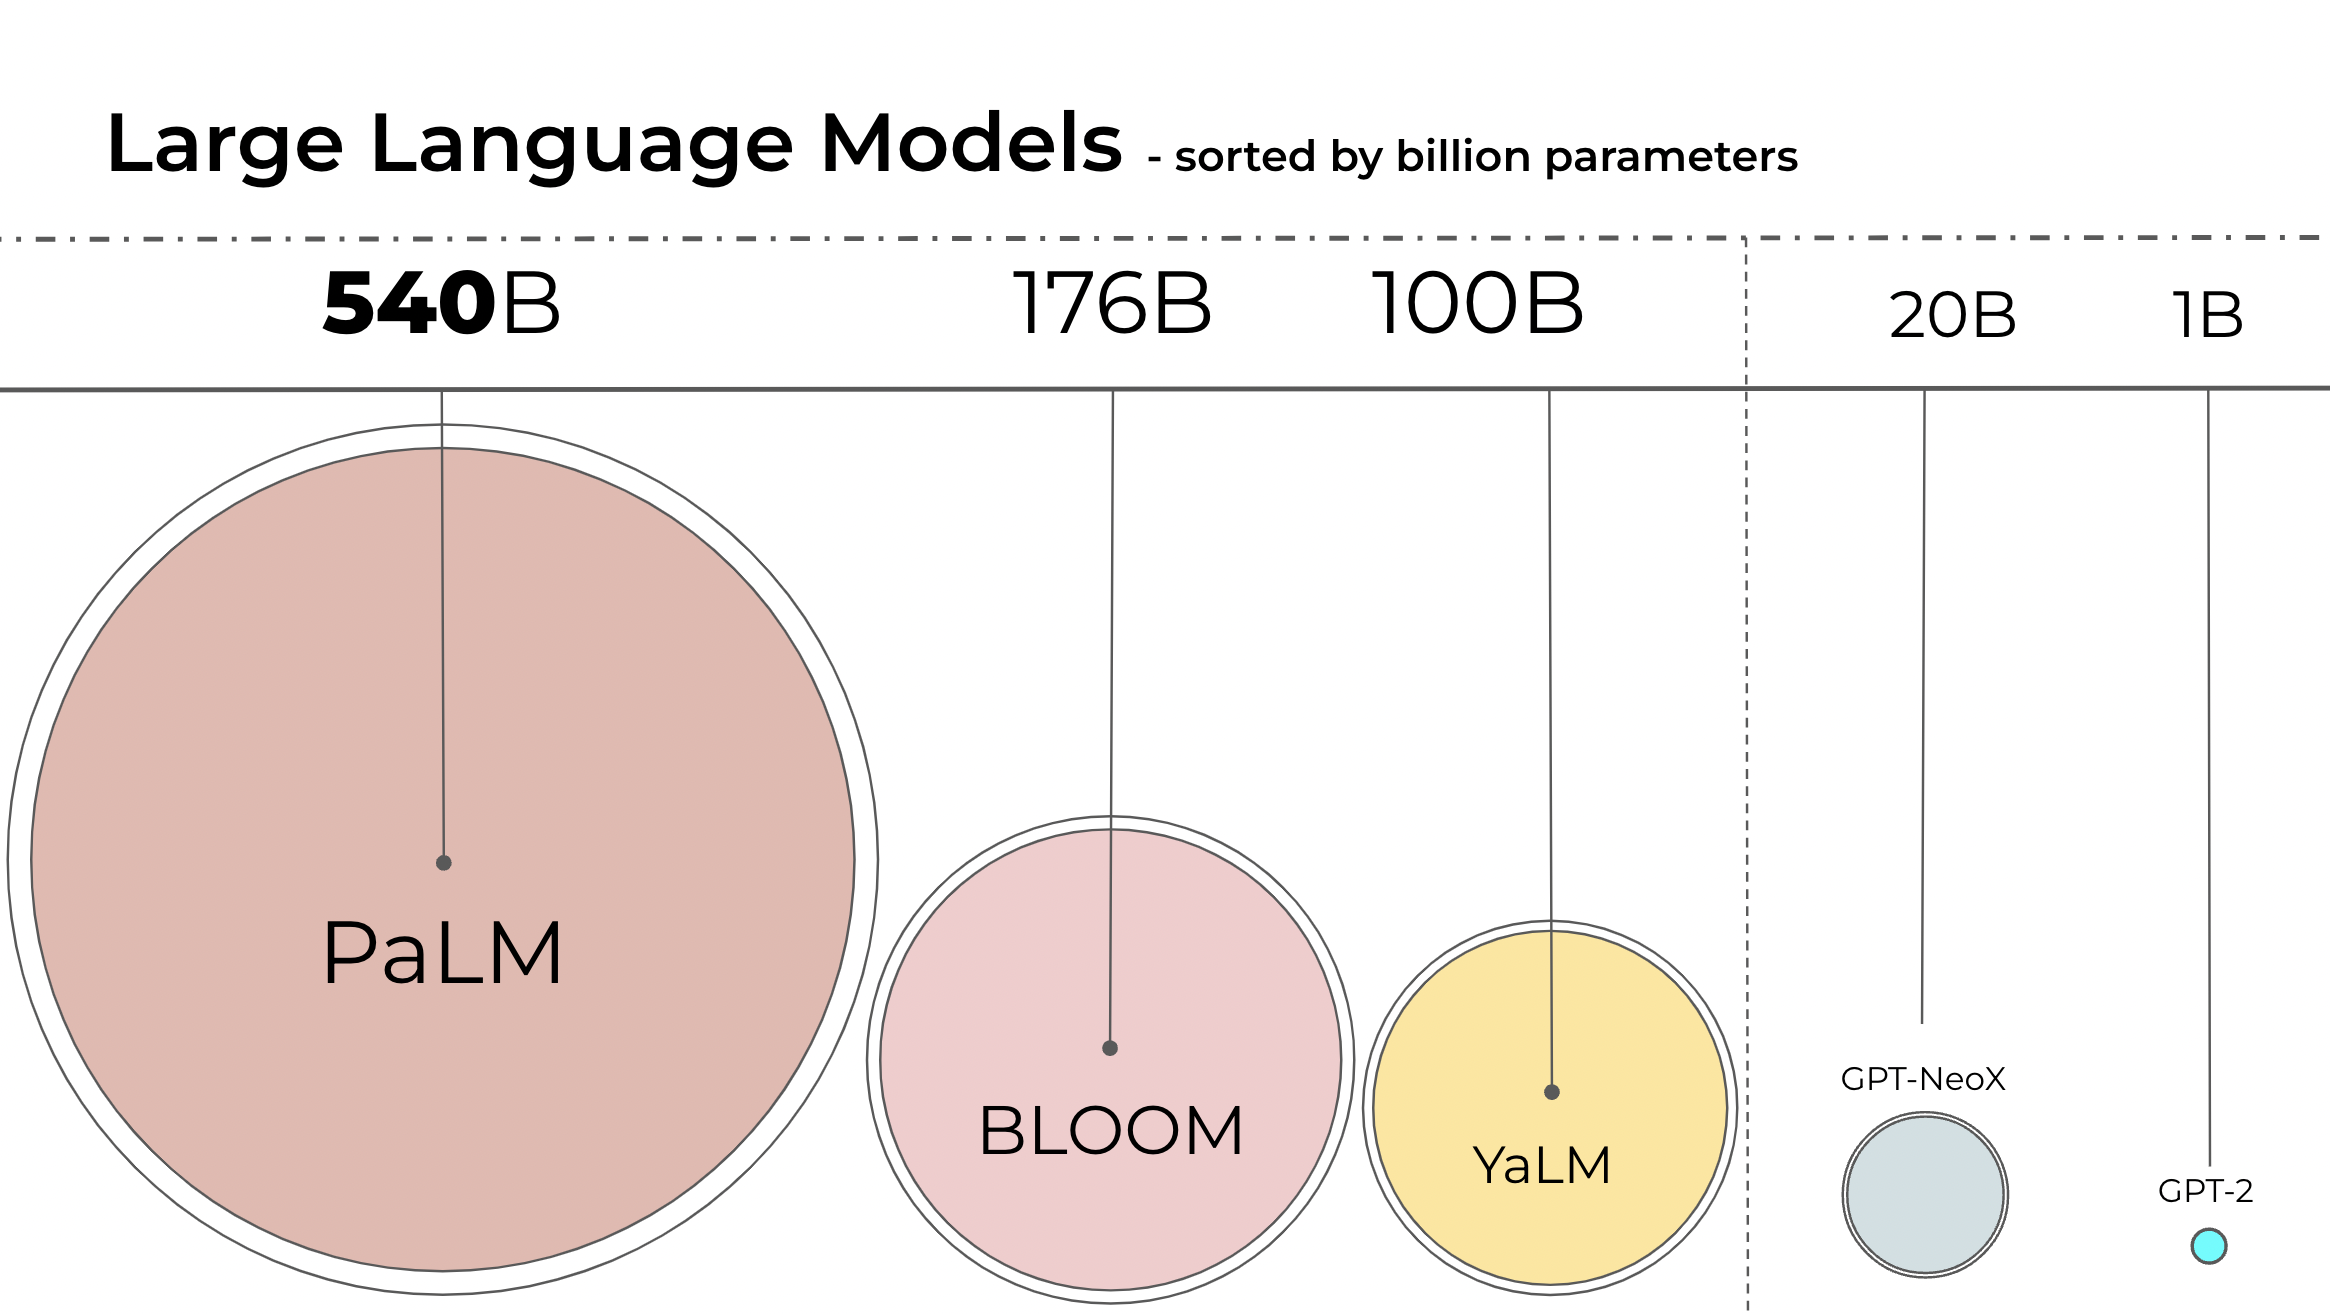
语言模型正变得越来越大。在撰写本文时,PaLM 拥有 5400 亿参数,OPT、GPT-3 和 BLOOM 大约有 1760 亿参数,并且我们正朝着更大模型的方向发展。下图展示了一些近期语言模型的规模。
因此,这些模型很难在容易获取的设备上运行。例如,仅对 BLOOM-176B 进行推理,就需要 8 块 80GB 的 A100 GPU(每块约 1.5 万美元)。要对 BLOOM-176B 进行微调,则需要 72 块这样的 GPU!而像 PaLM 这样更大的模型则需要更多资源。
由于这些庞大的模型需要如此多的 GPU 才能运行,我们需要找到在保持模型性能的同时降低这些需求的方法。人们已经开发了各种试图缩小模型规模的技术,你可能听说过量化和蒸馏,此外还有许多其他方法。
在完成 BLOOM-176B 的训练后,我们 HuggingFace 和 BigScience 团队一直在寻找方法,让这个大型模型更容易在更少的 GPU 上运行。通过我们的 BigScience 社区,我们了解到一项关于 Int8 推理的研究,它不会降低大型模型的预测性能,并能将大型模型的内存占用减少 2 倍。很快我们就开始在这项研究上展开合作,最终将其完整集成到 Hugging Face transformers 中。通过这篇博客文章,我们为所有 Hugging Face 模型提供 LLM.int8() 集成,下面将更详细地说明。如果你想进一步了解我们的研究,可以阅读我们的论文 LLM.int8():面向大规模 Transformer 的 8 位矩阵乘法。
本文重点是对这项量化技术进行高层次概述,概述将其整合到 transformers 库中的困难,并制定这一合作关系的长期目标。
在这里,你将了解到究竟是什么让大型模型使用如此多的内存?是什么让 BLOOM 达到 350GB?让我们从逐步回顾几个基本前提开始。
机器学习中常用的数据类型
我们首先了解不同浮点数据类型的基本概念,在机器学习语境中,这些也被称为“精度”。
模型的大小由其参数数量及其精度决定,精度通常是 float32、float16 或 bfloat16 之一(下图来自:https://blogs.nvidia.com/blog/2020/05/14/tensorfloat-32-precision-format/)。
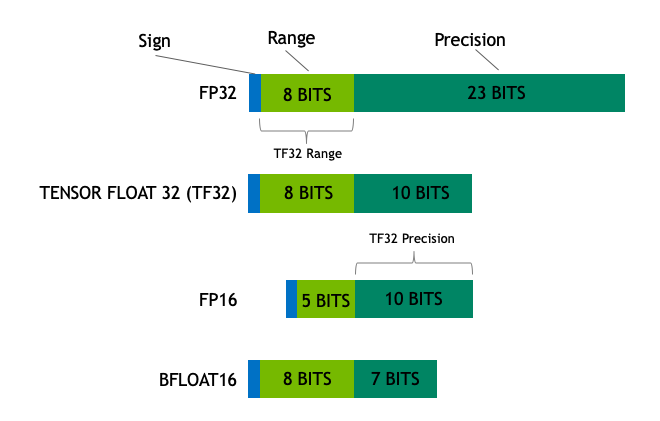
Float32(FP32)代表标准化的 IEEE 32 位浮点表示。使用这种数据类型可以表示范围很广的浮点数。在 FP32 中,8 位保留给“指数”,23 位保留给“尾数”,1 位用于数字的符号。除此之外,大多数硬件都支持 FP32 运算和指令。
在 float16(FP16)数据类型中,5 位保留给指数,10 位保留给尾数。这使得 FP16 数字的可表示范围远低于 FP32。这使 FP16 数字面临上溢(试图表示一个非常大的数)和下溢(表示一个非常小的数)的风险。
例如,如果你执行 10k * 10k,你会得到 100M,这在 FP16 中无法表示,因为可能的最大数是 64k。因此你会得到 NaN(非数值)结果,如果你有像神经网络那样的顺序计算,所有先前的工作都会被破坏。
通常,损失缩放被用来克服这个问题,但它并不总是有效。
一种新的格式 bfloat16(BF16)被创建来避免这些限制。在 BF16 中,8 位保留给指数(与 FP32 相同),7 位保留给小数部分。
这意味着在 BF16 中我们可以保留与 FP32 相同的动态范围。但相对于 FP16,我们损失了 3 位精度。现在对于巨大的数字绝对没有问题,但这里的精度比 FP16 更差。
在 Ampere 架构中,NVIDIA 还引入了 TensorFloat-32(TF32)精度格式,结合了 BF16 的动态范围和 FP16 的精度,仅使用 19 位。它目前仅在特定操作内部使用。
在机器学习术语中,FP32 被称为全精度(4 字节),而 BF16 和 FP16 被称为半精度(2 字节)。 此外,int8(INT8)数据类型由 8 位表示组成,可以存储 2^8 个不同的值(在 [0, 255] 之间,或有符号整数在 [-128, 127] 之间)。
虽然理想情况下训练和推理应该在 FP32 中进行,但它比 FP16/BF16 慢两倍,因此采用了混合精度方法,其中权重以 FP32 保存作为精确的“主权重”参考,而前向和后向传递中的计算以 FP16/BF16 进行以提高训练速度。然后使用 FP16/BF16 梯度来更新 FP32 主权重。
在训练期间,主权重始终以 FP32 存储,但在实践中,半精度权重在推理期间通常提供与 FP32 对应物相似的质量——只有当模型接收到多个梯度更新时才需要精确的参考。这意味着我们可以使用半精度权重,并使用一半的 GPU 来完成相同的结果。
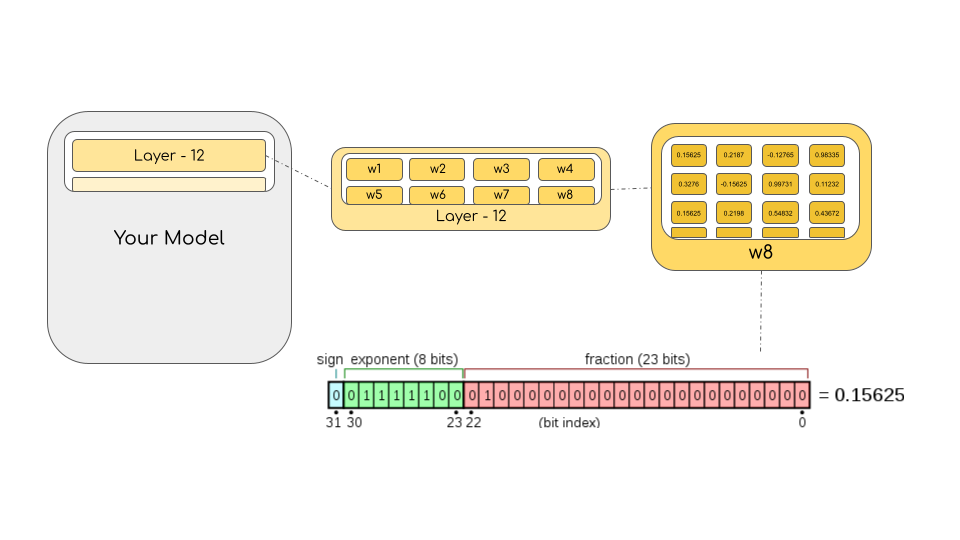
要计算以字节为单位的模型大小,需要将参数数量乘以所选精度的字节大小。例如,如果我们使用 BLOOM-176B 模型的 bfloat16 版本,我们有 176*10**9 x 2 bytes = 352GB!如前所述,要将其放入几个 GPU 中是一个相当大的挑战。
但是,如果我们可以使用不同的数据类型以更少的内存存储这些权重呢?一种称为量化的方法已在深度学习中广泛使用。
模型量化简介
通过实验,我们发现不使用 4 字节的 FP32 精度,我们可以使用 2 字节的 BF16/FP16 半精度获得几乎相同的推理结果,这将模型大小减半。进一步削减会很棒,但在更低的精度下,推理质量结果开始急剧下降。
为了解决这个问题,我们引入了 8 位量化。这种方法使用四分之一精度,因此只需要模型大小的 1/4!但这并不是通过简单地再丢弃一半的位来实现的。
量化本质上是通过从一种数据类型“舍入”到另一种数据类型来完成的。例如,如果一种数据类型的范围是 0..9,另一种是 0..4,那么第一种数据类型中的值“4”会被舍入为第二种数据类型中的“2”。然而,如果第一种数据类型中的值是“3”,它位于第二种数据类型的 1 和 2 之间,那么我们通常会舍入为“2”。这表明第一种数据类型中的值“4”和“3”在第二种数据类型中具有相同的值“2”。这凸显了量化是一个有噪声的过程,可能导致信息丢失,是一种有损压缩。
两种最常见的 8 位量化技术是零点量化和绝对最大值(absmax)量化。零点量化和 absmax 量化将浮点值映射为更紧凑的 int8(1 字节)值。首先,这些方法通过乘以一个量化常数来对输入进行归一化。
例如,在零点量化中,如果我的范围是 -1.0…1.0,而我想量化到 -127…127 的范围,我需要乘以 127 这个因子,然后将其舍入到 8 位精度。要恢复原始值,你需要将 int8 值除以相同的量化因子 127。例如,值 0.3 会被缩放为 0.3*127 = 38.1。通过舍入,我们得到值 38。如果我们反向操作,得到 38/127=0.2992——在这个例子中,我们的量化误差为 0.008。这些看似微小的误差往往会累积,并随着它们在模型各层中传播而增大,最终导致性能下降。
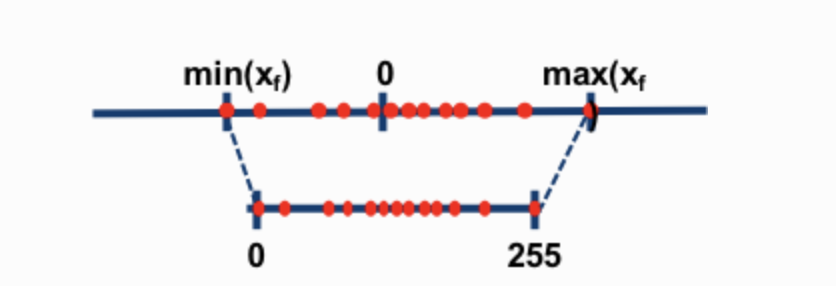
(图片取自:这篇博文)
现在让我们看看 absmax 量化的细节。要计算 absmax 量化中 fp16 数字与其对应 int8 数字之间的映射,你必须先除以张量的绝对最大值,然后乘以数据类型的总范围。
例如,假设你想对一个包含 [1.2, -0.5, -4.3, 1.2, -3.1, 0.8, 2.4, 5.4] 的向量应用 absmax 量化。你提取它的绝对最大值,在这个例子中是 5.4。Int8 的范围是 [-127, 127],所以我们将 127 除以 5.4,得到缩放因子 23.5。因此,将原始向量乘以它,就得到量化后的向量 [28, -12, -101, 28, -73, 19, 56, 127]。
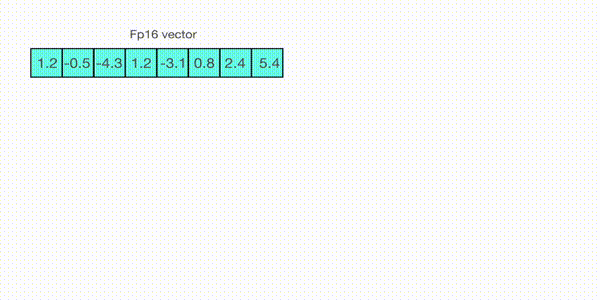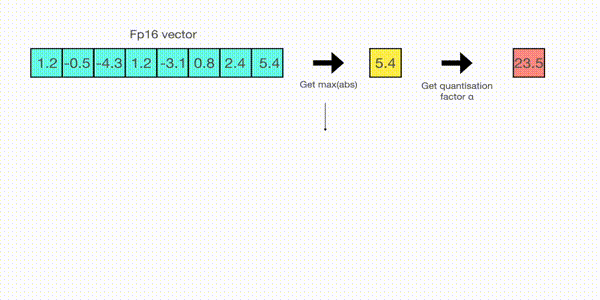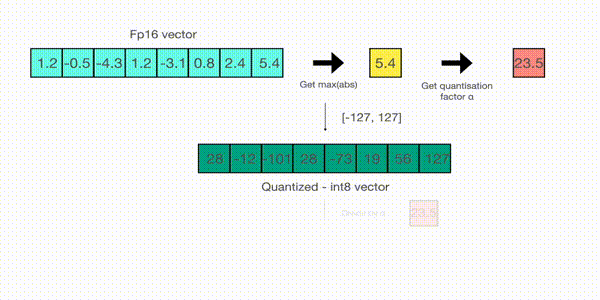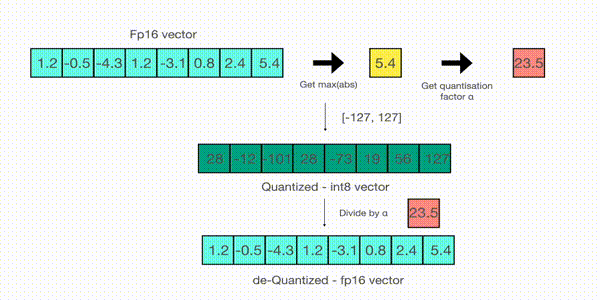
要恢复原始值,只需以全精度将 int8 数字除以量化因子,但由于上述结果是“舍入”过的,一些精度将会丢失。
对于无符号 int8,我们会减去最小值并按绝对最大值进行缩放。这与零点量化所做的很接近。它类似于 min-max 缩放,但后者保持值的缩放方式使得值“0”始终由一个整数表示,没有任何量化误差。
这些技巧可以以多种方式组合,例如,在矩阵乘法中采用逐行或逐向量量化,以获得更准确的结果。观察矩阵乘法 A*B=C,与按每个张量的绝对最大值进行归一化的常规量化不同,逐向量量化会找到 A 的每一行和 B 的每一列的绝对最大值。然后我们通过除以这些向量来归一化 A 和 B。接着我们相乘 A*B 得到 C。最后,为了恢复 FP16 值,我们通过计算 A 和 B 的绝对最大值向量的外积来进行反归一化。关于此技术的更多细节可以在 LLM.int8() 论文 或 Tim 博客上 关于量化和涌现特征的博文 中找到。
虽然这些基本技术使我们能够对深度学习模型进行量化,但它们通常会导致较大模型的精度下降。我们集成到 Hugging Face Transformers 和 Accelerate 库中的 LLM.int8() 实现是第一种即使对于具有 176B 参数的大型模型(如 BLOOM)也不会降低性能的技术。
LLM.int8() 的简要总结:大型语言模型的零退化矩阵乘法
在 LLM.int8() 中,我们证明了理解 transformer 中尺度相关的涌现特性对于理解为什么传统量化在大型模型上失败至关重要。我们证明了性能退化是由离群特征引起的,我们将在下一节中解释。LLM.int8() 算法本身可以解释如下。
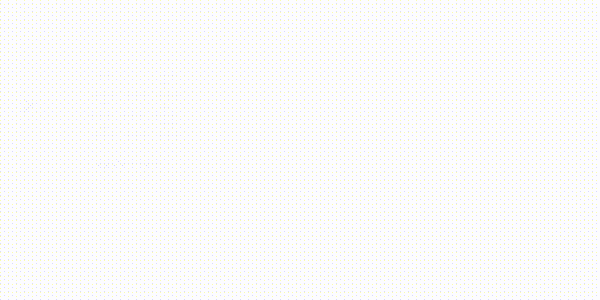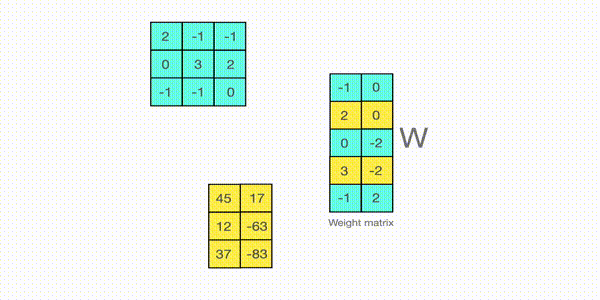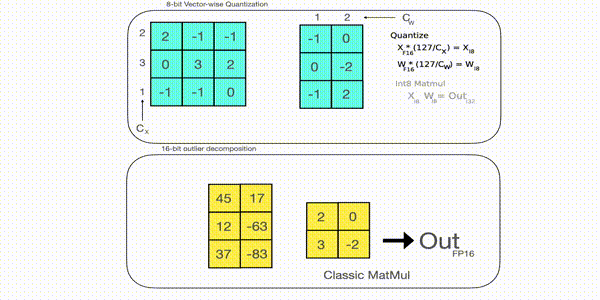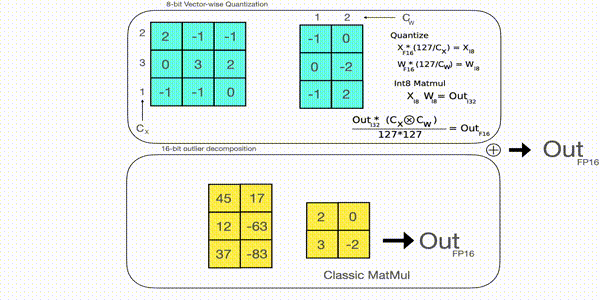
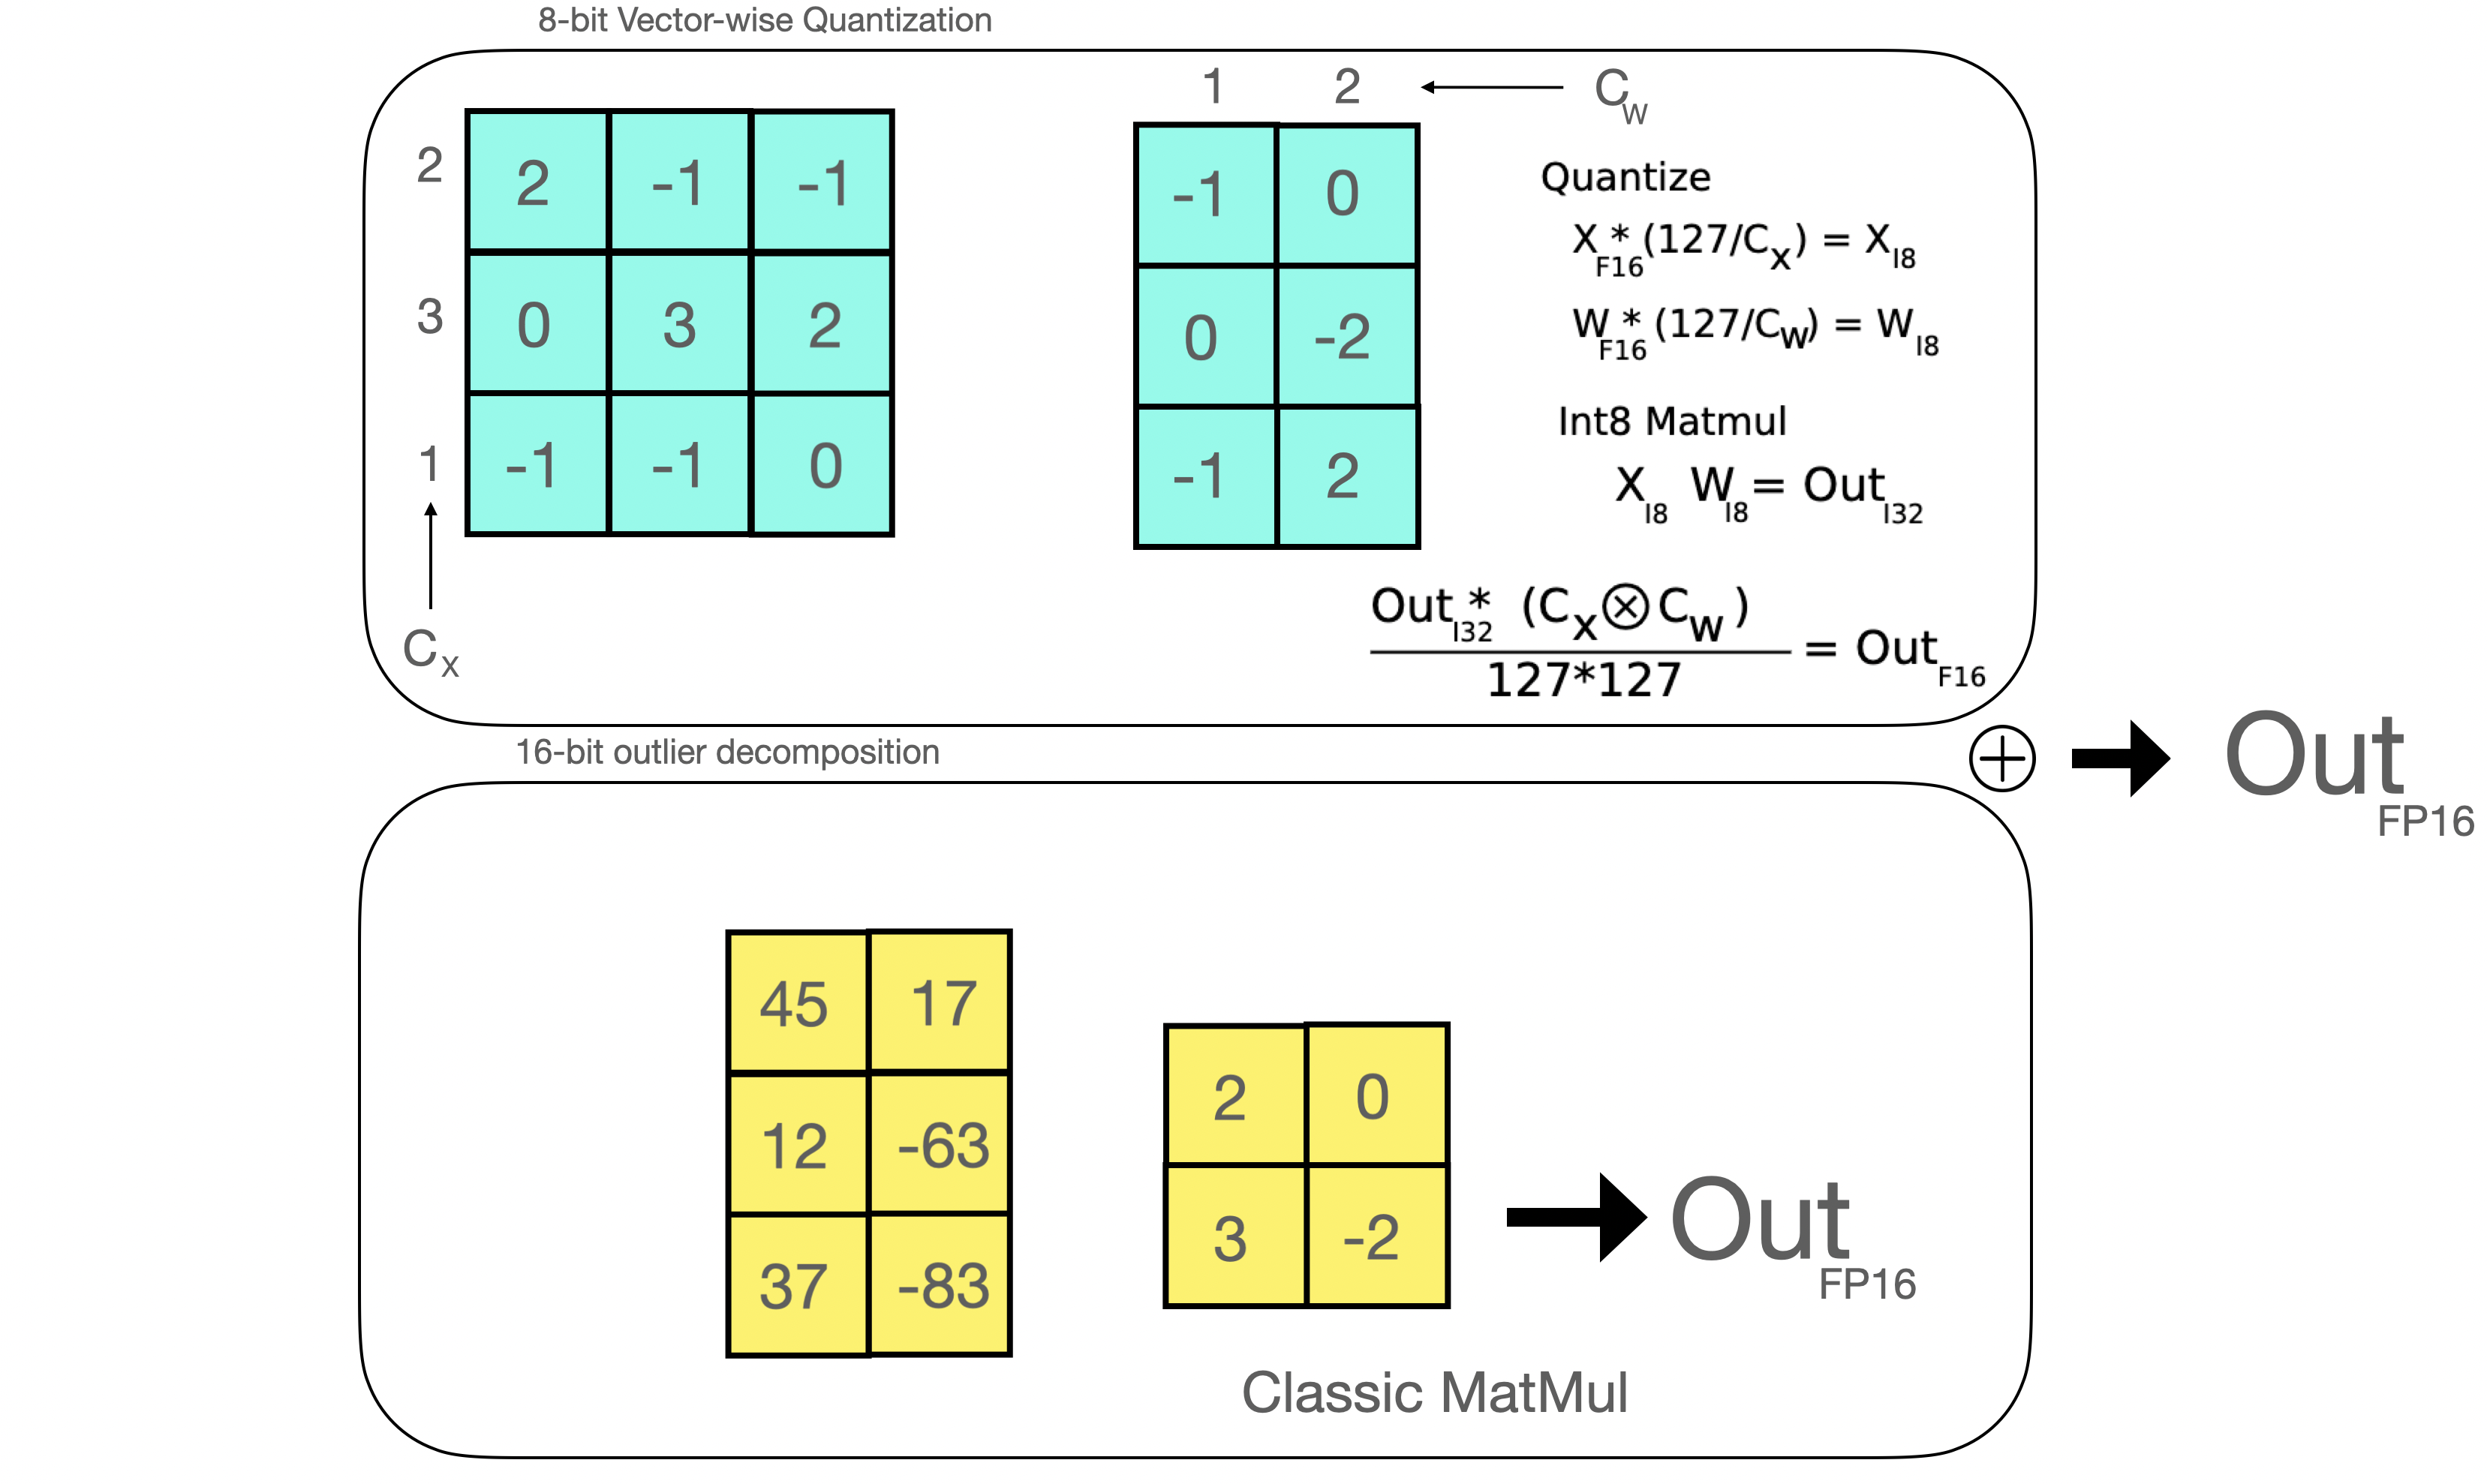
本质上,LLM.int8() 试图通过三个步骤完成矩阵乘法计算:
- 从输入隐藏状态中,按列提取离群值(即大于某个阈值的值)。
- 对离群值以 FP16 进行矩阵乘法,对非离群值以 int8 进行矩阵乘法。
- 将非离群值结果反量化,并将离群值和非离群值结果相加,以 FP16 获得完整结果。
这些步骤可以总结在以下动画中:
离群特征的重要性
超出某些数字全局分布范围的值通常被称为离群值。离群值检测已被广泛使用并涵盖在当前文献中,了解特征的分布有助于离群值检测任务。更具体地说,我们观察到,对于大于 6B 参数的基于 transformer 的模型,经典的大规模量化会失败。虽然较小的模型中也存在大的离群特征,但我们观察到,超过某个阈值后,这些离群值来自 transformer 中高度系统化的模式,这些模式存在于 transformer 的每一层中。有关这些现象的更多详细信息,请参阅 LLM.int8() 论文 和 涌现特征博客文章。
如前所述,8 位精度极其受限,因此量化具有多个大值的向量可能会产生严重错误的结果。此外,由于基于 transformer 的架构具有将所有元素联系在一起的固有特性,这些错误在传播到多个层时往往会累积。因此,开发了混合精度分解,以促进对如此极端离群值的有效量化。接下来将讨论这一点。
MatMul 内部
一旦计算出隐藏状态,我们使用自定义阈值提取离群值,并如上所述将矩阵分解为两部分。我们发现,以这种方式提取所有幅度为 6 或更大的离群值可以恢复完整的推理性能。离群值部分以 fp16 完成,因此是经典的矩阵乘法,而 8 位矩阵乘法是通过使用向量级量化将权重和隐藏状态量化为 8 位精度来完成的——即对隐藏状态进行行级量化,对权重矩阵进行列级量化。 此步骤之后,结果被反量化并以半精度返回,以便将它们添加到第一个矩阵乘法中。
0 退化意味着什么?
我们如何正确评估这种方法的性能退化?使用 8 位模型时,我们在生成质量上损失了多少?
我们使用 lm-eval-harness 对 8 位模型和原生模型运行了几个常见基准测试,并报告了结果。
对于 OPT-175B:
| 基准测试 | - | - | - | - | 差值 - 值 |
|---|---|---|---|---|---|
| 名称 | 指标 | 值 - int8 | 值 - fp16 | 标准误 - fp16 | - |
| hellaswag | acc_norm | 0.7849 | 0.7849 | 0.0041 | 0 |
| hellaswag | acc | 0.5921 | 0.5931 | 0.0049 | 0.001 |
| piqa | acc | 0.7965 | 0.7959 | 0.0094 | 0.0006 |
| piqa | acc_norm | 0.8101 | 0.8107 | 0.0091 | 0.0006 |
| lambada | ppl | 3.0142 | 3.0152 | 0.0552 | 0.001 |
| lambada | acc | 0.7464 | 0.7466 | 0.0061 | 0.0002 |
| winogrande | acc | 0.7174 | 0.7245 | 0.0125 | 0.0071 |
对于 BLOOM-176:
| 基准测试 | - | - | - | - | 差值 - 值 |
|---|---|---|---|---|---|
| 名称 | 指标 | 值 - int8 | 值 - bf16 | 标准误 - bf16 | - |
| hellaswag | acc_norm | 0.7274 | 0.7303 | 0.0044 | 0.0029 |
| hellaswag | acc | 0.5563 | 0.5584 | 0.005 | 0.0021 |
| piqa | acc | 0.7835 | 0.7884 | 0.0095 | 0.0049 |
| piqa | acc_norm | 0.7922 | 0.7911 | 0.0095 | 0.0011 |
| lambada | ppl | 3.9191 | 3.931 | 0.0846 | 0.0119 |
| lambada | acc | 0.6808 | 0.6718 | 0.0065 | 0.009 |
| winogrande | acc | 0.7048 | 0.7048 | 0.0128 | 0 |
我们确实观察到这些模型没有性能退化,因为指标的绝对差值都低于标准误(除了 BLOOM-int8 在 lambada 上略优于原生模型)。如需针对最先进方法的更详细性能评估,请查看论文!
它比原生模型更快吗?
LLM.int8() 方法的主要目的是让大型模型更易于使用,且不降低性能。但如果该方法非常慢,它的用处就会大打折扣。因此,我们对多个模型的生成速度进行了基准测试。 我们发现,使用 LLM.int8() 的 BLOOM-176B 比 fp16 版本慢约 15% 到 23%——这仍然相当可接受。我们发现较小的模型(如 T5-3B 和 T5-11B)的减速更明显。我们努力加速这些小型模型。在一天之内,我们将 T5-3B 的每 token 推理时间从 312 毫秒提高到 173 毫秒,将 T5-11B 的从 45 毫秒提高到 25 毫秒。此外,问题已经被识别,在未来的版本中,LLM.int8() 对小型模型可能会更快。目前,当前数据如下表所示。
| 精度 | 参数量 | 硬件 | 批次大小为 1 时每 token 的毫秒数 | 批次大小为 8 时每 token 的毫秒数 | 批次大小为 32 时每 token 的毫秒数 |
|---|---|---|---|---|---|
| bf16 | 176B | 8xA100 80GB | 239 | 32 | 9.9 |
| int8 | 176B | 4xA100 80GB | 282 | 37.5 | 10.2 |
| bf16 | 176B | 14xA100 40GB | 285 | 36.5 | 10.4 |
| int8 | 176B | 5xA100 40GB | 367 | 46.4 | oom |
| fp16 | 11B | 2xT4 15GB | 11.7 | 1.7 | 0.5 |
| int8 | 11B | 1xT4 15GB | 43.5 | 5.3 | 1.3 |
| fp32 | 3B | 2xT4 15GB | 45 | 7.2 | 3.1 |
| int8 | 3B | 1xT4 15GB | 312 | 39.1 | 10.2 |
这 3 个模型是 BLOOM-176B、T5-11B 和 T5-3B。
Hugging Face transformers 集成细节
接下来让我们讨论 Hugging Face transformers 集成的具体细节。让我们看看用法以及你在尝试设置时可能遇到的常见问题。
用法
本博客文章中描述的所有神奇功能所对应的模块称为 Linear8bitLt,你可以轻松地从 bitsandbytes 库中导入它。它派生自经典的 torch.nn 模块,可以通过下面描述的代码轻松地在你的架构中使用和部署。
以下是以下用例的分步示例:假设你想使用 bitsandbytes 将一个小模型转换为 int8。
- 首先我们需要下面正确的导入!
import torch
import torch.nn as nn

import bitsandbytes as bnb
from bnb.nn import Linear8bitLt
- 然后你可以定义自己的模型。请注意,你可以将任何精度的检查点或模型转换为 8 位(FP16、BF16 或 FP32),但目前,模型的输入必须是 FP16,我们的 Int8 模块才能工作。因此,我们在这里将模型视为 fp16 模型。
fp16_model = nn.Sequential(
    nn.Linear(64, 64),
    nn.Linear(64, 64)
)
- 假设你已经在最喜欢的数据集和任务上训练了模型!现在是保存模型的时候了:
[... train the model ...]
torch.save(fp16_model.state_dict(), "model.pt")
- 现在你的
state_dict已保存,让我们定义一个 int8 模型:
int8_model = nn.Sequential(
    Linear8bitLt(64, 64, has_fp16_weights=False),
    Linear8bitLt(64, 64, has_fp16_weights=False)
)
这里非常重要的一点是添加标志 has_fp16_weights。默认情况下,它设置为 True,用于以混合 Int8/FP16 精度进行训练。然而,我们感兴趣的是内存高效的推理,为此我们需要使用 has_fp16_weights=False。
- 现在是以 8 位加载模型的时候了!
int8_model.load_state_dict(torch.load("model.pt"))
int8_model = int8_model.to(0) # Quantization happens here
请注意,量化步骤是在模型放到 GPU 上后的第二行完成的。如果你在调用 .to 函数之前打印 int8_model[0].weight,你会得到:
int8_model[0].weight
Parameter containing:
tensor([[ 0.0031, -0.0438,  0.0494,  ..., -0.0046, -0.0410,  0.0436],
        [-0.1013,  0.0394,  0.0787,  ...,  0.0986,  0.0595,  0.0162],
        [-0.0859, -0.1227, -0.1209,  ...,  0.1158,  0.0186, -0.0530],
        ...,
        [ 0.0804,  0.0725,  0.0638,  ..., -0.0487, -0.0524, -0.1076],
        [-0.0200, -0.0406,  0.0663,  ...,  0.0123,  0.0551, -0.0121],
        [-0.0041,  0.0865, -0.0013,  ..., -0.0427, -0.0764,  0.1189]],
       dtype=torch.float16)
而如果你在第二行调用之后打印它,你会得到:
int8_model[0].weight
Parameter containing:
tensor([[   3,  -47,   54,  ...,   -5,  -44,   47],
        [-104,   40,   81,  ...,  101,   61,   17],
        [ -89, -127, -125,  ...,  120,   19,  -55],
        ...,
        [  82,   74,   65,  ...,  -49,  -53, -109],
        [ -21,  -42,   68,  ...,   13,   57,  -12],
        [  -4,   88,   -1,  ...,  -43,  -78,  121]],
        device='cuda:0', dtype=torch.int8, requires_grad=True)
正如我们在前面几节解释量化时所看到的,权重值被“截断”了。此外,这些值似乎分布在 [-127, 127] 之间。 你可能还想知道如何取回 FP16 权重,以便用 fp16 执行离群值 MatMul?你可以简单地这样做:
(int8_model[0].weight.CB * int8_model[0].weight.SCB) / 127
然后你会得到:
tensor([[ 0.0028, -0.0459,  0.0522,  ..., -0.0049, -0.0428,  0.0462],
        [-0.0960,  0.0391,  0.0782,  ...,  0.0994,  0.0593,  0.0167],
        [-0.0822, -0.1240, -0.1207,  ...,  0.1181,  0.0185, -0.0541],
        ...,
        [ 0.0757,  0.0723,  0.0628,  ..., -0.0482, -0.0516, -0.1072],
        [-0.0194, -0.0410,  0.0657,  ...,  0.0128,  0.0554, -0.0118],
        [-0.0037,  0.0859, -0.0010,  ..., -0.0423, -0.0759,  0.1190]],
       device='cuda:0')
这与原始 FP16 值已经足够接近了(上面打印了两次)!
- 现在你可以安全地使用你的模型进行推理了,只需确保你的输入位于正确的 GPU 上并且是 FP16 格式:
input_ = torch.randn((1, 64), dtype=torch.float16)
hidden_states = int8_model(input_.to(torch.device('cuda', 0)))
查看示例脚本以获取完整的最小代码!
另外需要说明的是,你应该知道这些模块与 nn.Linear 模块略有不同,因为它们的参数来自 bnb.nn.Int8Params 类而不是 nn.Parameter 类。稍后你会看到,这给我们的旅程带来了额外的障碍!
现在是时候理解如何将其集成到 transformers 库中了!
你只需要 accelerate
在处理超大模型时,accelerate 库包含许多有用的工具。init_empty_weights 方法尤其有用,因为任何模型,无论大小,都可以使用该方法作为上下文管理器进行初始化,而无需为模型权重分配任何内存。
import torch.nn as nn
from accelerate import init_empty_weights

with init_empty_weights():
    model = nn.Sequential([nn.Linear(100000, 100000) for _ in range(1000)]) # This will take ~0 RAM!
初始化后的模型将被放到 PyTorch 的 meta 设备上,这是一种底层机制,用于表示形状和 dtype 而不为存储分配内存。这有多酷?
最初,这个函数在 .from_pretrained 函数内部被调用,并将所有参数覆盖为 torch.nn.Parameter。这不符合我们的需求,因为如上所述,在我们的场景中我们希望为 Linear8bitLt 模块保留 Int8Params 类。我们在以下 PR 中修复了这个问题,该 PR 修改了:
module._parameters[name] = nn.Parameter(module._parameters[name].to(torch.device("meta")))
为
param_cls = type(module._parameters[name])
kwargs = module._parameters[name].__dict__
module._parameters[name] = param_cls(module._parameters[name].to(torch.device("meta")), **kwargs)
现在这个问题已经修复,我们可以轻松利用这个上下文管理器,并使用自定义函数以零内存成本将所有 nn.Linear 模块替换为 bnb.nn.Linear8bitLt!
def replace_8bit_linear(model, threshold=6.0, module_to_not_convert="lm_head"):
    for name, module in model.named_children():
        if len(list(module.children())) > 0:
            replace_8bit_linear(module, threshold, module_to_not_convert)

        if isinstance(module, nn.Linear) and name != module_to_not_convert:
            with init_empty_weights():
                model._modules[name] = bnb.nn.Linear8bitLt(
                    module.in_features,
                    module.out_features,
                    module.bias is not None,
                    has_fp16_weights=False,
                    threshold=threshold,
                )
    return model
这个函数会递归地替换在 meta 设备上初始化的给定模型的所有 nn.Linear 层,并将它们替换为 Linear8bitLt 模块。属性 has_fp16_weights 必须设置为 False,以便连同量化统计信息一起直接在 int8 中加载权重。
我们还会放弃对某些模块(这里是 lm_head)的替换,因为我们希望保留后者以其原生精度,以获得更精确和稳定的结果。
但这还没有结束!上面的函数是在 init_empty_weights 上下文管理器下执行的,这意味着新模型仍将位于 meta 设备上。
对于在此上下文管理器下初始化的模型,accelerate 将手动加载每个模块的参数并将它们移动到正确的设备上。
在 bitsandbytes 中,设置 Linear8bitLt 模块的设备是至关重要的一步(如果你好奇,可以查看这里的代码片段),正如我们在玩具脚本中所看到的那样。
这里量化步骤在第二次调用时会失败。我们不得不为 accelerate 的 set_module_tensor_to_device 函数(称为 set_module_8bit_tensor_to_device)提出一种实现,以确保我们不会调用它两次。让我们在下面一节中详细讨论这一点!
在使用 accelerate 设置设备时要非常小心
在这里,我们对accelerate库进行了一次非常微妙的平衡操作!
一旦你加载了模型并将其设置到正确的设备上,有时你仍然需要调用set_module_tensor_to_device来在所有设备上以钩子方式分发模型。这是在accelerate的dispatch_model函数内部完成的,这可能涉及多次调用.to,而这是我们希望避免的。
为了实现我们想要的效果,需要2个Pull Request!最初提出的PR在这里破坏了一些测试,但这个PR成功修复了一切!
总结
因此,最终的配方是:
- 在
meta设备上使用正确的模块初始化模型 - 在正确的GPU设备上逐个设置参数,并确保你永远不会重复这个过程!
- 在所有地方将新的关键字参数放在正确的位置,并添加一些好的文档
- 添加非常全面的测试!查看我们的测试这里了解更多详情 这听起来可能相当简单,但我们一起经历了许多艰难的调试过程,很多时候都涉及CUDA内核!
总而言之,这次集成冒险非常有趣;从深入研究和在不同库上做一些“手术”,到对齐一切并使其正常工作!
现在是时候看看如何从这次集成中受益,以及如何在transformers中成功使用它了!
如何在transformers中使用它
硬件要求
CPU不支持8位张量核心。bitsandbytes可以在支持8位张量核心的硬件上运行,即Turing和Ampere GPU(RTX 20系列、RTX 30系列、A40-A100、T4+)。例如,Google Colab的GPU通常是NVIDIA T4 GPU,它们的最新代GPU确实支持8位张量核心。我们的演示基于Google Colab,所以请在下面查看它们!
安装
只需使用以下命令安装最新版本的库(确保你使用的是python>=3.8),然后运行以下命令来尝试
pip install accelerate
pip install bitsandbytes
pip install git+https://github.com/huggingface/transformers.git
示例演示 - 在Google Colab上运行T5 11b
查看Google Colab演示,了解如何在BLOOM-3B模型上运行8位模型!
这是运行T5-11B的演示。T5-11B模型检查点采用FP32格式,占用42GB内存,无法在Google Colab上运行。使用我们的8位模块,它只占用11GB,轻松适配:

或者这个BLOOM-3B的演示:
改进范围
在我们看来,这种方法极大地提高了对超大型模型的可访问性。在没有性能下降的情况下,它使计算资源较少的用户能够访问以前无法访问的模型。 我们发现了几个可以在未来改进的领域,以使这种方法对大型模型更加有效!
小型模型的更快推理速度
正如我们在基准测试部分所看到的,我们可以将小型模型(<=6B参数)的运行速度提高近2倍。然而,虽然对于像BLOOM-176B这样的大型模型,推理速度很稳健,但对于小型模型仍有改进空间。我们已经确定了问题所在,并可能恢复与fp16相同的性能,或获得小幅加速。你将在接下来的几周内看到这些更改被集成。
支持Kepler GPU(GTX 1080等)
虽然我们支持过去四年的所有 GPU,但一些旧 GPU 如 GTX 1080 仍被大量使用。虽然这些 GPU 没有 Int8 张量核心,但它们确实有 Int8 向量单元(一种“弱”张量核心)。因此,这些 GPU 也可以体验 Int8 加速。然而,它需要一整套不同的软件栈来实现快速推理。虽然我们确实计划集成对 Kepler GPU 的支持,以使 LLM.int8() 功能更广泛地可用,但由于其复杂性,实现这一点需要一些时间。
在 Hub 上保存 8 位状态字典
目前,8 位状态字典在推送到 Hub 后无法直接加载到 8 位模型中。这是因为模型计算的统计数据(记住 weight.CB 和 weight.SCB)目前未存储在状态字典中或未被考虑在内,并且 Linear8bitLt 模块尚不支持此功能。
我们认为,能够保存并推送到 Hub 可能有助于提高可访问性。
CPU 支持
正如本博文开头所述,CPU 设备不支持 8 位核心。然而,我们能克服这一点吗?在 CPU 上运行此模块也将显著提高可用性和可访问性。
扩展到其他模态
目前,语言模型在非常大的模型中占主导地位。在未来几年,随着这些模型变得更加可访问,将这种方法应用于非常大的视觉、音频和多模态模型可能是一件有趣的事情,以提高可访问性。
致谢
非常感谢以下人员为提高文章可读性以及在 transformers 中的集成过程中做出的贡献(按字母顺序列出):
JustHeuristic (Yozh),
Michael Benayoun,
Stas Bekman,
Steven Liu,
Sylvain Gugger,
Tim Dettmers
来源:Hugging Face:Blog · huggingface.co