Hugging Face Diffusers 0.3 发布:图生图、Textual Inversion 与低显存优化
What's new in Diffusers? 🎨
Hugging Face 发布 diffusers 0.3,为扩散模型库新增图生图、Textual Inversion、实验性 inpainting、ONNX 导出和 macOS M1/M2 推理支持等功能。优化后 Stable Diffusion 显存占用降至 3.2GB,代价是约 10% 的速度损失;社区还贡献了视频生成、可解释性工具和日语、动漫方向的微调模型。
原文梳理了 diffusers 0.3 的图生图、Textual Inversion、低显存优化等新功能,开源图像工作流的使用者可以对照更新自己的用法。
一个半月前,我们发布了diffusers,这是一个为跨模态扩散模型提供模块化工具箱的库。几周后,我们发布了对Stable Diffusion的支持,这是一个高质量的文本到图像模型,并提供了免费演示供任何人尝试。除了消耗大量GPU之外,在过去三周里,团队决定为库添加一两个新功能,希望社区喜欢!这篇博客文章对diffusers版本0.3中的新功能进行了高层次概述!记得给GitHub仓库点个⭐。
图像到图像管道
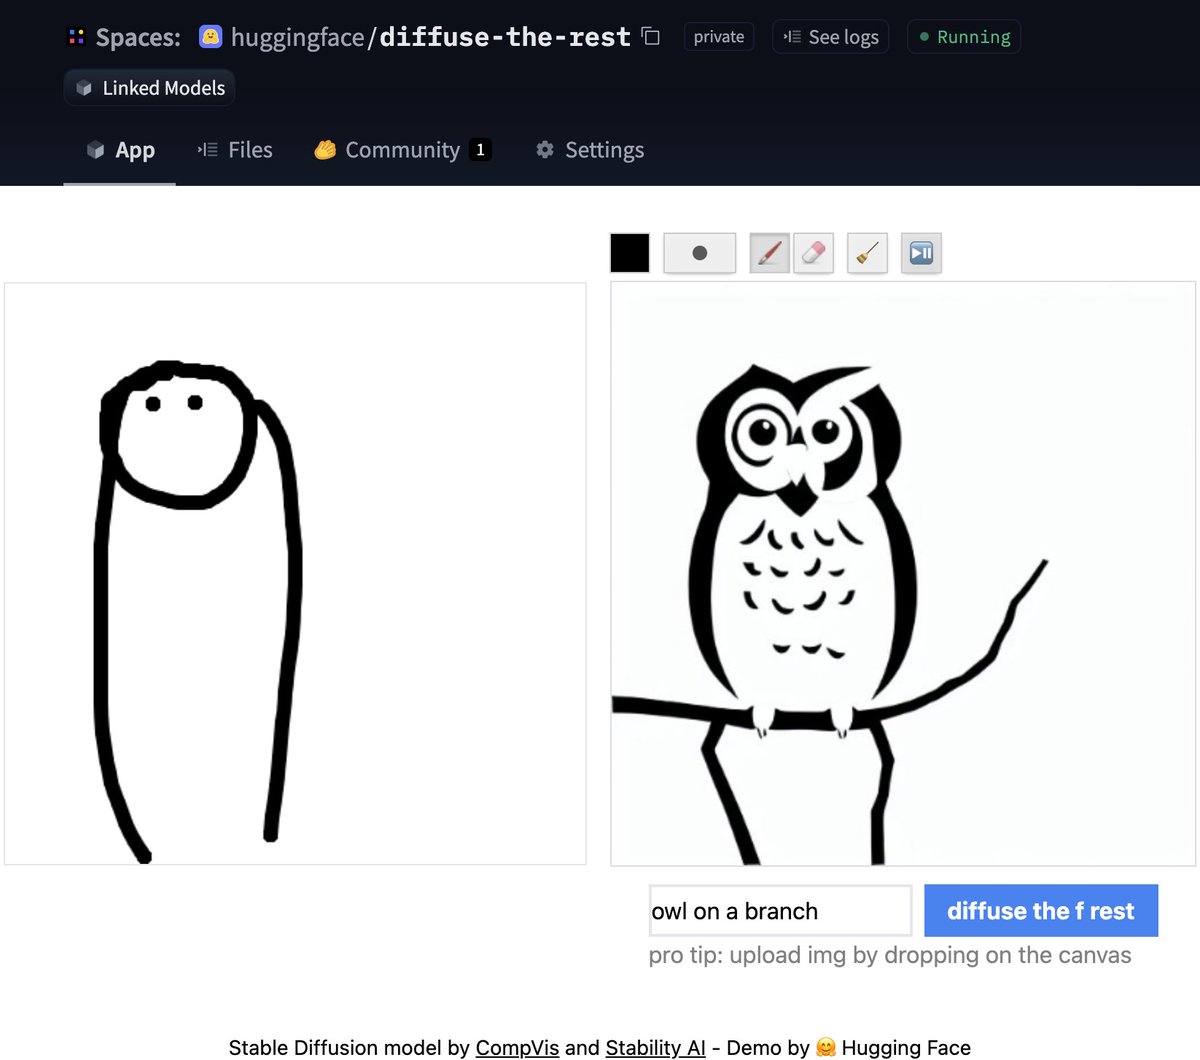
最受欢迎的功能之一是图像到图像生成。这个管道允许你输入一张图像和一个提示,然后它会基于此生成一张图像!
让我们看一些基于官方Colab notebook的代码。
from diffusers import StableDiffusionImg2ImgPipeline

pipe = StableDiffusionImg2ImgPipeline.from_pretrained(
    "CompVis/stable-diffusion-v1-4",
    revision="fp16",
    torch_dtype=torch.float16,
    use_auth_token=True
)

# Download an initial image
# ...

init_image = preprocess(init_img)

prompt = "A fantasy landscape, trending on artstation"
images = pipe(prompt=prompt, init_image=init_image, strength=0.75, guidance_scale=7.5, generator=generator)["sample"]
没时间写代码?别担心,我们还创建了一个Space演示,你可以直接尝试。
文本反转
文本反转让你只需3-5个样本就能在自己的图像上个性化Stable Diffusion模型。使用这个工具,你可以在一个概念上训练模型,然后与社区其他成员分享这个概念!
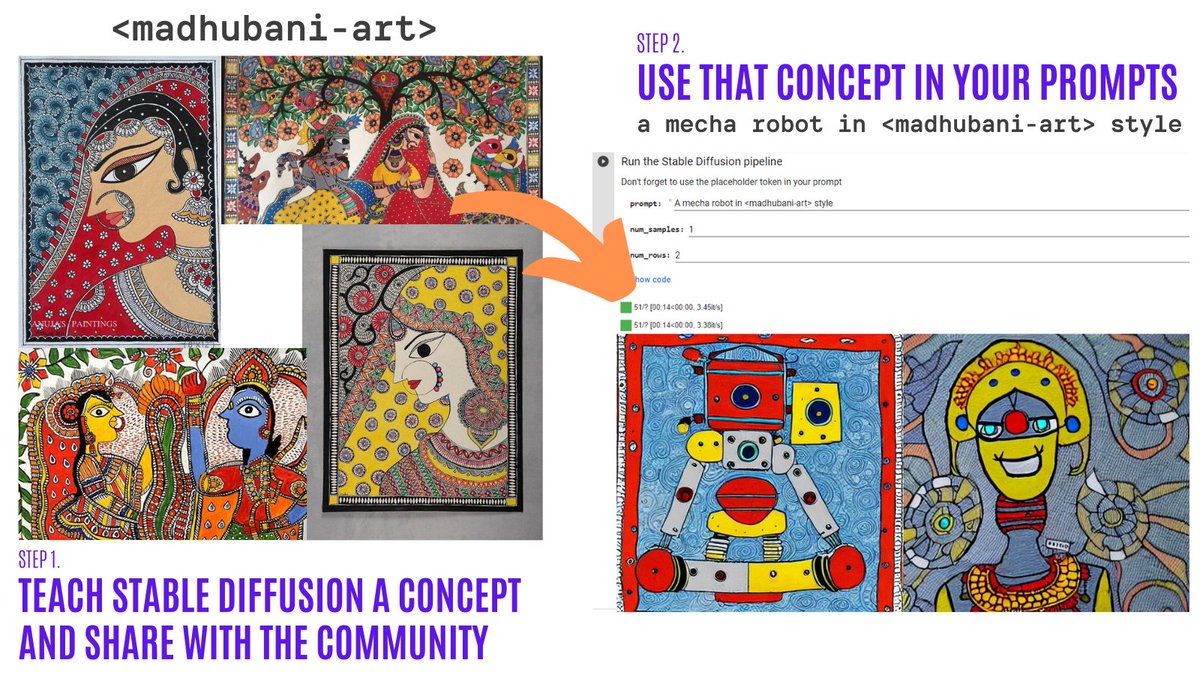
短短几天内,社区就分享了超过200个概念!快来看看吧!
- 包含这些概念的组织。
- 导航器Colab:可视化浏览并使用社区创建的超过150个概念。
- 训练Colab:教Stable Diffusion一个新概念,并与社区其他成员分享。
- 推理Colab:使用学习到的概念运行Stable Diffusion。
实验性图像修复管道
图像修复允许提供一张图像,然后在图像中选择一个区域(或提供掩码),并使用Stable Diffusion替换掩码。这里有一个例子:

你可以尝试一个极简的Colab notebook或查看下面的代码。演示即将推出!
from diffusers import StableDiffusionInpaintPipeline

pipe = StableDiffusionInpaintPipeline.from_pretrained(
    "CompVis/stable-diffusion-v1-4",
    revision="fp16",
    torch_dtype=torch.float16,
    use_auth_token=True
).to(device)

images = pipe(
    prompt=["a cat sitting on a bench"] * 3,
    init_image=init_image,
    mask_image=mask_image,
    strength=0.75,
    guidance_scale=7.5,
    generator=None
).images
请注意这是实验性的,因此还有改进的空间。
针对较小GPU的优化
经过一些改进,扩散模型可以占用更少的VRAM。🔥 例如,Stable Diffusion只占用3.2GB!这以10%的速度为代价,产生了完全相同的结果。以下是使用这些优化的方法。
from diffusers import StableDiffusionPipeline

pipe = StableDiffusionPipeline.from_pretrained(
    "CompVis/stable-diffusion-v1-4",
    revision="fp16",
    torch_dtype=torch.float16,
    use_auth_token=True
)
pipe = pipe.to("cuda")
pipe.enable_attention_slicing()
这非常令人兴奋,因为这将进一步降低使用这些模型的门槛!
Mac OS中的Diffusers
🍎 没错!另一个广受欢迎的功能刚刚发布!请阅读官方文档中的完整说明(包括性能比较、规格等)。
使用PyTorch的mps设备,拥有M1/M2硬件的人可以运行Stable Diffusion的推理。🤯 这对用户来说设置非常简单,试试看吧!
from diffusers import StableDiffusionPipeline

pipe = StableDiffusionPipeline.from_pretrained("CompVis/stable-diffusion-v1-4", use_auth_token=True)
pipe = pipe.to("mps")

prompt = "a photo of an astronaut riding a horse on mars"
image = pipe(prompt).images[0]
实验性ONNX导出器和管道
新的实验性流水线允许用户在支持 ONNX 的任何硬件上运行 Stable Diffusion。以下是一个使用示例(注意使用了 onnx 修订版)
from diffusers import StableDiffusionOnnxPipeline

pipe = StableDiffusionOnnxPipeline.from_pretrained(
    "CompVis/stable-diffusion-v1-4",
    revision="onnx",
    provider="CPUExecutionProvider",
    use_auth_token=True,
)

prompt = "a photo of an astronaut riding a horse on mars"
image = pipe(prompt).images[0]
或者,你也可以直接使用导出脚本将 SD 检查点转换为 ONNX。
python scripts/convert_stable_diffusion_checkpoint_to_onnx.py --model_path="CompVis/stable-diffusion-v1-4" --output_path="./stable_diffusion_onnx"
新文档
之前的所有功能都非常酷。作为开源库的维护者,我们深知高质量文档的重要性,以便尽可能让任何人都能轻松尝试这个库。
💅 因此,我们进行了一次文档冲刺,并且非常兴奋地发布了我们的文档的第一个版本。这是第一个版本,所以我们计划添加许多内容(并且始终欢迎贡献!)。
文档的一些亮点:
社区
在我们做上述所有事情的同时,社区也没有闲着!以下是社区所做工作的一些亮点(虽然并不详尽)
Stable Diffusion 视频
通过探索潜在空间并在文本提示之间变形,使用 Stable Diffusion 创建 🔥 视频。你可以:
- 为同一提示生成不同版本
- 在不同提示之间变形
Stable Diffusion Videos 工具可通过 pip 安装,附带 Colab 笔记本和 Gradio 笔记本,并且非常易于使用!
以下是一个示例
from stable_diffusion_videos import walk

video_path = walk(['a cat', 'a dog'], [42, 1337], num_steps=3, make_video=True)
Diffusers Interpret
Diffusers interpret 是一个基于 diffusers 构建的可解释性工具。它具有很酷的功能,例如:
- 查看扩散过程中的所有图像
- 分析提示中的每个 token 如何影响生成
- 如果你想要理解图像的某一部分,可以在指定的边界框内进行分析
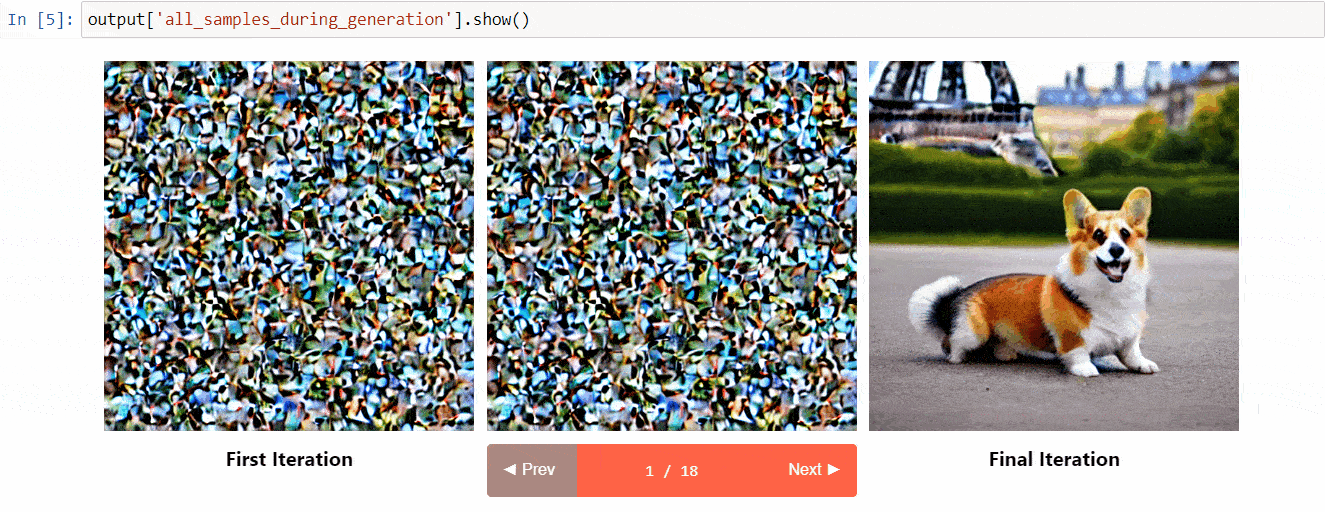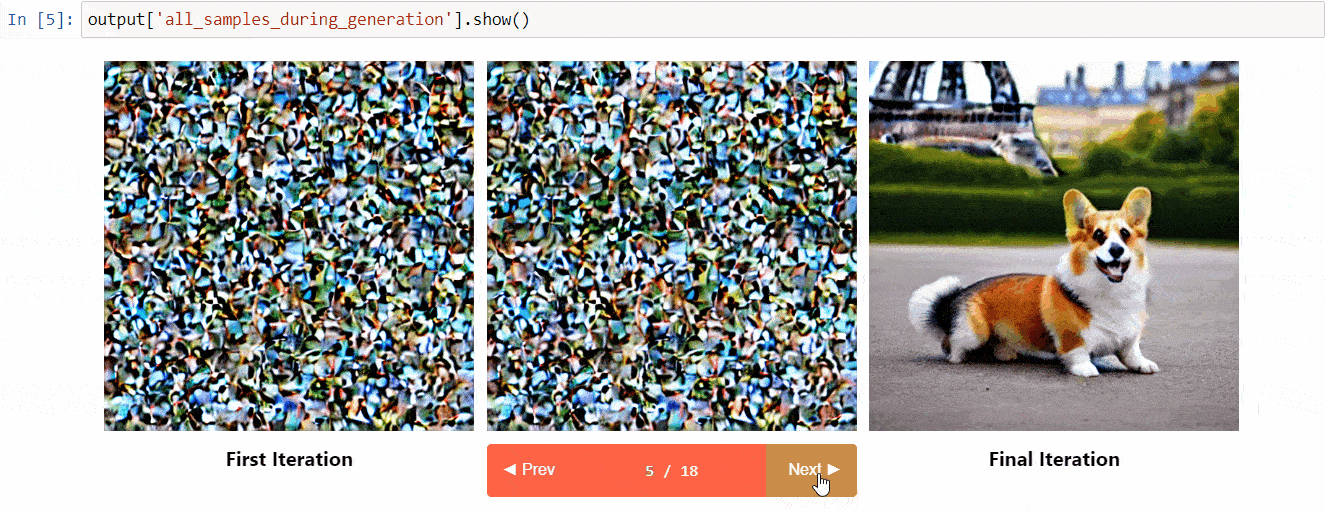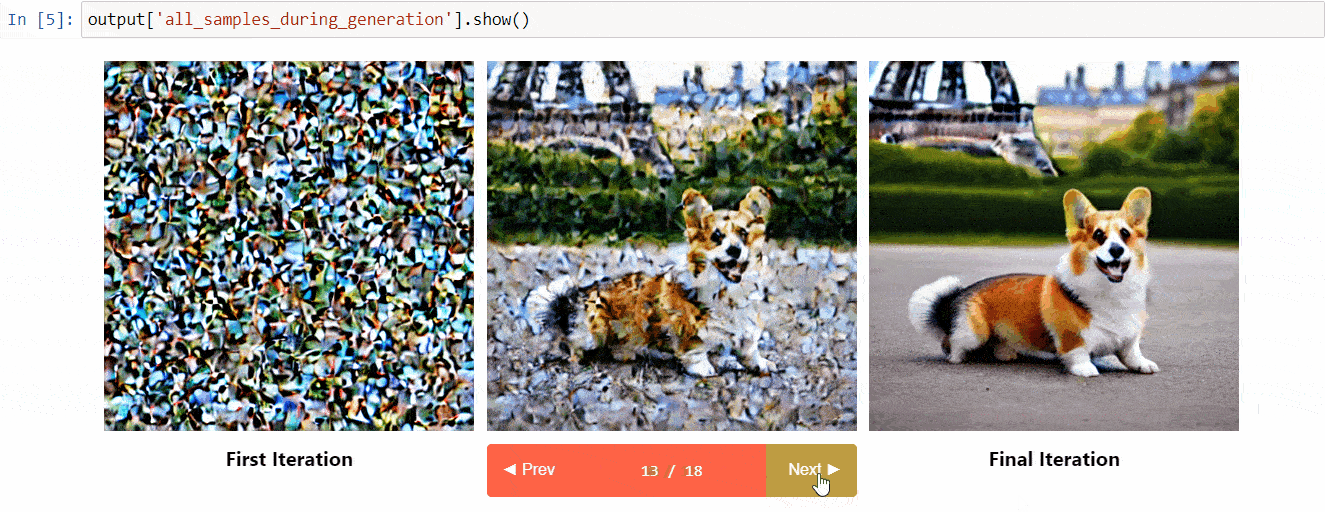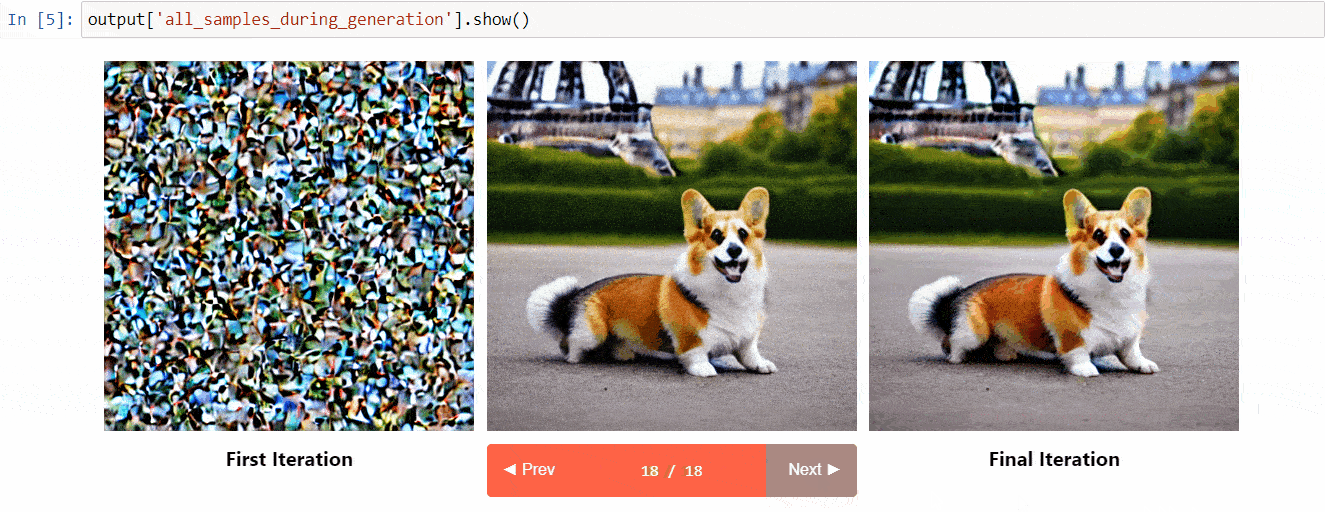 (图片来自工具仓库)
# pass pipeline to the explainer class
explainer = StableDiffusionPipelineExplainer(pipe)

# generate an image with `explainer`
prompt = "Corgi with the Eiffel Tower"
output = explainer(
    prompt,
    num_inference_steps=15
)

output.normalized_token_attributions # (token, attribution_percentage)
#[('corgi', 40),
# ('with', 5),
# ('the', 5),
# ('eiffel', 25),
# ('tower', 25)]
Japanese Stable Diffusion
名字说明了一切!JSD 的目标是训练一个也能捕捉文化、身份和独特表达信息的模型。它使用了 1 亿张带有日语说明的图片进行训练。你可以在模型卡片中了解更多关于模型训练方式的信息
Waifu Diffusion
Waifu Diffusion 是一个针对高质量动漫图像生成进行微调的 SD 模型。

(图片来自工具仓库)
交叉注意力控制
交叉注意力控制通过修改扩散模型的注意力图,允许对提示进行精细控制。你可以做一些很酷的事情:
- 替换提示中的目标(例如将猫替换为狗)
- 减少或增加提示中单词的重要性(例如,如果你希望减少对“岩石”的关注)
- 轻松注入风格
还有更多!查看仓库。
可复用种子
Stable Diffusion 最令人印象深刻的早期演示之一是复用种子来调整图像。其想法是使用感兴趣图像的种子,以不同的提示生成新图像。这产生了一些很酷的结果!查看 Colab
感谢阅读!
希望你喜欢这篇文章!记得在我们的 GitHub 仓库 点个 Star,并加入 Hugging Face Discord 服务器,我们在那里专门设有 Diffusion 模型类别的频道。最新的库动态都会在那里分享!
欢迎随时提交 issue 提出功能请求和 bug 报告!所取得的这一切成就都离不开如此出色的社区。
来源:Hugging Face:Blog · huggingface.co