Hugging Face 教程:用 Time Series Transformer 做概率时间序列预测
Probabilistic Time Series Forecasting with 🤗 Transformers
Hugging Face 发布教程,讲解如何用其 Transformers 库的 Time Series Transformer 从零训练单变量概率时间序列预测模型,涵盖 GluonTS 数据转换、DataLoader 构建、40 个 epoch 的训练及 generate() 自回归推理。
教程展示了完整的代码训练流程,并在 Monash 基准上给出可对照的 MASE 结果,便于读者迁移到自己的时间序列数据。

引言
时间序列预测是一个重要的科学和商业问题,因此最近也见证了许多创新,除了经典方法之外,还使用了基于深度学习的模型。像 ARIMA 这样的经典方法与新颖的深度学习方法之间的一个重要区别如下。
概率预测
通常,经典方法是在数据集中的每个时间序列上单独拟合的。这些通常被称为“单一”或“局部”方法。然而,当某些应用需要处理大量时间序列时,在所有可用时间序列上训练一个“全局”模型是有益的,这使模型能够从许多不同来源学习潜在表示。
一些经典方法是点值的(意味着它们每个时间步只输出一个值),模型通过最小化相对于真实数据的 L2 或 L1 类型的损失来训练。然而,由于预测通常用于某些现实世界的决策流程中,即使有人参与其中,提供预测的不确定性也是更有益的。这也称为“概率预测”,与“点预测”相对。这需要建模一个概率分布,从中可以进行采样。
简而言之,我们不是训练局部点预测模型,而是希望训练全局概率模型。深度学习非常适合这一点,因为神经网络可以从多个相关时间序列中学习表示,并对数据的不确定性进行建模。
在概率设置中,常见做法是学习某个选定的参数分布(如高斯分布或 Student-T 分布)的未来参数;或学习条件分位数函数;或使用适应时间序列设置的 Conformal Prediction 框架。方法的选择不影响建模方面,因此通常可以视为另一个超参数。人们总是可以通过取经验均值或中位数将概率模型转换为点预测模型。
时间序列 Transformer
在建模本质上是序列的时间序列数据方面,可以想象,研究人员已经提出了使用循环神经网络(RNN)如 LSTM 或 GRU,或卷积网络(CNN)的模型,以及最近自然适合时间序列预测设置的基于 Transformer 的方法。
在这篇博客文章中,我们将利用原始 Transformer (Vaswani et al., 2017) 进行单变量概率预测任务(即单独预测每个时间序列的 1 维分布)。编码器-解码器 Transformer 是预测的自然选择,因为它很好地封装了几个归纳偏置。
首先,使用编码器-解码器架构在推理时很有帮助,通常对于某些记录的数据,我们希望预测未来的一些步骤。这可以类比于文本生成任务,即给定一些上下文,我们采样下一个 token 并将其传回解码器(也称为“自回归生成”)。同样地,在这里,给定某种分布类型,我们也可以从中采样以提供预测,直到我们期望的预测范围。这被称为祖先采样。这里有一篇关于语言模型背景下采样的优秀博客文章。
其次,Transformer 帮助我们训练可能包含数千个时间点的时间序列数据。由于注意力机制的时间和内存限制,将时间序列的所有历史一次性输入模型可能不可行。因此,在构建随机梯度下降(SGD)的批次时,可以考虑一些适当的上下文窗口,并从训练数据中采样这个窗口和随后的预测长度大小的窗口。上下文大小的窗口可以传递给编码器,预测窗口传递给因果掩码解码器。这意味着解码器在学习下一个值时只能查看之前的时间步。这等同于训练用于机器翻译的普通 Transformer 的方式,称为“教师强制”。
Transformer 相对于其他架构的另一个好处是,我们可以将缺失值(在时间序列设置中很常见)作为编码器或解码器的额外掩码,并且仍然可以在不进行填充或插补的情况下进行训练。这等同于 Transformers 库中 BERT 和 GPT-2 等模型的 attention_mask,即在计算注意力矩阵时不包含填充 token。
Transformer 架构的一个缺点是上下文和预测窗口大小的限制,因为普通 Transformer 的二次计算和内存需求,参见 Tay et al., 2020。此外,由于 Transformer 是一个强大的架构,与其他方法相比,它可能更容易过拟合或学习虚假相关性。
🤗 Transformers 库附带了一个普通的概率时间序列 Transformer 模型,简称为时间序列 Transformer。在下面的部分中,我们将展示如何在自定义数据集上训练这样的模型。
设置环境
首先,让我们安装必要的库:🤗 Transformers、🤗 Datasets、🤗 Evaluate、🤗 Accelerate 和 GluonTS。
正如我们将展示的,GluonTS 将用于转换数据以创建特征,以及创建适当的训练、验证和测试批次。
!pip install -q transformers

!pip install -q datasets

!pip install -q evaluate

!pip install -q accelerate

!pip install -q gluonts ujson
加载数据集
在这篇博客文章中,我们将使用 tourism_monthly 数据集,它可在 Hugging Face Hub 上获得。该数据集包含澳大利亚 366 个地区的月度旅游量。
该数据集是 Monash Time Series Forecasting 存储库的一部分,该存储库收集了来自多个领域的时间序列数据集。它可以被视为时间序列预测的 GLUE 基准。
from datasets import load_dataset

dataset = load_dataset("monash_tsf", "tourism_monthly")
如所见,数据集包含 3 个分割:训练、验证和测试。
dataset

>>> DatasetDict({
        train: Dataset({
            features: ['start', 'target', 'feat_static_cat', 'feat_dynamic_real', 'item_id'],
            num_rows: 366
        })
        test: Dataset({
            features: ['start', 'target', 'feat_static_cat', 'feat_dynamic_real', 'item_id'],
            num_rows: 366
        })
        validation: Dataset({
            features: ['start', 'target', 'feat_static_cat', 'feat_dynamic_real', 'item_id'],
            num_rows: 366
        })
    })
每个示例包含几个键,其中 start 和 target 是最重要的。让我们看看数据集中的第一个时间序列:
train_example = dataset['train'][0]
train_example.keys()

>>> dict_keys(['start', 'target', 'feat_static_cat', 'feat_dynamic_real', 'item_id'])
start 仅表示时间序列的起点(作为日期时间),而 target 包含时间序列的实际值。
start 将有助于向时间序列值添加与时间相关的特征,作为模型的额外输入(例如“一年中的月份”)。由于我们知道数据的频率是 monthly,因此我们知道例如第二个值的时间戳是 1979-02-01,等等。
print(train_example['start'])
print(train_example['target'])

>>> 1979-01-01 00:00:00
    [1149.8699951171875, 1053.8001708984375, ..., 5772.876953125]
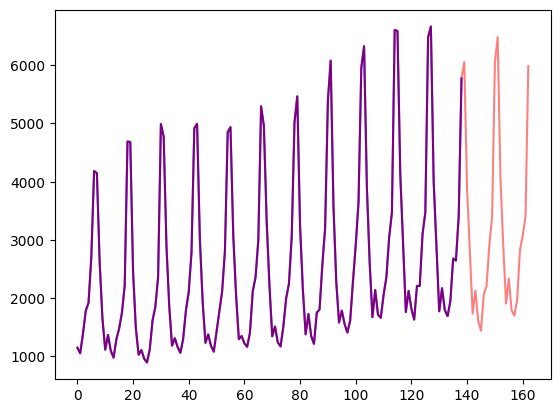
验证集包含与训练集相同的数据,只是时间长度多 prediction_length。这使我们能够根据真实值验证模型的预测。
测试集相比验证集又多了 prediction_length 的数据(或者相比训练集多了 prediction_length 的倍数数据,用于在多个滚动窗口上进行测试)。
validation_example = dataset['validation'][0]
validation_example.keys()

>>> dict_keys(['start', 'target', 'feat_static_cat', 'feat_dynamic_real', 'item_id'])
初始值与对应的训练样本完全相同:
print(validation_example['start'])
print(validation_example['target'])

>>> 1979-01-01 00:00:00
    [1149.8699951171875, 1053.8001708984375, ..., 5985.830078125]
然而,与训练样本相比,这个样本多了 prediction_length=24 个值。让我们验证一下。
freq = "1M"
prediction_length = 24

assert len(train_example["target"]) + prediction_length == len(
    validation_example["target"]
)
让我们将其可视化:
import matplotlib.pyplot as plt

figure, axes = plt.subplots()
axes.plot(train_example["target"], color="blue")
axes.plot(validation_example["target"], color="red", alpha=0.5)

plt.show()
让我们拆分数据:
train_dataset = dataset["train"]
test_dataset = dataset["test"]
将 start 更新为 pd.Period
我们要做的第一件事是使用数据的 freq 将每个时间序列的 start 特征转换为 pandas Period 索引:
from functools import lru_cache

import pandas as pd
import numpy as np

@lru_cache(10_000)
def convert_to_pandas_period(date, freq):
    return pd.Period(date, freq)

def transform_start_field(batch, freq):
    batch["start"] = [convert_to_pandas_period(date, freq) for date in batch["start"]]
    return batch
我们现在使用 datasets 的 set_transform 功能就地动态完成此操作:
from functools import partial

train_dataset.set_transform(partial(transform_start_field, freq=freq))
test_dataset.set_transform(partial(transform_start_field, freq=freq))
定义模型
接下来,让我们实例化一个模型。该模型将从零开始训练,因此我们在这里不会使用 from_pretrained 方法,而是从 config 随机初始化模型。
我们为模型指定几个额外参数:
prediction_length(在我们的例子中是24个月):这是 Transformer 的解码器将学习预测的视野;context_length:如果没有指定context_length,模型会将context_length(编码器的输入)设置为等于prediction_length;- 给定频率的
lags:这些指定了我们“回看”多少,以作为额外特征添加。例如,对于Daily频率,我们可能考虑回看[1, 2, 7, 30, ...],或者换句话说回看 1、2、……天,而对于Minute数据,我们可能考虑[1, 30, 60, 60*24, ...]等; - 时间特征的数量:在我们的例子中,这将是
2,因为我们将添加MonthOfYear和Age特征; - 静态分类特征的数量:在我们的例子中,这将是
1,因为我们将添加一个单一的“时间序列 ID”特征; - 基数:每个静态分类特征的值数量,作为一个列表,在我们的例子中将是
[366],因为我们有 366 个不同的时间序列 - 嵌入维度:每个静态分类特征的嵌入维度,作为一个列表,例如
[3]表示模型将为366个时间序列(区域)中的每一个学习一个大小为3的嵌入向量。
让我们使用 GluonTS 为给定频率(“monthly”)提供的默认滞后:
from gluonts.time_feature import get_lags_for_frequency

lags_sequence = get_lags_for_frequency(freq)
print(lags_sequence)

>>> [1, 2, 3, 4, 5, 6, 7, 11, 12, 13, 23, 24, 25, 35, 36, 37]
这意味着我们将为每个时间步回看最多 37 个月,作为额外特征。
让我们也检查一下 GluonTS 提供给我们的默认时间特征:
from gluonts.time_feature import time_features_from_frequency_str

time_features = time_features_from_frequency_str(freq)
print(time_features)

>>> [<function month_of_year at 0x7fa496d0ca70>]
在这种情况下,只有一个特征,即“一年中的月份”。这意味着对于每个时间步,我们将添加月份作为标量值(例如,如果时间戳是“january”,则为 1;如果时间戳是“february”,则为 2,等等)。
我们现在拥有定义模型所需的一切:
from transformers import TimeSeriesTransformerConfig, TimeSeriesTransformerForPrediction

config = TimeSeriesTransformerConfig(
    prediction_length=prediction_length,
    # context length:
    context_length=prediction_length * 2,
    # lags coming from helper given the freq:
    lags_sequence=lags_sequence,
    # we'll add 2 time features ("month of year" and "age", see further):
    num_time_features=len(time_features) + 1,
    # we have a single static categorical feature, namely time series ID:
    num_static_categorical_features=1,
    # it has 366 possible values:
    cardinality=[len(train_dataset)],
    # the model will learn an embedding of size 2 for each of the 366 possible values:
    embedding_dimension=[2],

    # transformer params:
    encoder_layers=4,
    decoder_layers=4,
    d_model=32,
)

model = TimeSeriesTransformerForPrediction(config)
请注意,与 🤗 Transformers 库中的其他模型类似,TimeSeriesTransformerModel 对应于没有任何头部的编码器-解码器 Transformer,而 TimeSeriesTransformerForPrediction 对应于在顶部带有分布头的 TimeSeriesTransformerModel。默认情况下,模型使用 Student-t 分布(但这是可配置的):
model.config.distribution_output

>>> student_t
这与 NLP 中的 Transformer 有一个重要区别:在 NLP 中,头部通常由一个固定的分类分布组成,通过一个 nn.Linear 层实现。
定义变换
接下来,我们为数据定义变换,特别是用于创建时间特征(基于数据集或通用特征)。
同样,我们将使用 GluonTS 库来实现这一点。我们定义一个 Chain 变换(这有点类似于图像中的 torchvision.transforms.Compose)。它允许我们将多个变换组合成一个单一的管道。
from gluonts.time_feature import (
    time_features_from_frequency_str,
    TimeFeature,
    get_lags_for_frequency,
)
from gluonts.dataset.field_names import FieldName
from gluonts.transform import (
    AddAgeFeature,
    AddObservedValuesIndicator,
    AddTimeFeatures,
    AsNumpyArray,
    Chain,
    ExpectedNumInstanceSampler,
    InstanceSplitter,
    RemoveFields,
    SelectFields,
    SetField,
    TestSplitSampler,
    Transformation,
    ValidationSplitSampler,
    VstackFeatures,
    RenameFields,
)
下面的变换附有注释,以解释它们的作用。在高层次上,我们将遍历数据集中各个时间序列,并添加/删除字段或特征:
from transformers import PretrainedConfig

def create_transformation(freq: str, config: PretrainedConfig) -> Transformation:
    remove_field_names = []
    if config.num_static_real_features == 0:
        remove_field_names.append(FieldName.FEAT_STATIC_REAL)
    if config.num_dynamic_real_features == 0:
        remove_field_names.append(FieldName.FEAT_DYNAMIC_REAL)
    if config.num_static_categorical_features == 0:
        remove_field_names.append(FieldName.FEAT_STATIC_CAT)

    # a bit like torchvision.transforms.Compose
    return Chain(
        # step 1: remove static/dynamic fields if not specified
        [RemoveFields(field_names=remove_field_names)]
        # step 2: convert the data to NumPy (potentially not needed)
        + (
            [
                AsNumpyArray(
                    field=FieldName.FEAT_STATIC_CAT,
                    expected_ndim=1,
                    dtype=int,
                )
            ]
            if config.num_static_categorical_features > 0
            else []
        )
        + (
            [
                AsNumpyArray(
                    field=FieldName.FEAT_STATIC_REAL,
                    expected_ndim=1,
                )
            ]
            if config.num_static_real_features > 0
            else []
        )
        + [
            AsNumpyArray(
                field=FieldName.TARGET,
                # we expect an extra dim for the multivariate case:
                expected_ndim=1 if config.input_size == 1 else 2,
            ),
            # step 3: handle the NaN's by filling in the target with zero
            # and return the mask (which is in the observed values)
            # true for observed values, false for nan's
            # the decoder uses this mask (no loss is incurred for unobserved values)
            # see loss_weights inside the xxxForPrediction model
            AddObservedValuesIndicator(
                target_field=FieldName.TARGET,
                output_field=FieldName.OBSERVED_VALUES,
            ),
            # step 4: add temporal features based on freq of the dataset
            # month of year in the case when freq="M"
            # these serve as positional encodings
            AddTimeFeatures(
                start_field=FieldName.START,
                target_field=FieldName.TARGET,
                output_field=FieldName.FEAT_TIME,
                time_features=time_features_from_frequency_str(freq),
                pred_length=config.prediction_length,
            ),
            # step 5: add another temporal feature (just a single number)
            # tells the model where in its life the value of the time series is,
            # sort of a running counter
            AddAgeFeature(
                target_field=FieldName.TARGET,
                output_field=FieldName.FEAT_AGE,
                pred_length=config.prediction_length,
                log_scale=True,
            ),
            # step 6: vertically stack all the temporal features into the key FEAT_TIME
            VstackFeatures(
                output_field=FieldName.FEAT_TIME,
                input_fields=[FieldName.FEAT_TIME, FieldName.FEAT_AGE]
                + (
                    [FieldName.FEAT_DYNAMIC_REAL]
                    if config.num_dynamic_real_features > 0
                    else []
                ),
            ),
            # step 7: rename to match HuggingFace names
            RenameFields(
                mapping={
                    FieldName.FEAT_STATIC_CAT: "static_categorical_features",
                    FieldName.FEAT_STATIC_REAL: "static_real_features",
                    FieldName.FEAT_TIME: "time_features",
                    FieldName.TARGET: "values",
                    FieldName.OBSERVED_VALUES: "observed_mask",
                }
            ),
        ]
    )
定义 InstanceSplitter
对于训练/验证/测试,我们接下来创建一个 InstanceSplitter,用于从数据集中采样窗口(请记住,由于时间和内存限制,我们无法将整个历史值传递给 Transformer)。
实例分割器从数据中随机采样 context_length 大小的窗口和随后的 prediction_length 大小的窗口,并为相应窗口的 time_series_fields 中的任何时间键附加 past_ 或 future_ 键。实例分割器可以配置为三种不同的模式:
mode="train":这里我们从提供给它的数据集(训练数据集)中随机采样上下文和预测长度窗口mode="validation":这里我们从提供给它的数据集中采样最后一个上下文长度窗口和预测窗口(用于回测或验证似然计算)mode="test":这里我们仅采样最后一个上下文长度窗口(用于预测用例)
from gluonts.transform.sampler import InstanceSampler
from typing import Optional

def create_instance_splitter(
    config: PretrainedConfig,
    mode: str,
    train_sampler: Optional[InstanceSampler] = None,
    validation_sampler: Optional[InstanceSampler] = None,
) -> Transformation:
    assert mode in ["train", "validation", "test"]

    instance_sampler = {
        "train": train_sampler
        or ExpectedNumInstanceSampler(
            num_instances=1.0, min_future=config.prediction_length
        ),
        "validation": validation_sampler
        or ValidationSplitSampler(min_future=config.prediction_length),
        "test": TestSplitSampler(),
    }[mode]

    return InstanceSplitter(
        target_field="values",
        is_pad_field=FieldName.IS_PAD,
        start_field=FieldName.START,
        forecast_start_field=FieldName.FORECAST_START,
        instance_sampler=instance_sampler,
        past_length=config.context_length + max(config.lags_sequence),
        future_length=config.prediction_length,
        time_series_fields=["time_features", "observed_mask"],
    )
创建 DataLoaders
接下来,是时候创建 DataLoaders 了,它允许我们获得(输入,输出)对的批次——或者换句话说(past_values,future_values)。
from typing import Iterable

import torch
from gluonts.itertools import Cached, Cyclic
from gluonts.dataset.loader import as_stacked_batches


def create_train_dataloader(
    config: PretrainedConfig,
    freq,
    data,
    batch_size: int,
    num_batches_per_epoch: int,
    shuffle_buffer_length: Optional[int] = None,
    cache_data: bool = True,
    **kwargs,
) -> Iterable:
    PREDICTION_INPUT_NAMES = [
        "past_time_features",
        "past_values",
        "past_observed_mask",
        "future_time_features",
    ]
    if config.num_static_categorical_features > 0:
        PREDICTION_INPUT_NAMES.append("static_categorical_features")

    if config.num_static_real_features > 0:
        PREDICTION_INPUT_NAMES.append("static_real_features")

    TRAINING_INPUT_NAMES = PREDICTION_INPUT_NAMES + [
        "future_values",
        "future_observed_mask",
    ]

    transformation = create_transformation(freq, config)
    transformed_data = transformation.apply(data, is_train=True)
    if cache_data:
        transformed_data = Cached(transformed_data)

    # we initialize a Training instance
    instance_splitter = create_instance_splitter(config, "train")

    # the instance splitter will sample a window of
    # context length + lags + prediction length (from the 366 possible transformed time series)
    # randomly from within the target time series and return an iterator.
    stream = Cyclic(transformed_data).stream()
    training_instances = instance_splitter.apply(stream)

    return as_stacked_batches(
        training_instances,
        batch_size=batch_size,
        shuffle_buffer_length=shuffle_buffer_length,
        field_names=TRAINING_INPUT_NAMES,
        output_type=torch.tensor,
        num_batches_per_epoch=num_batches_per_epoch,
    )
def create_backtest_dataloader(
    config: PretrainedConfig,
    freq,
    data,
    batch_size: int,
    **kwargs,
):
    PREDICTION_INPUT_NAMES = [
        "past_time_features",
        "past_values",
        "past_observed_mask",
        "future_time_features",
    ]
    if config.num_static_categorical_features > 0:
        PREDICTION_INPUT_NAMES.append("static_categorical_features")

    if config.num_static_real_features > 0:
        PREDICTION_INPUT_NAMES.append("static_real_features")

    transformation = create_transformation(freq, config)
    transformed_data = transformation.apply(data)

    # we create a Validation Instance splitter which will sample the very last
    # context window seen during training only for the encoder.
    instance_sampler = create_instance_splitter(config, "validation")

    # we apply the transformations in train mode
    testing_instances = instance_sampler.apply(transformed_data, is_train=True)

    return as_stacked_batches(
        testing_instances,
        batch_size=batch_size,
        output_type=torch.tensor,
        field_names=PREDICTION_INPUT_NAMES,
    )
我们有一个测试数据加载器辅助工具用于完成,尽管我们在这里不会使用它。这在生产环境中很有用,我们希望从给定时间序列的末尾开始预测。因此,测试数据加载器将从提供的数据集中采样最后一个上下文窗口,并将其传递给模型。
def create_test_dataloader(
    config: PretrainedConfig,
    freq,
    data,
    batch_size: int,
    **kwargs,
):
    PREDICTION_INPUT_NAMES = [
        "past_time_features",
        "past_values",
        "past_observed_mask",
        "future_time_features",
    ]
    if config.num_static_categorical_features > 0:
        PREDICTION_INPUT_NAMES.append("static_categorical_features")

    if config.num_static_real_features > 0:
        PREDICTION_INPUT_NAMES.append("static_real_features")

    transformation = create_transformation(freq, config)
    transformed_data = transformation.apply(data, is_train=False)

    # We create a test Instance splitter to sample the very last
    # context window from the dataset provided.
    instance_sampler = create_instance_splitter(config, "test")

    # We apply the transformations in test mode
    testing_instances = instance_sampler.apply(transformed_data, is_train=False)

    return as_stacked_batches(
        testing_instances,
        batch_size=batch_size,
        output_type=torch.tensor,
        field_names=PREDICTION_INPUT_NAMES,
    )
train_dataloader = create_train_dataloader(
    config=config,
    freq=freq,
    data=train_dataset,
    batch_size=256,
    num_batches_per_epoch=100,
)

test_dataloader = create_backtest_dataloader(
    config=config,
    freq=freq,
    data=test_dataset,
    batch_size=64,
)
让我们检查第一个批次:
batch = next(iter(train_dataloader))
for k, v in batch.items():
    print(k, v.shape, v.type())

>>> past_time_features torch.Size([256, 85, 2]) torch.FloatTensor
    past_values torch.Size([256, 85]) torch.FloatTensor
    past_observed_mask torch.Size([256, 85]) torch.FloatTensor
    future_time_features torch.Size([256, 24, 2]) torch.FloatTensor
    static_categorical_features torch.Size([256, 1]) torch.LongTensor
    future_values torch.Size([256, 24]) torch.FloatTensor
    future_observed_mask torch.Size([256, 24]) torch.FloatTensor
如所见,我们不将 input_ids 和 attention_mask 馈送到编码器(就像 NLP 模型那样),而是馈送 past_values,以及 past_observed_mask、past_time_features 和 static_categorical_features。
解码器输入包括 future_values、future_observed_mask 和 future_time_features。future_values 可以看作相当于 NLP 中的 decoder_input_ids。
我们参考 文档 以获取每个的详细解释。
前向传播
让我们用刚刚创建的批次执行一次前向传播:
# perform forward pass
outputs = model(
    past_values=batch["past_values"],
    past_time_features=batch["past_time_features"],
    past_observed_mask=batch["past_observed_mask"],
    static_categorical_features=batch["static_categorical_features"]
    if config.num_static_categorical_features > 0
    else None,
    static_real_features=batch["static_real_features"]
    if config.num_static_real_features > 0
    else None,
    future_values=batch["future_values"],
    future_time_features=batch["future_time_features"],
    future_observed_mask=batch["future_observed_mask"],
    output_hidden_states=True,
)
print("Loss:", outputs.loss.item())

>>> Loss: 9.069628715515137
注意,模型返回了一个损失。这是可能的,因为解码器自动将 future_values 向右移动一个位置以获得标签。这允许计算预测值与标签之间的损失。
另外,注意解码器使用因果掩码来不查看未来,因为它需要预测的值在 future_values 张量中。
训练模型
是时候训练模型了!我们将使用标准的 PyTorch 训练循环。
我们将在这里使用 🤗 Accelerate 库,它会自动将模型、优化器和数据加载器放置在适当的 device 上。
from accelerate import Accelerator
from torch.optim import AdamW

accelerator = Accelerator()
device = accelerator.device

model.to(device)
optimizer = AdamW(model.parameters(), lr=6e-4, betas=(0.9, 0.95), weight_decay=1e-1)

model, optimizer, train_dataloader = accelerator.prepare(
    model,
    optimizer,
    train_dataloader,
)

model.train()
for epoch in range(40):
    for idx, batch in enumerate(train_dataloader):
        optimizer.zero_grad()
        outputs = model(
            static_categorical_features=batch["static_categorical_features"].to(device)
            if config.num_static_categorical_features > 0
            else None,
            static_real_features=batch["static_real_features"].to(device)
            if config.num_static_real_features > 0
            else None,
            past_time_features=batch["past_time_features"].to(device),
            past_values=batch["past_values"].to(device),
            future_time_features=batch["future_time_features"].to(device),
            future_values=batch["future_values"].to(device),
            past_observed_mask=batch["past_observed_mask"].to(device),
            future_observed_mask=batch["future_observed_mask"].to(device),
        )
        loss = outputs.loss

        # Backpropagation
        accelerator.backward(loss)
        optimizer.step()

        if idx % 100 == 0:
            print(loss.item())
推理
在推理时,建议使用 generate() 方法进行自回归生成,类似于 NLP 模型。
预测涉及从测试实例采样器中获取数据,该采样器将从数据集中的每个时间序列中采样最后一个大小为context_length的窗口值,并将其传递给模型。请注意,我们将提前已知的future_time_features传递给解码器。
模型将自回归地从预测分布中采样一定数量的值,并将它们传回解码器以返回预测输出:
model.eval()

forecasts = []

for batch in test_dataloader:
    outputs = model.generate(
        static_categorical_features=batch["static_categorical_features"].to(device)
        if config.num_static_categorical_features > 0
        else None,
        static_real_features=batch["static_real_features"].to(device)
        if config.num_static_real_features > 0
        else None,
        past_time_features=batch["past_time_features"].to(device),
        past_values=batch["past_values"].to(device),
        future_time_features=batch["future_time_features"].to(device),
        past_observed_mask=batch["past_observed_mask"].to(device),
    )
    forecasts.append(outputs.sequences.cpu().numpy())
模型输出一个形状为(batch_size, number of samples, prediction length)的张量。
在这种情况下,我们得到未来24个月的100个可能值(对于批次中的每个示例,其大小为64):
forecasts[0].shape

>>> (64, 100, 24)
我们将它们垂直堆叠,以获得测试数据集中所有时间序列的预测:
forecasts = np.vstack(forecasts)
print(forecasts.shape)

>>> (366, 100, 24)
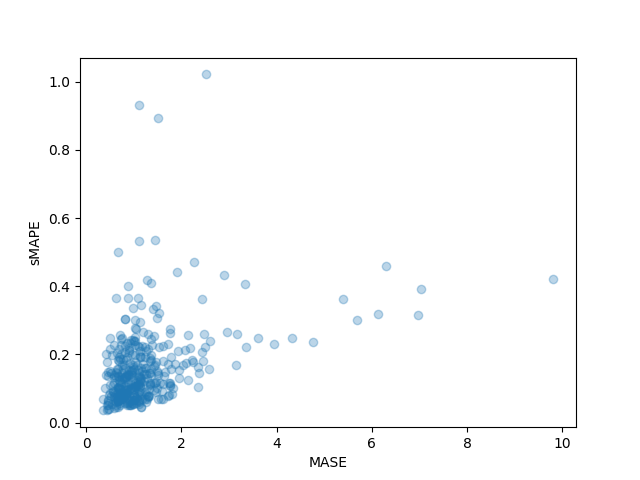
我们可以根据测试集中存在的样本外真实值来评估生成的预测。我们将使用MASE和sMAPE指标,这些指标是为数据集中的每个时间序列计算的:
from evaluate import load
from gluonts.time_feature import get_seasonality

mase_metric = load("evaluate-metric/mase")
smape_metric = load("evaluate-metric/smape")

forecast_median = np.median(forecasts, 1)

mase_metrics = []
smape_metrics = []
for item_id, ts in enumerate(test_dataset):
    training_data = ts["target"][:-prediction_length]
    ground_truth = ts["target"][-prediction_length:]
    mase = mase_metric.compute(
        predictions=forecast_median[item_id],
        references=np.array(ground_truth),
        training=np.array(training_data),
        periodicity=get_seasonality(freq))
    mase_metrics.append(mase["mase"])

    smape = smape_metric.compute(
        predictions=forecast_median[item_id],
        references=np.array(ground_truth),
    )
    smape_metrics.append(smape["smape"])
print(f"MASE: {np.mean(mase_metrics)}")

>>> MASE: 1.2564196892177717

print(f"sMAPE: {np.mean(smape_metrics)}")

>>> sMAPE: 0.1609541520852549
我们还可以绘制数据集中每个时间序列的单独指标,并观察到少数时间序列对最终测试指标的贡献很大:
plt.scatter(mase_metrics, smape_metrics, alpha=0.3)
plt.xlabel("MASE")
plt.ylabel("sMAPE")
plt.show()
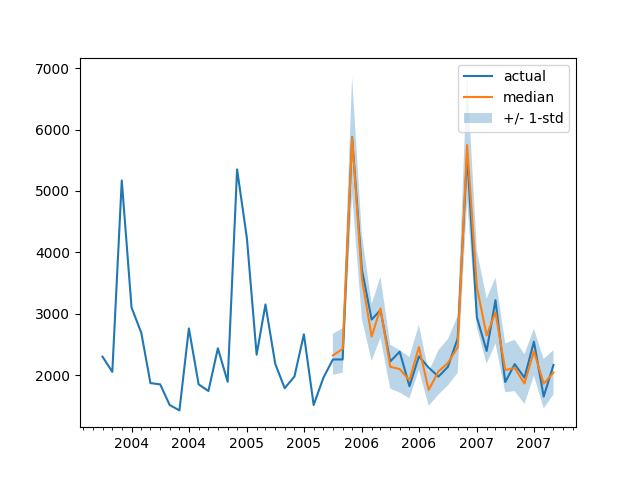
为了绘制任何时间序列相对于真实测试数据的预测,我们定义以下辅助函数:
import matplotlib.dates as mdates

def plot(ts_index):
    fig, ax = plt.subplots()

    index = pd.period_range(
        start=test_dataset[ts_index][FieldName.START],
        periods=len(test_dataset[ts_index][FieldName.TARGET]),
        freq=freq,
    ).to_timestamp()

    # Major ticks every half year, minor ticks every month,
    ax.xaxis.set_major_locator(mdates.MonthLocator(bymonth=(1, 7)))
    ax.xaxis.set_minor_locator(mdates.MonthLocator())

    ax.plot(
        index[-2*prediction_length:],
        test_dataset[ts_index]["target"][-2*prediction_length:],
        label="actual",
    )

    plt.plot(
        index[-prediction_length:],
        np.median(forecasts[ts_index], axis=0),
        label="median",
    )

    plt.fill_between(
        index[-prediction_length:],
        forecasts[ts_index].mean(0) - forecasts[ts_index].std(axis=0),
        forecasts[ts_index].mean(0) + forecasts[ts_index].std(axis=0),
        alpha=0.3,
        interpolate=True,
        label="+/- 1-std",
    )
    plt.legend()
    plt.show()
例如:
plot(334)
我们如何与其他模型进行比较?Monash时间序列库有一个测试集MASE指标的比较表,我们可以添加进去:
| 数据集 | SES | Theta | TBATS | ETS | (DHR-)ARIMA | PR | CatBoost | FFNN | DeepAR | N-BEATS | WaveNet | Transformer(我们的) |
|---|---|---|---|---|---|---|---|---|---|---|---|---|
| 旅游月度 | 3.306 | 1.649 | 1.751 | 1.526 | 1.589 | 1.678 | 1.699 | 1.582 | 1.409 | 1.574 | 1.482 | 1.256 |
请注意,使用我们的模型,我们击败了所有其他报告的模型(另见相应论文中的表2),而且我们没有进行任何超参数调整。我们只是训练了Transformer 40个epoch。
当然,我们需要谨慎地仅凭神经网络就声称在时间序列上取得了最先进的结果,因为似乎“XGBoost通常就是你所需要的”。我们只是非常好奇神经网络能带我们走多远,以及Transformer在这个领域是否有用。这个特定的数据集似乎表明它绝对值得探索。
下一步
我们鼓励读者尝试使用Hub中的其他时间序列数据集运行notebook,并替换相应的频率和预测长度参数。对于您的数据集,需要将它们转换为GluonTS使用的约定,这在其文档此处中有很好的解释。我们还准备了一个示例notebook,向您展示如何将数据集转换为🤗 datasets格式,此处。
正如时间序列研究人员所知,将基于Transformer的模型应用于时间序列问题引起了广泛兴趣。原始Transformer只是众多基于注意力的模型之一,因此需要向库中添加更多模型。
目前没有什么阻止我们对多变量时间序列进行建模,但为此需要使用多变量分布头来实例化模型。目前支持对角独立分布,其他多变量分布也将添加。请关注未来的博客文章,其中将包含教程。
路线图上的另一件事是时间序列分类。这需要向库中添加一个带有分类头的时间序列模型,例如用于异常检测任务。
当前模型假设存在日期时间以及时间序列值,而在现实中的每个时间序列可能并非如此。例如,像来自 WOODS 的神经科学数据集。因此,需要将当前模型泛化,使整个流程中的某些输入变为可选。
最后,NLP/视觉领域已从大型预训练模型中受益匪浅,而据我们所知,时间序列领域并非如此。基于 Transformer 的模型似乎是开展这一研究方向的不二之选,我们迫不及待想看到研究人员和从业者会带来什么!
来源:Hugging Face:Blog · huggingface.co