Hugging Face 分享用 Dreambooth 微调 Stable Diffusion 的实验结论与调参建议
Training Stable Diffusion with Dreambooth using Diffusers
Hugging Face 发布教程,基于多组实验总结用 Dreambooth 微调 Stable Diffusion 的推荐设置,并提示 🧨 Diffusers 提供官方训练脚本。
原文基于多组实验给出 Dreambooth 微调 Stable Diffusion 的超参数建议,可帮助读者降低过拟合并提升生成质量。
Dreambooth 是一种通过特殊形式的微调向 Stable Diffusion 教授新概念的技术。有些人用它配合自己的几张照片将自己置于奇幻场景中,而另一些人则用它来融入新的风格。🧨 Diffusers 提供了一个 Dreambooth 训练脚本。训练不需要很长时间,但很难选择正确的超参数组合,而且很容易过拟合。
我们进行了大量实验来分析 Dreambooth 中不同设置的影响。本文介绍了我们的发现,以及一些在使用 Dreambooth 微调 Stable Diffusion 时改善结果的技巧。
在开始之前,请注意此方法绝不应被用于恶意目的、以任何方式造成伤害,或在他人不知情的情况下冒充他人。使用它训练的模型仍受 CreativeML Open RAIL-M 许可证的约束,该许可证管辖 Stable Diffusion 模型的分发。
注意:本文的早期版本曾以 W&B 报告的形式发布。
TL;DR:推荐设置
- Dreambooth 往往很快就会过拟合。要获得高质量图像,我们必须在训练步数和学习率之间找到一个“最佳平衡点”。我们建议使用较低的学习率,并逐步增加步数,直到结果令人满意。
- Dreambooth 对于人脸需要更多的训练步数。在我们的实验中,当批量大小为 2、学习率为 1e-6 时,800-1200 步效果良好。
- 先验保留对于在人脸上训练时避免过拟合很重要。对于其他主体,它似乎没有太大区别。
- 如果你看到生成的图像有噪点或质量下降,这很可能意味着过拟合。首先,尝试上述步骤来避免它。如果生成的图像仍然有噪点,请使用 DDIM 调度器或运行更多推理步数(在我们的实验中约 100 步效果良好)。
- 除了 UNet 之外还训练文本编码器对质量有很大影响。我们最好的结果是使用文本编码器微调、低学习率和适当步数的组合获得的。然而,微调文本编码器需要更多内存,因此至少具有 24 GB 内存的 GPU 是理想选择。使用 8-bit Adam、
fp16训练或梯度累积等技术,可以在 Google Colab 或 Kaggle 提供的 16 GB GPU 上进行训练。 - 使用或不使用 EMA 进行微调产生了相似的结果。
- 训练 Dreambooth 不需要使用
sks这个词。最早的实现之一使用它是因为它是词汇表中的罕见 token,但它实际上是一种步枪。我们的实验,以及例如 @nitrosocke 的实验表明,选择你自然会用来描述目标的术语是可以的。
学习率的影响
Dreambooth 过拟合得非常快。要获得良好结果,请以适合你的数据集的方式调整学习率和训练步数。在我们的实验(详见下文)中,我们使用高学习率和低学习率在四个不同的数据集上进行了微调。在所有情况下,我们都用低学习率获得了更好的结果。
实验设置
我们所有的实验都是使用 train_dreambooth.py 脚本,在 2 块 40GB A100 上使用 AdamW 优化器进行的。我们使用了相同的随机种子,并在各次运行中保持所有超参数一致,除了学习率、训练步数以及是否使用先验保持。
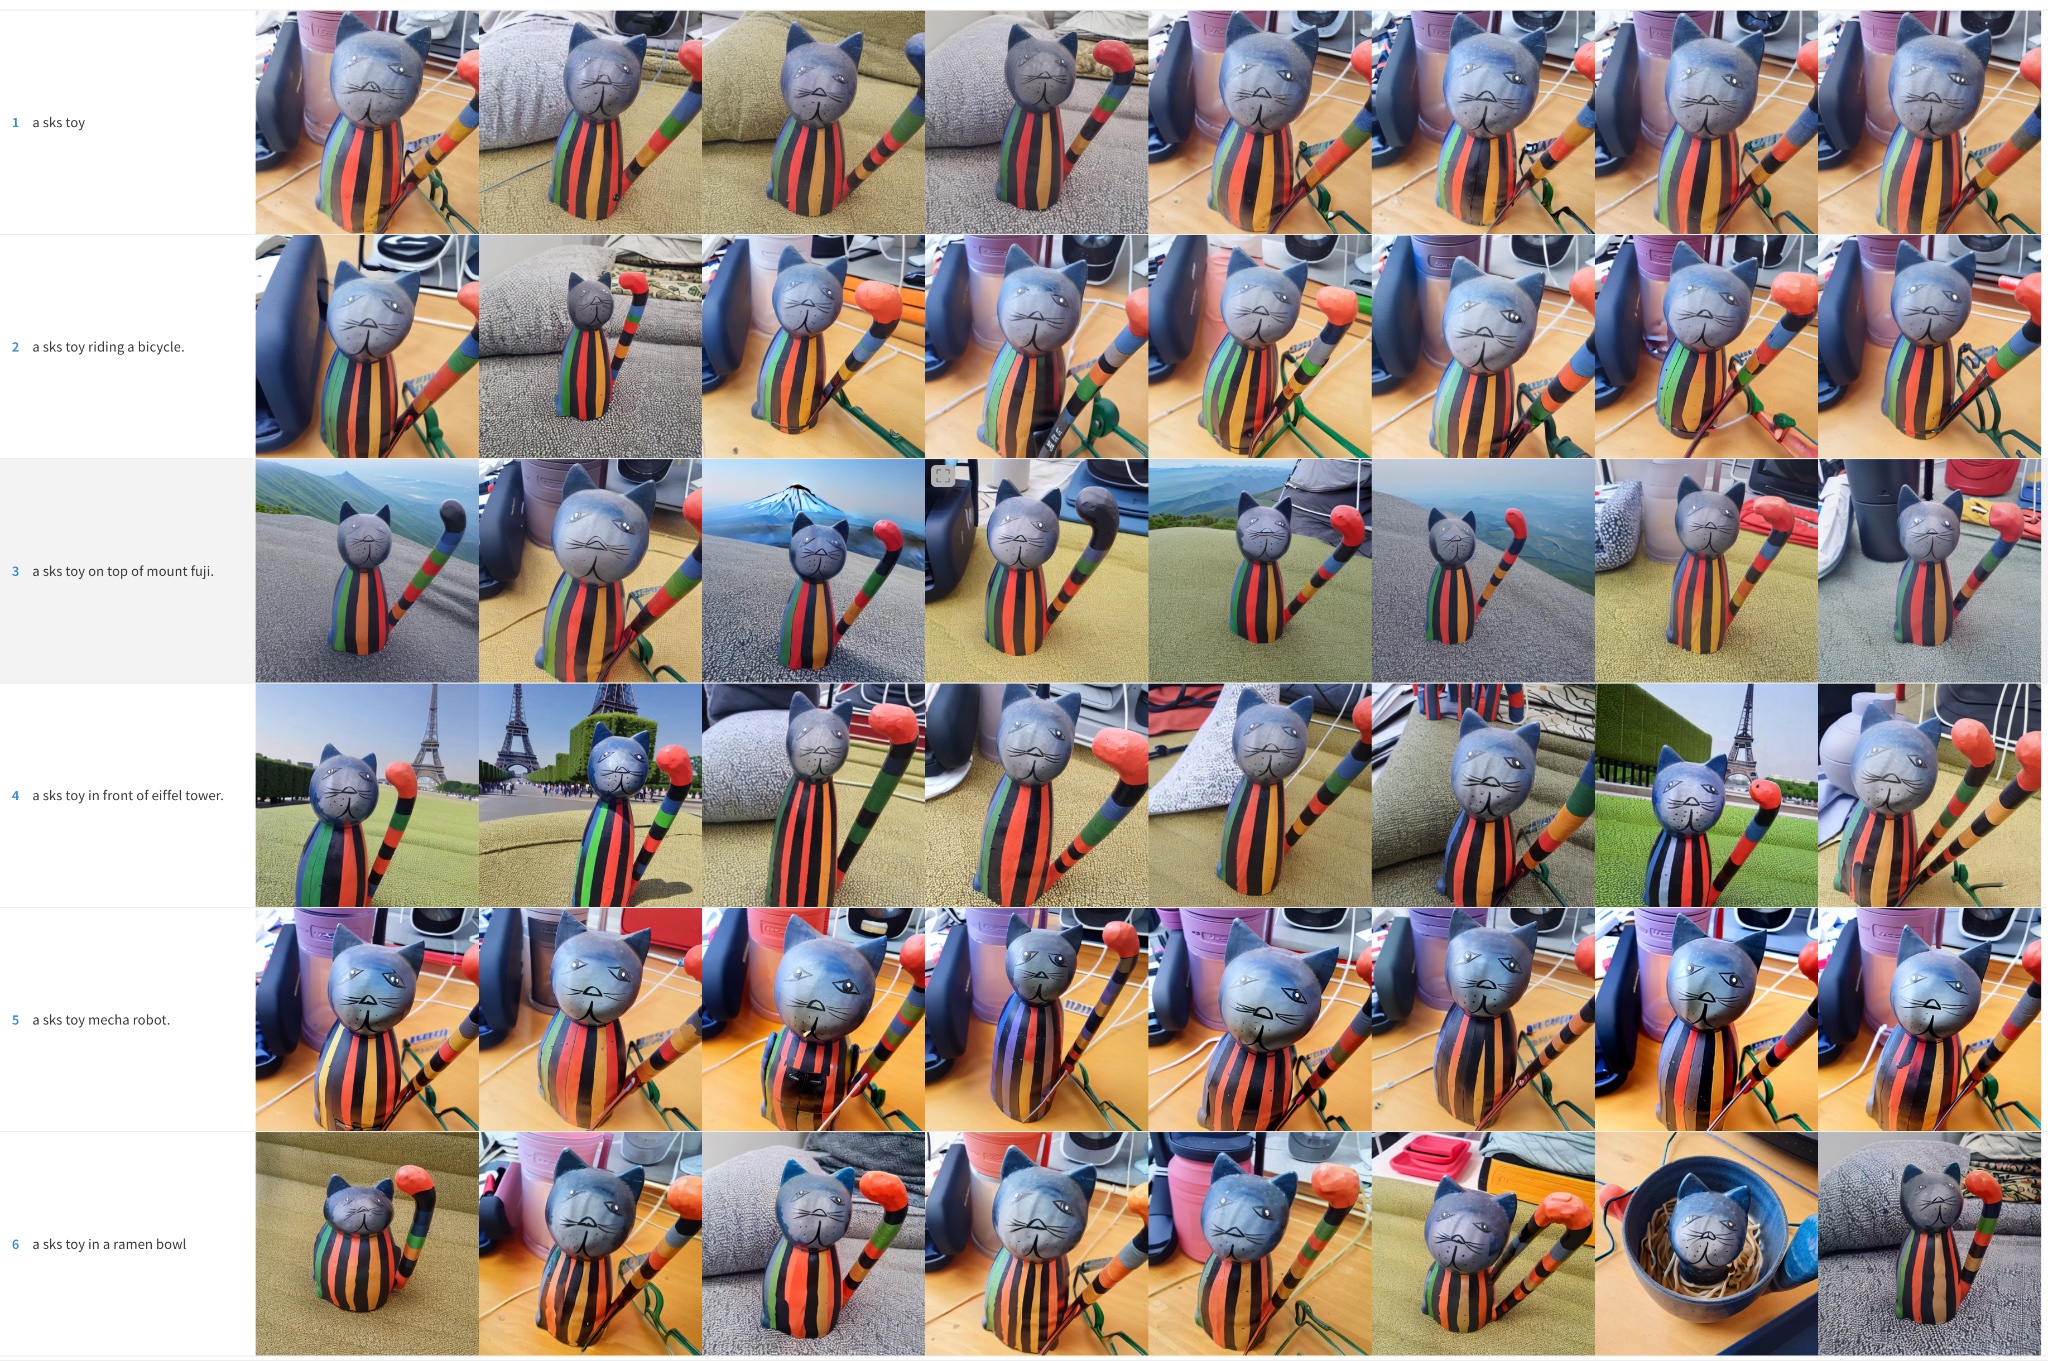
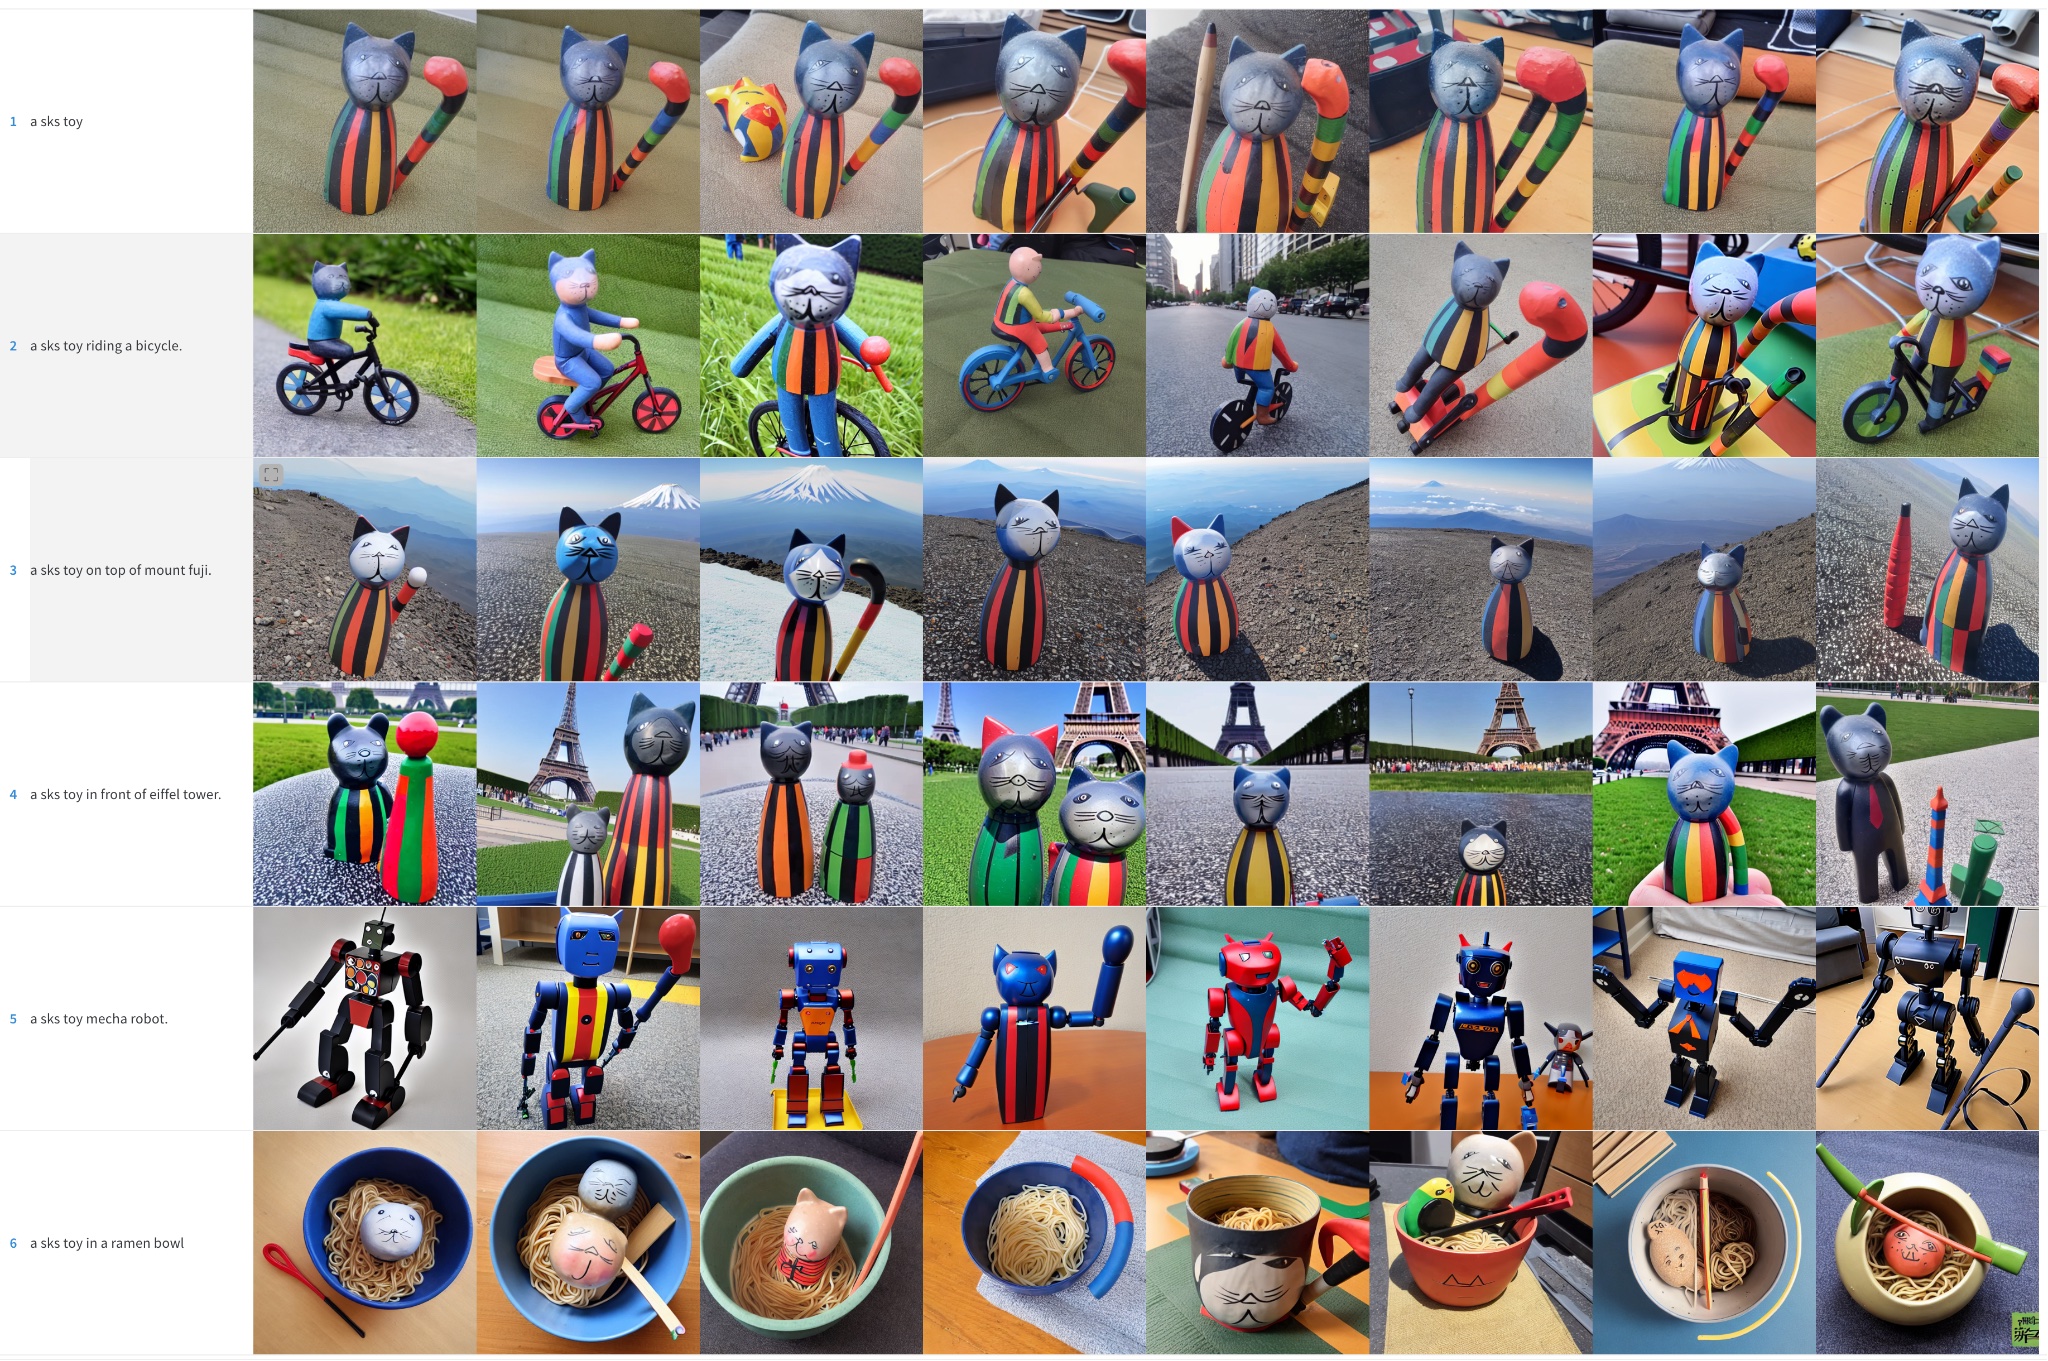
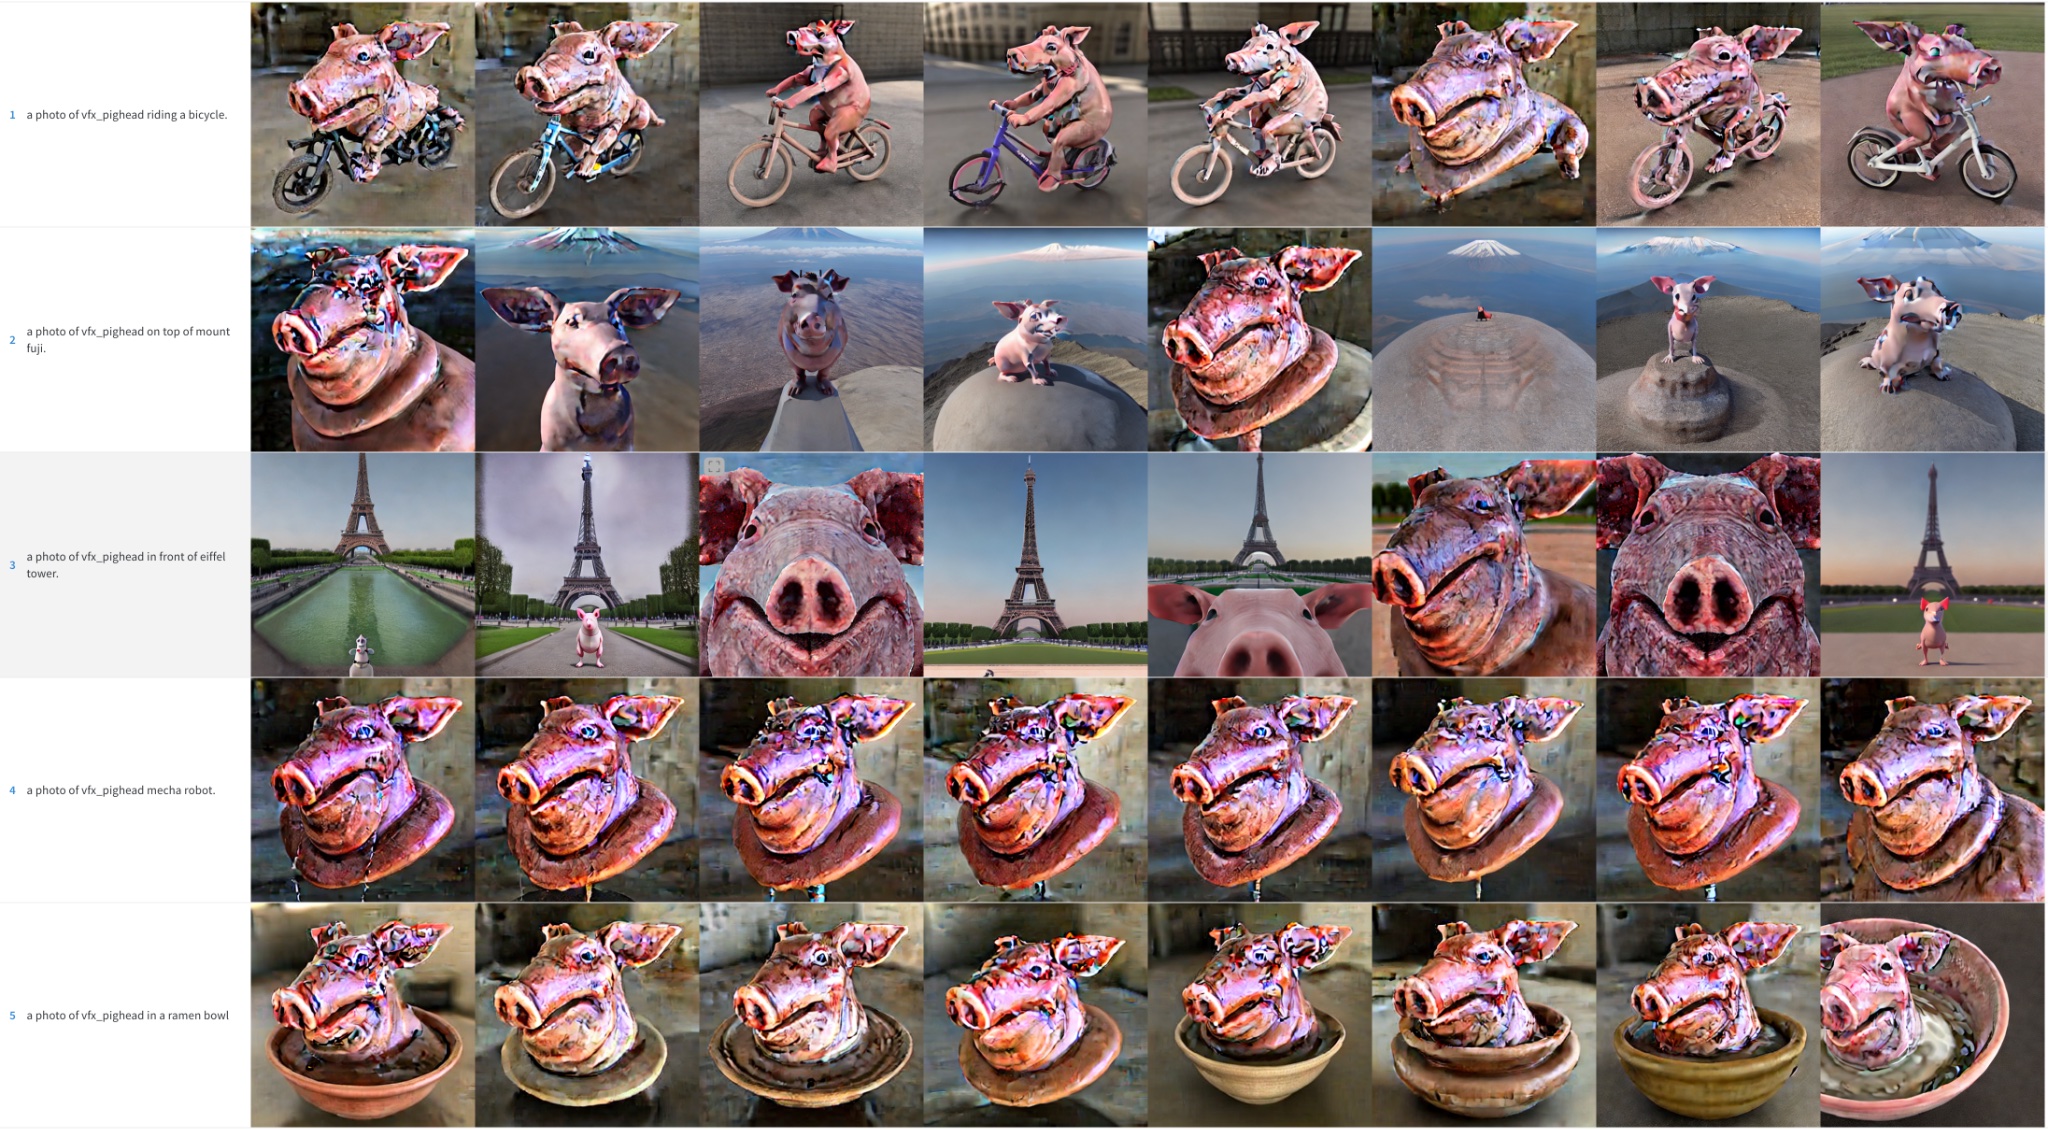
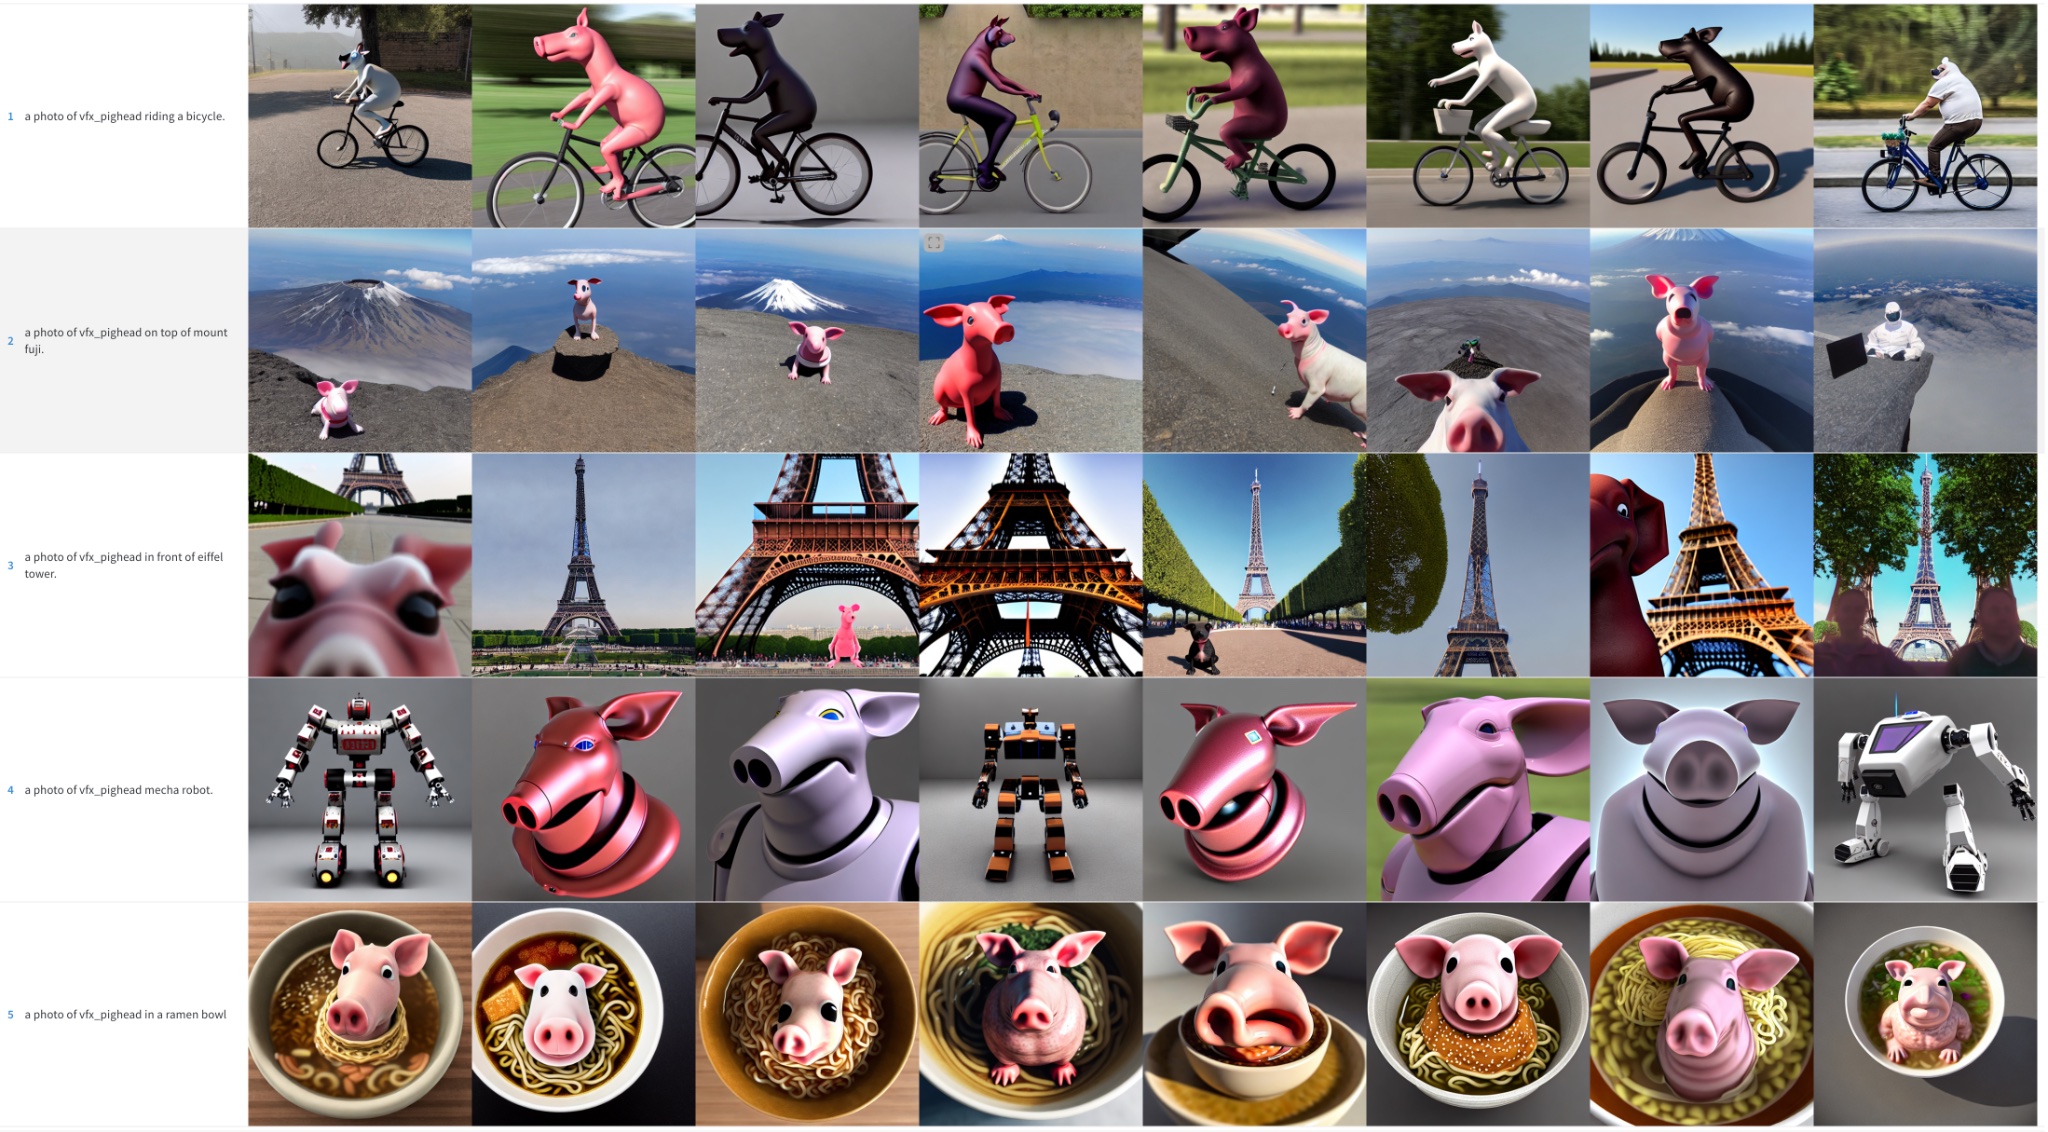
对于前 3 个示例(各种物体),我们以批量大小 4(每块 GPU 2 个)对模型进行了 400 步的微调。我们使用了高学习率 5e-6 和低学习率 2e-6。未使用先验保持。
最后一个实验尝试向模型中添加一个人类主体。我们使用了先验保持,批量大小为 2(每块 GPU 1 个),在这种情况下训练了 800 步和 1200 步。我们使用了高学习率 5e-6 和低学习率 2e-6。
请注意,你可以使用 8 位 Adam、fp16 训练或梯度累积来降低内存需求,并在具有 16 GB 内存的 GPU 上运行类似的实验。
猫玩具
高学习率(5e-6)
低学习率(2e-6)
猪头
高学习率(5e-6)。请注意,颜色伪影是噪声残留——运行更多推理步骤可能有助于解决其中一些细节。
低学习率(2e-6)
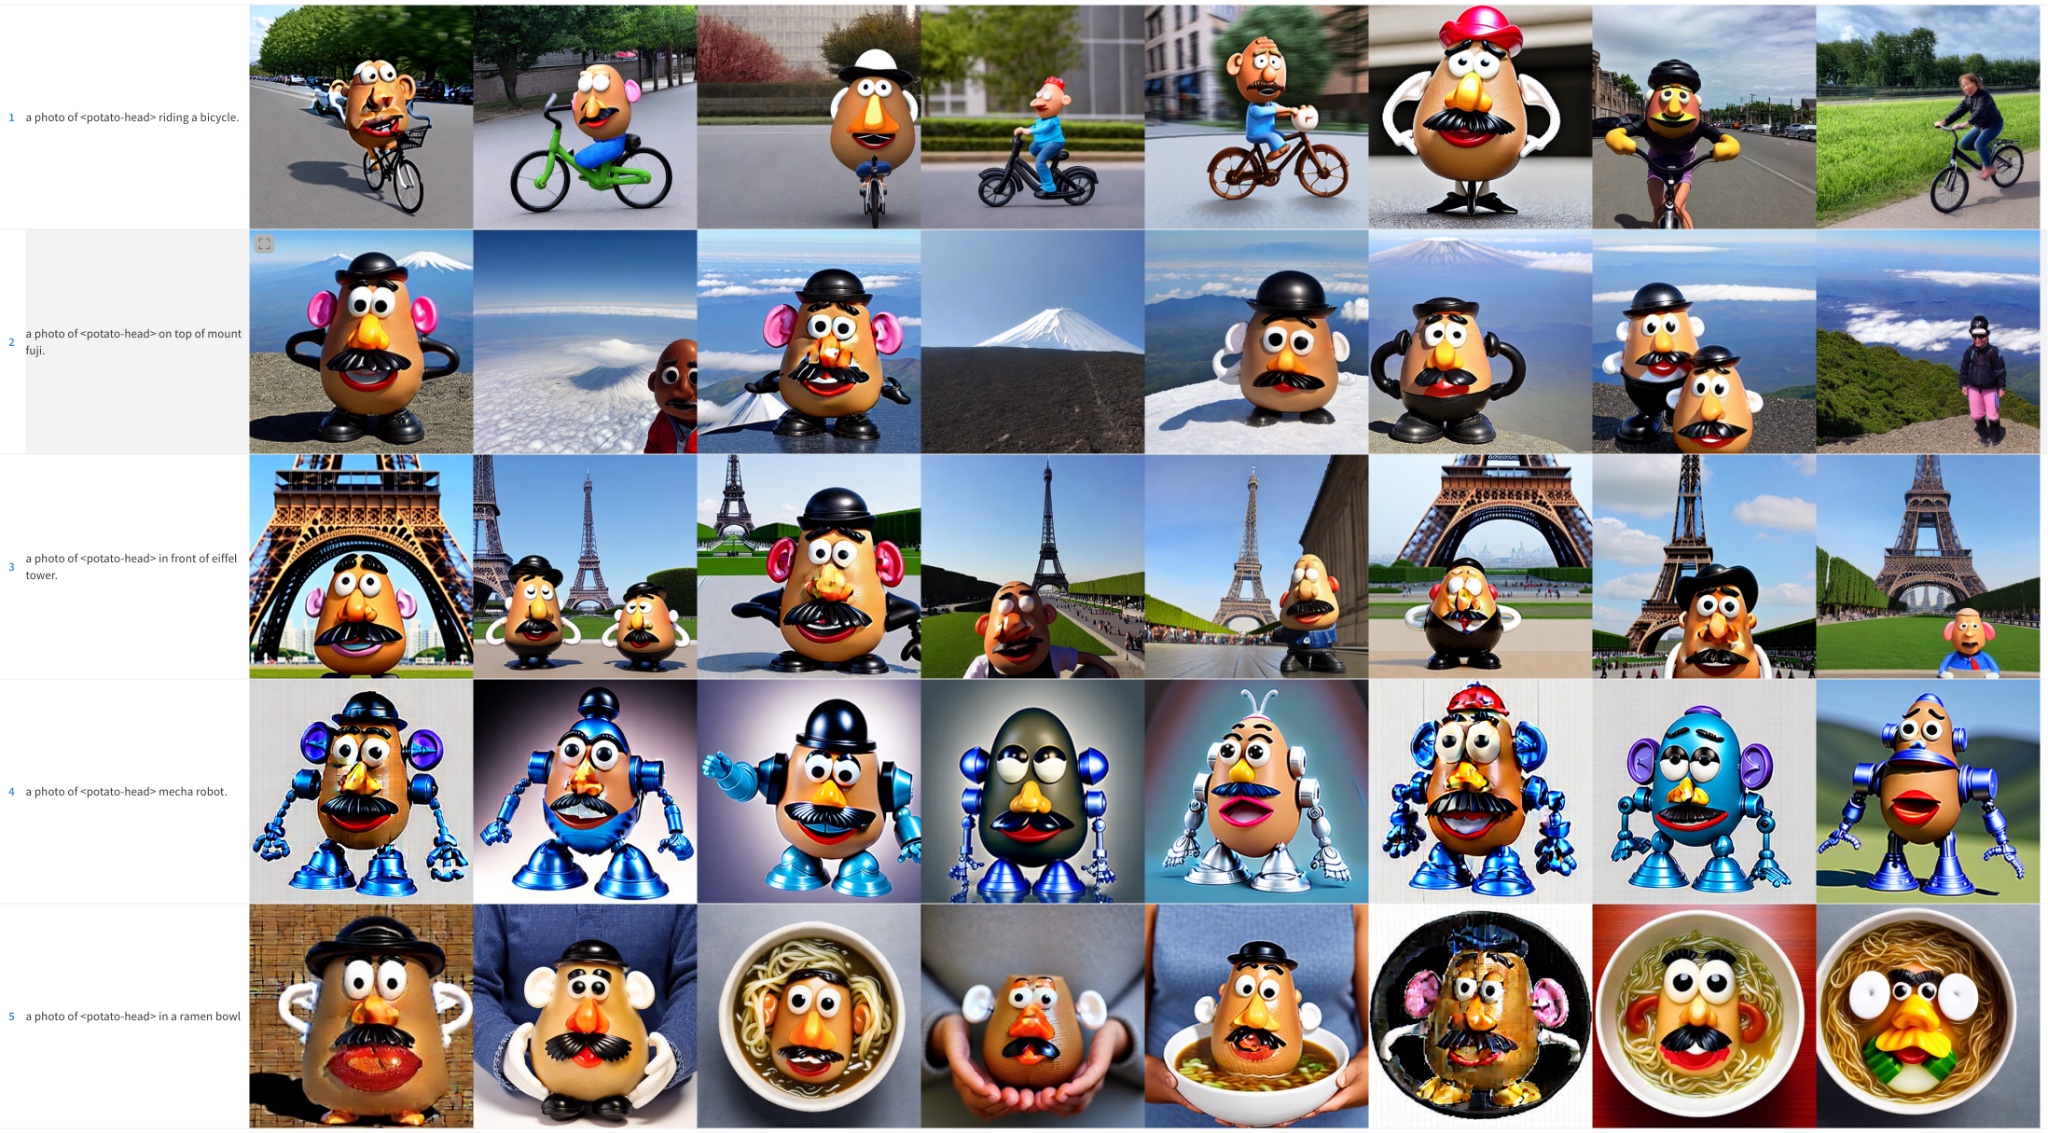
土豆头先生
高学习率(5e-6)。请注意,颜色伪影是噪声残留——运行更多推理步骤可能有助于解决其中一些细节。
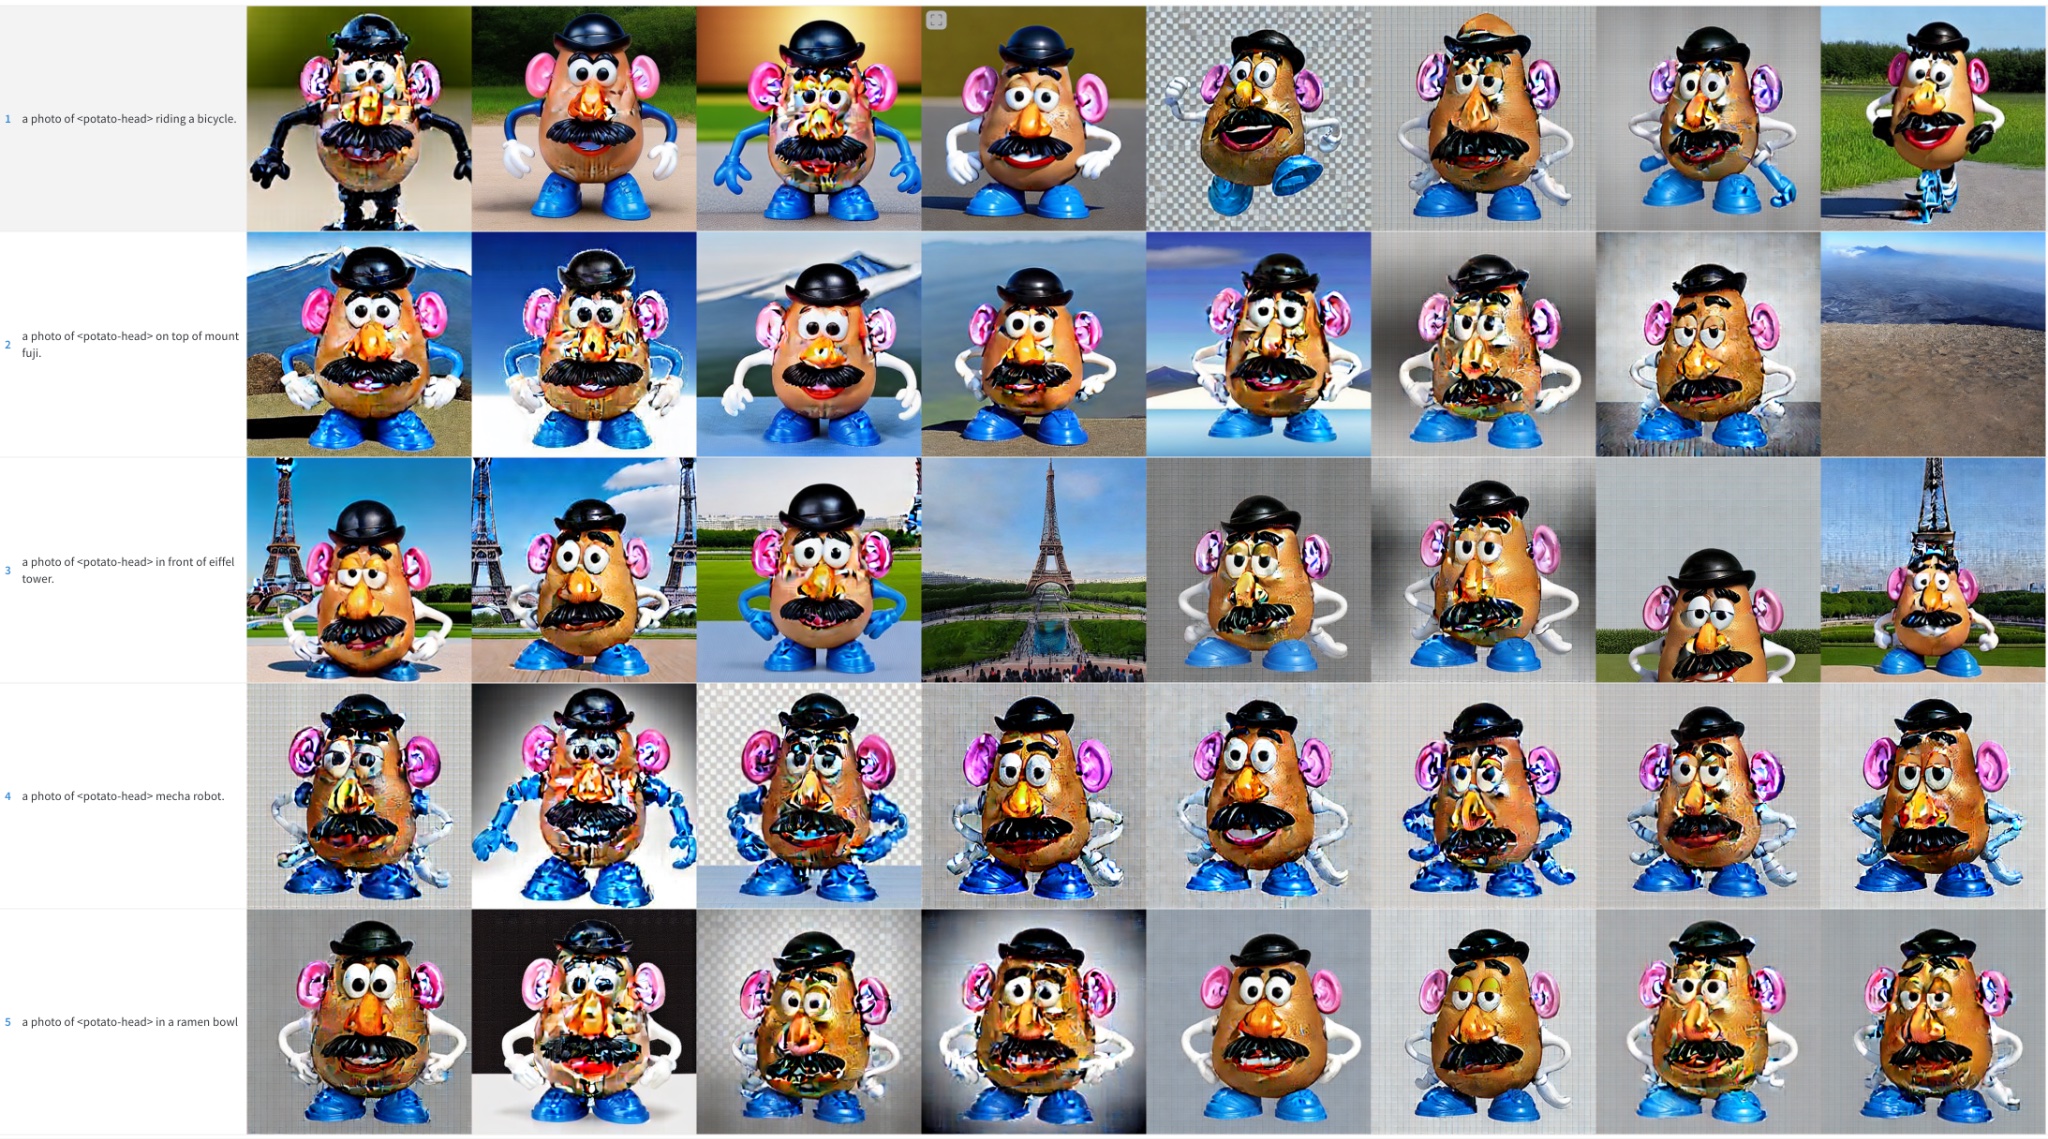
低学习率(2e-6)
人脸
我们尝试将《宋飞正传》中的克莱默角色融入 Stable Diffusion。如前所述,我们以较小的批量大小训练了更多步数。即便如此,结果也并不出色。为简洁起见,我们省略了这些示例图像,并将读者引向后续章节,在那里人脸训练成为我们工作的重点。
初步结果总结
要想使用 Dreambooth 训练 Stable Diffusion 并获得良好结果,针对你的数据集调整学习率和训练步数非常重要。
- 高学习率和过多的训练步数会导致过拟合。无论使用什么提示词,模型大多会生成来自你训练数据的图像。
- 低学习率和过少的步数会导致欠拟合:模型将无法生成我们试图融入的概念。
人脸更难训练。在我们的实验中,学习率 2e-6 配合 400 训练步数对物体效果良好,但人脸需要 1e-6(或 2e-6)以及约 1200 步。
如果模型过拟合,图像质量会大幅下降,而以下情况会导致过拟合:
- 学习率过高。
- 我们运行了过多的训练步数。
- 在人脸的情况下,未使用先验保持时,如下一节所示。
训练人脸时使用先验保持
先验保持是一种技术,它在微调过程中使用我们试图训练的同一类别的额外图像。例如,如果我们尝试将一个新人物融入模型,我们想要保持的类别可能是人。先验保持试图通过将新人物照片与其他人照片结合使用来减少过拟合。好处是我们可以使用 Stable Diffusion 模型本身生成这些额外的类别图像!如果你愿意,训练脚本会自动处理这一点,但你也可以提供一个包含你自己先验保持图像的文件夹。
先验保持,1200 步,lr=2e-6。
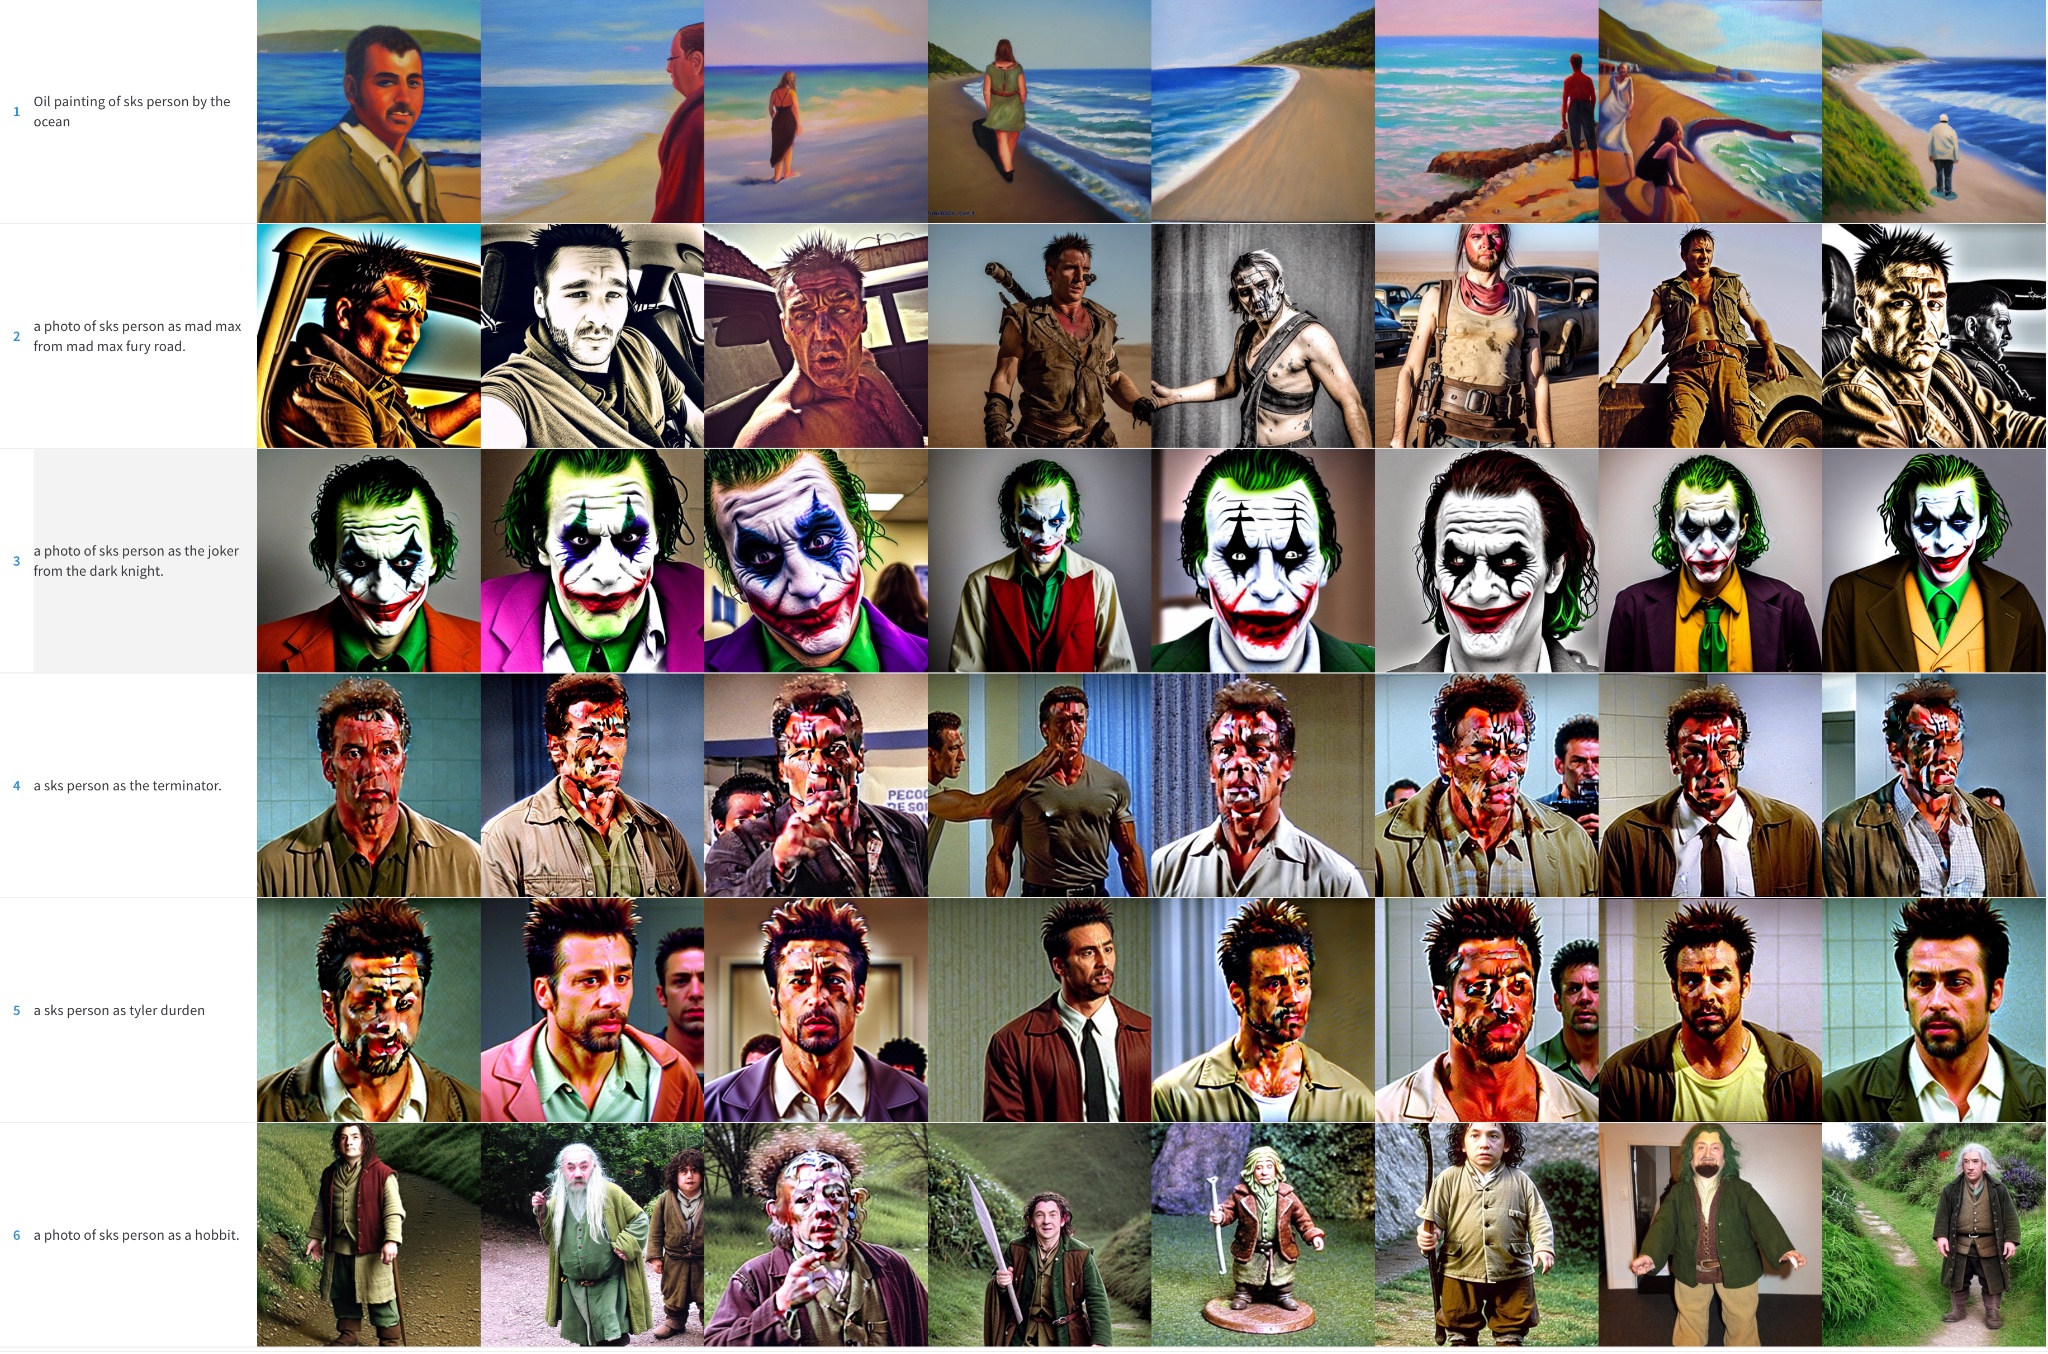
无先验保留,1200 步,lr=2e-6。
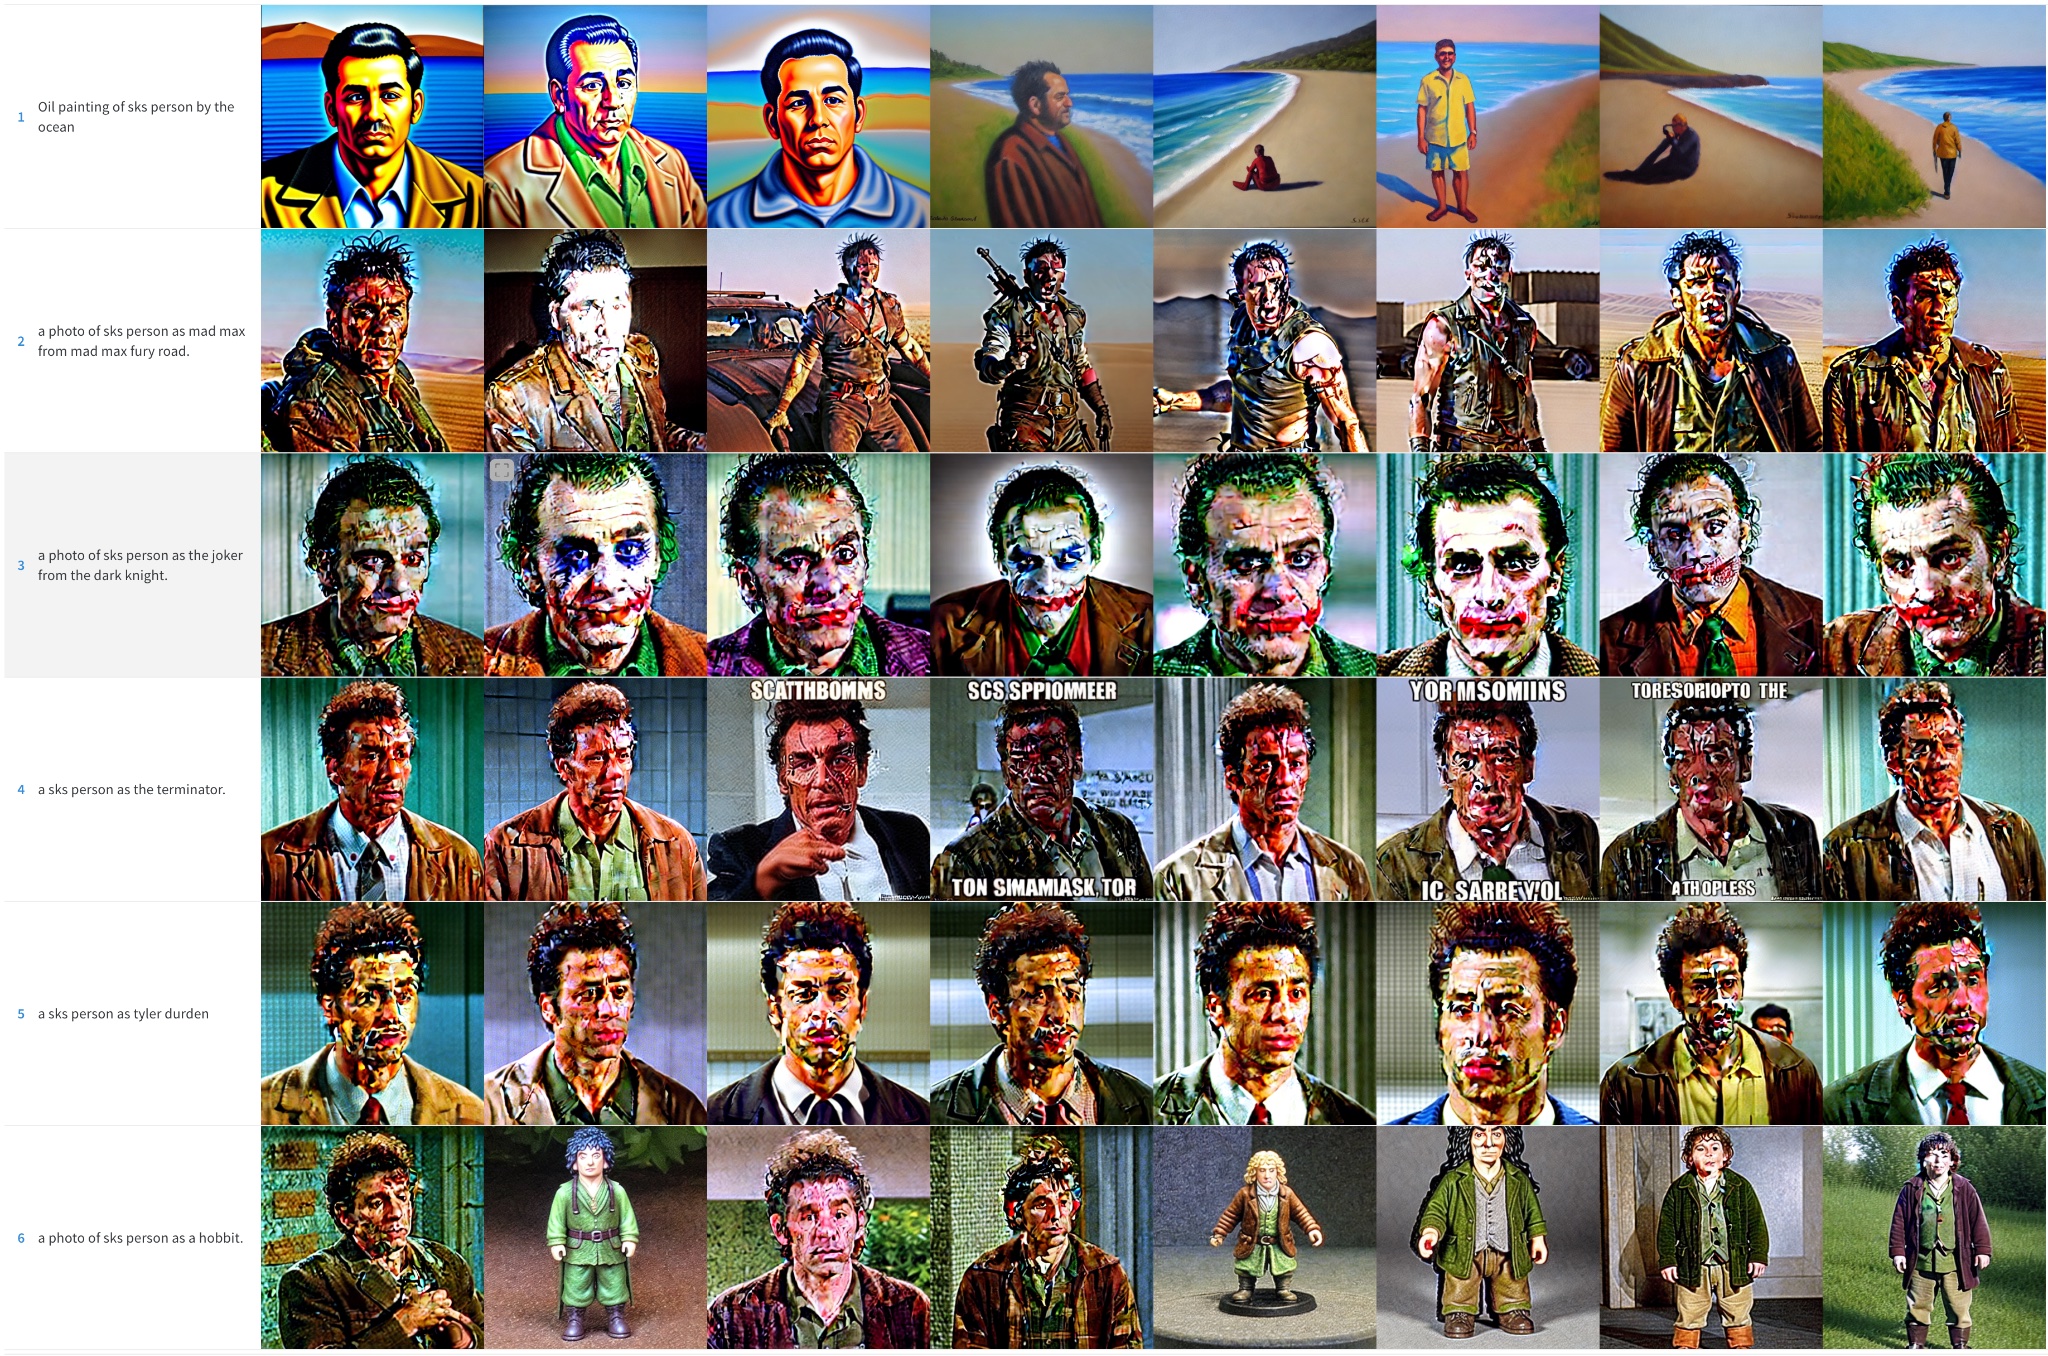
如你所见,使用先验保留时结果更好,但仍有一些噪点斑块。是时候用一些额外的技巧了!
调度器的影响
在前面的示例中,我们在推理过程中使用 PNDM 调度器来采样图像。我们观察到,当模型过拟合时,DDIM 通常比 PNDM 和 LMSDiscrete 效果好得多。此外,通过运行更多步的推理可以提高质量:100 似乎是个不错的选择。额外的步数有助于将一些噪声斑块解析为图像细节。
PNDM,Kramer 脸
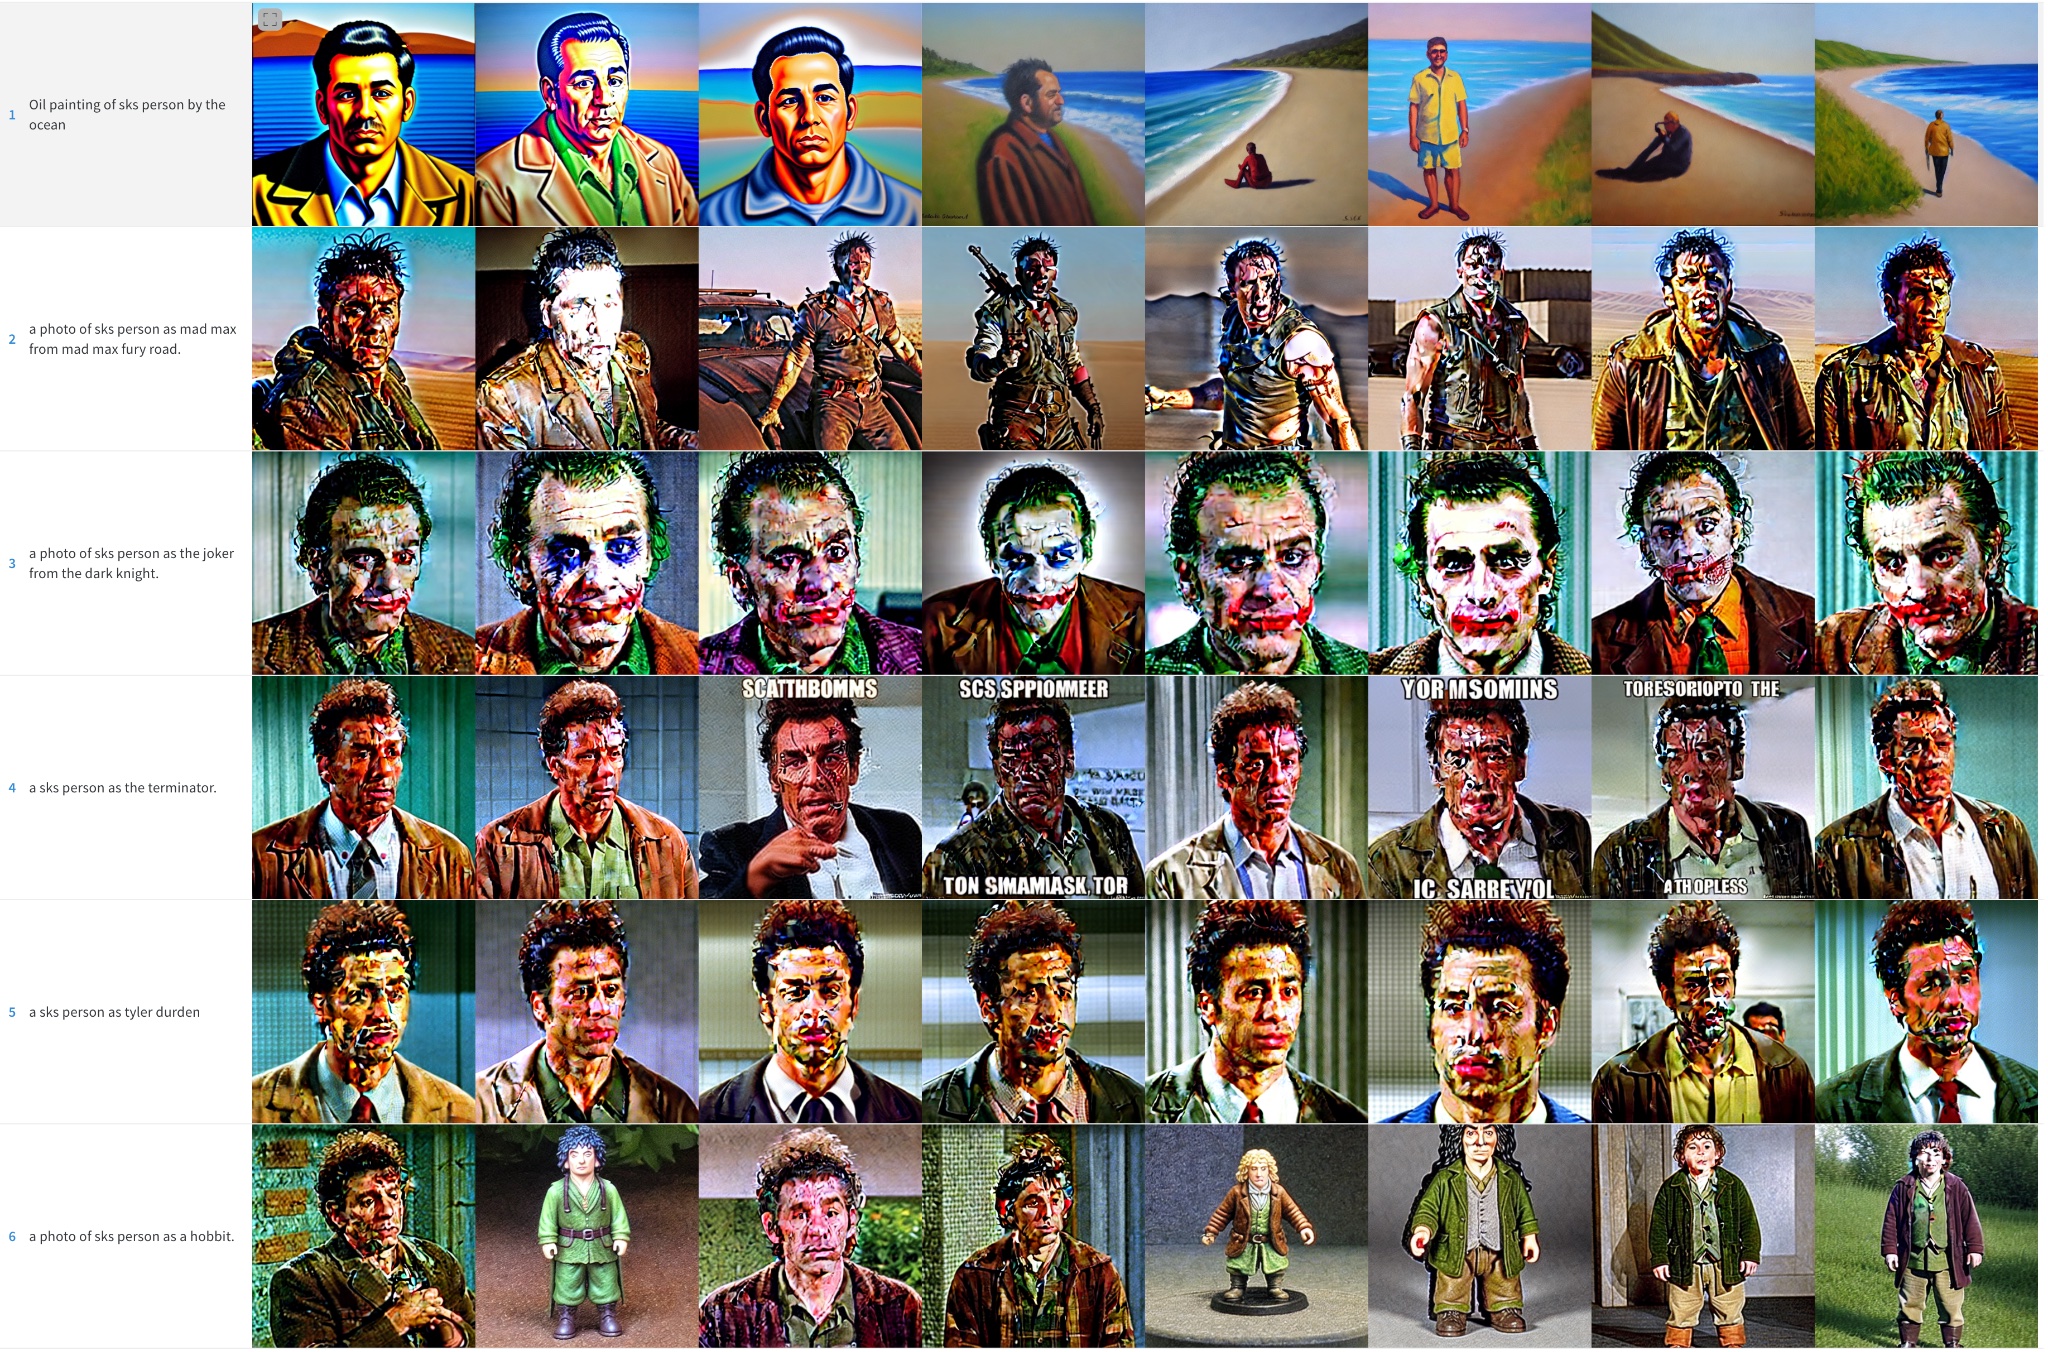
LMSDiscrete,Kramer 脸。结果很糟糕!

DDIM,Kramer 脸。好多了

在其他主体上也可以观察到类似的行为,尽管程度较轻。
PNDM,Potato Head
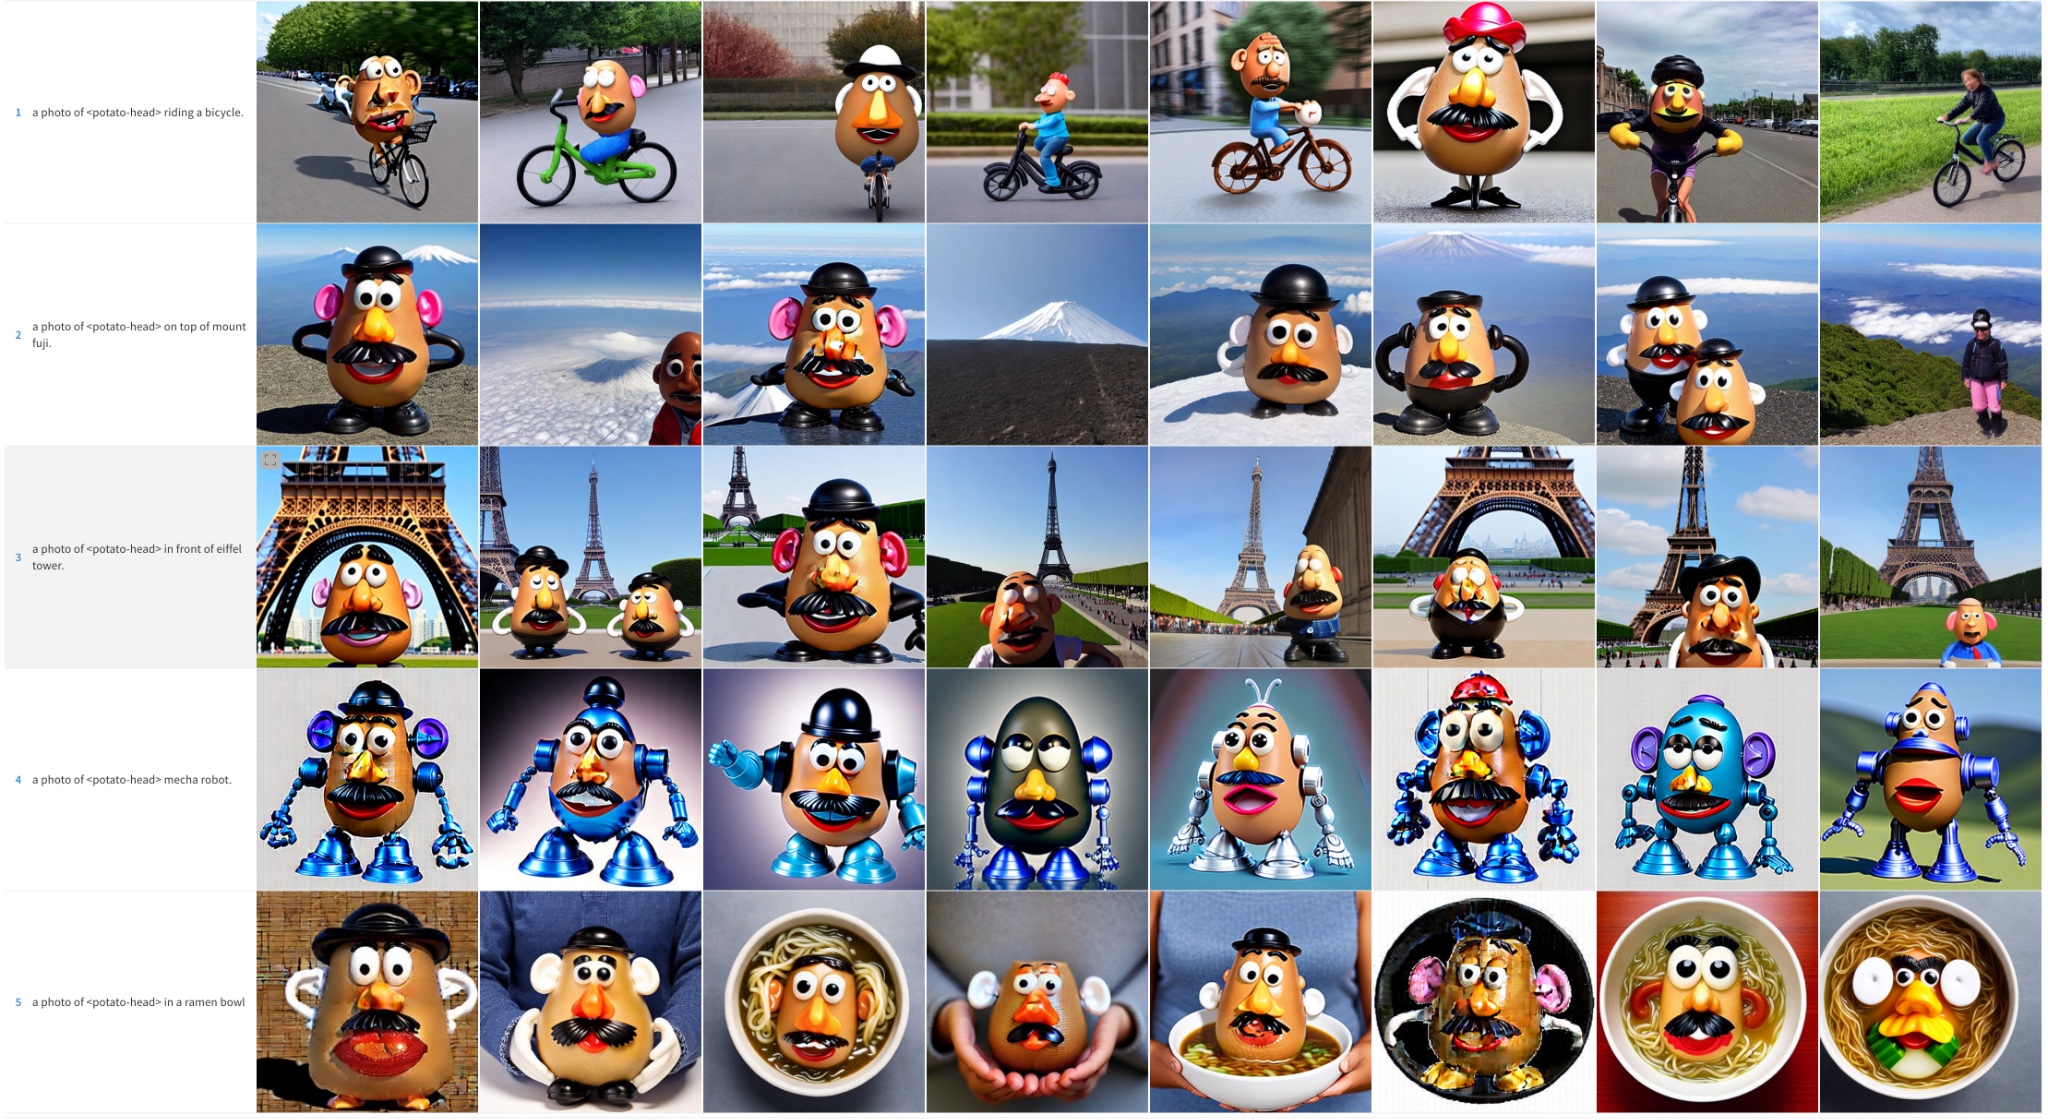
LMSDiscrete,Potato Head
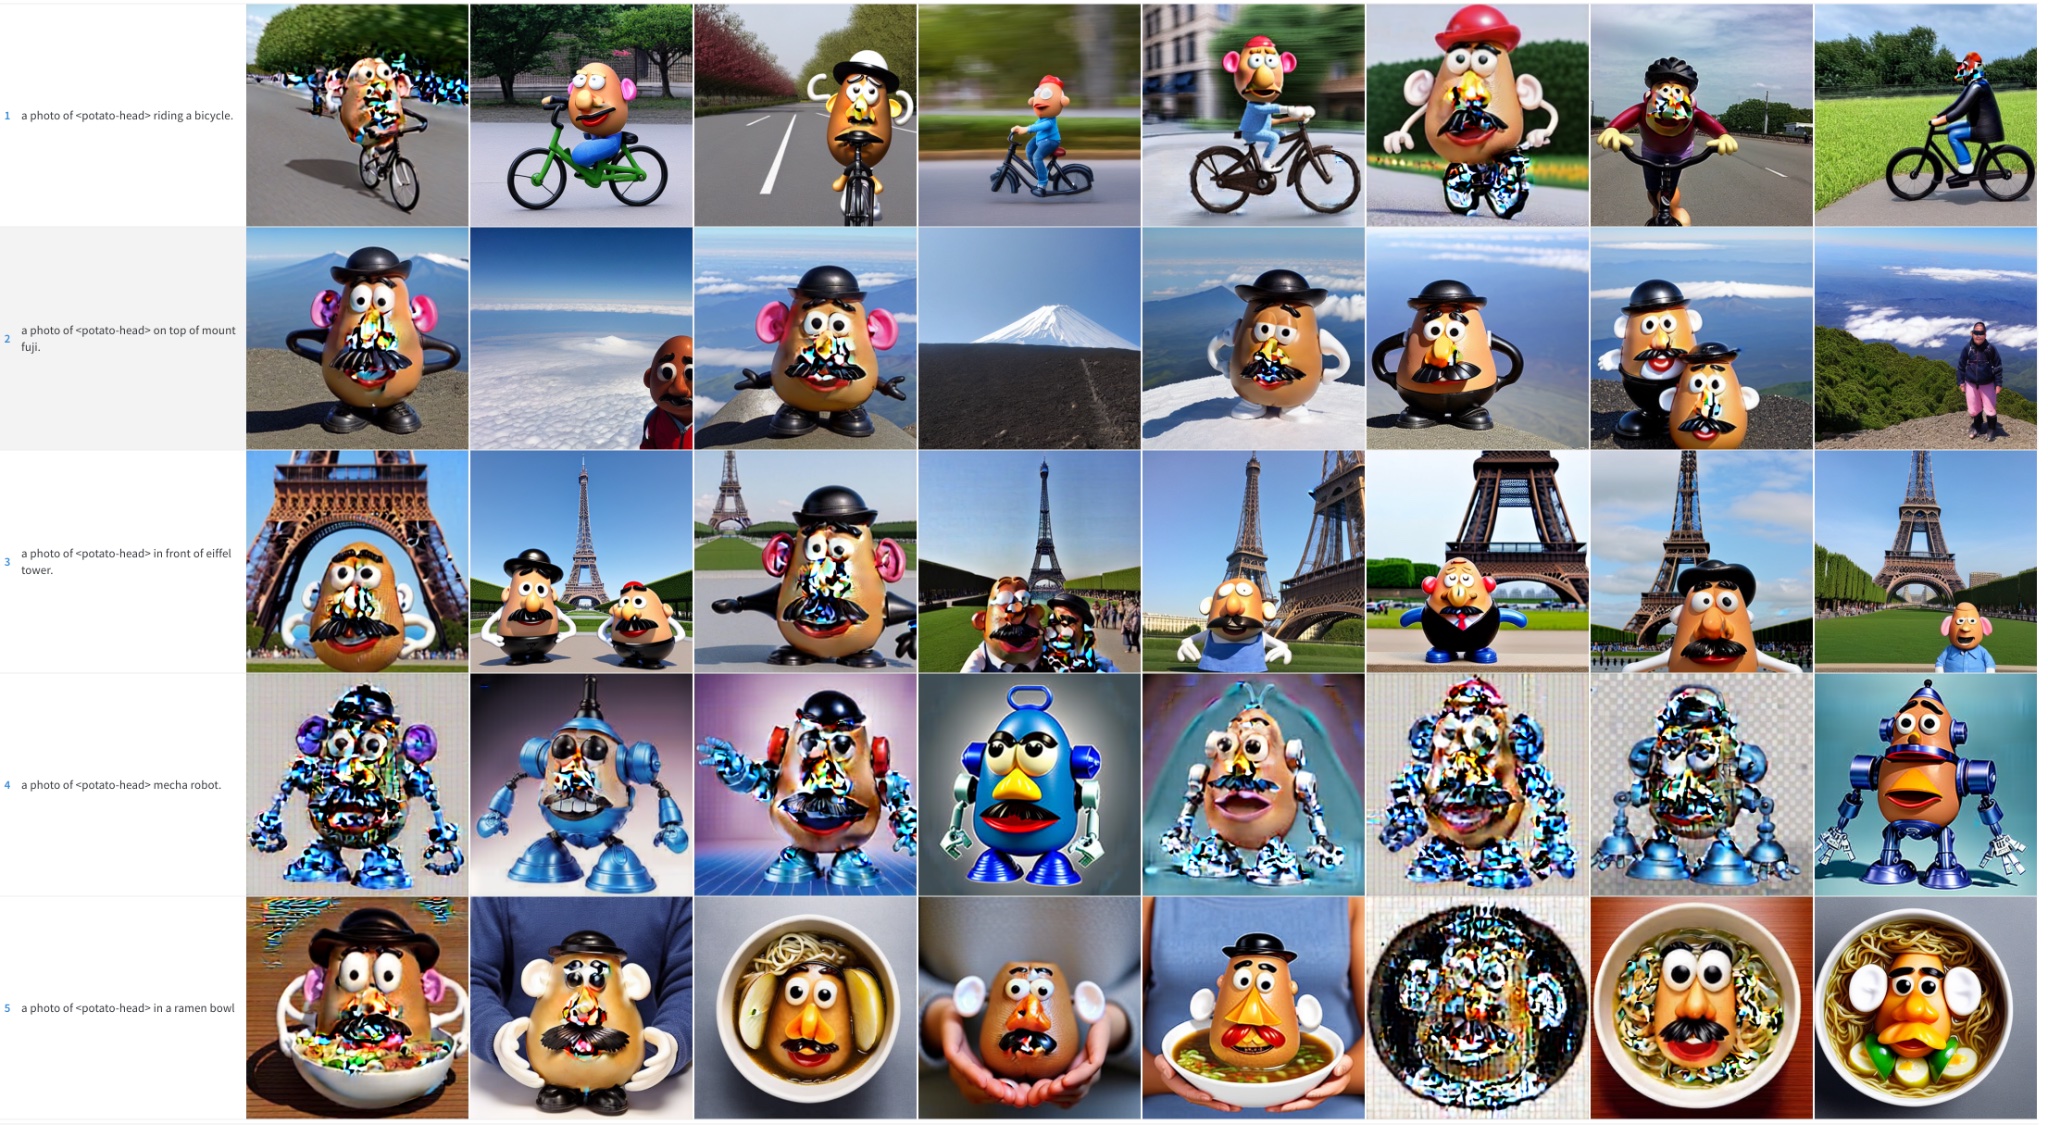
DDIM,Potato Head

微调文本编码器
原始的 Dreambooth 论文描述了一种微调模型 UNet 组件的方法,但保持文本编码器冻结。然而,我们观察到微调编码器能产生更好的结果。我们在看到其他 Dreambooth 实现中使用这种方法后进行了实验,结果令人惊叹!
冻结文本编码器

微调文本编码器
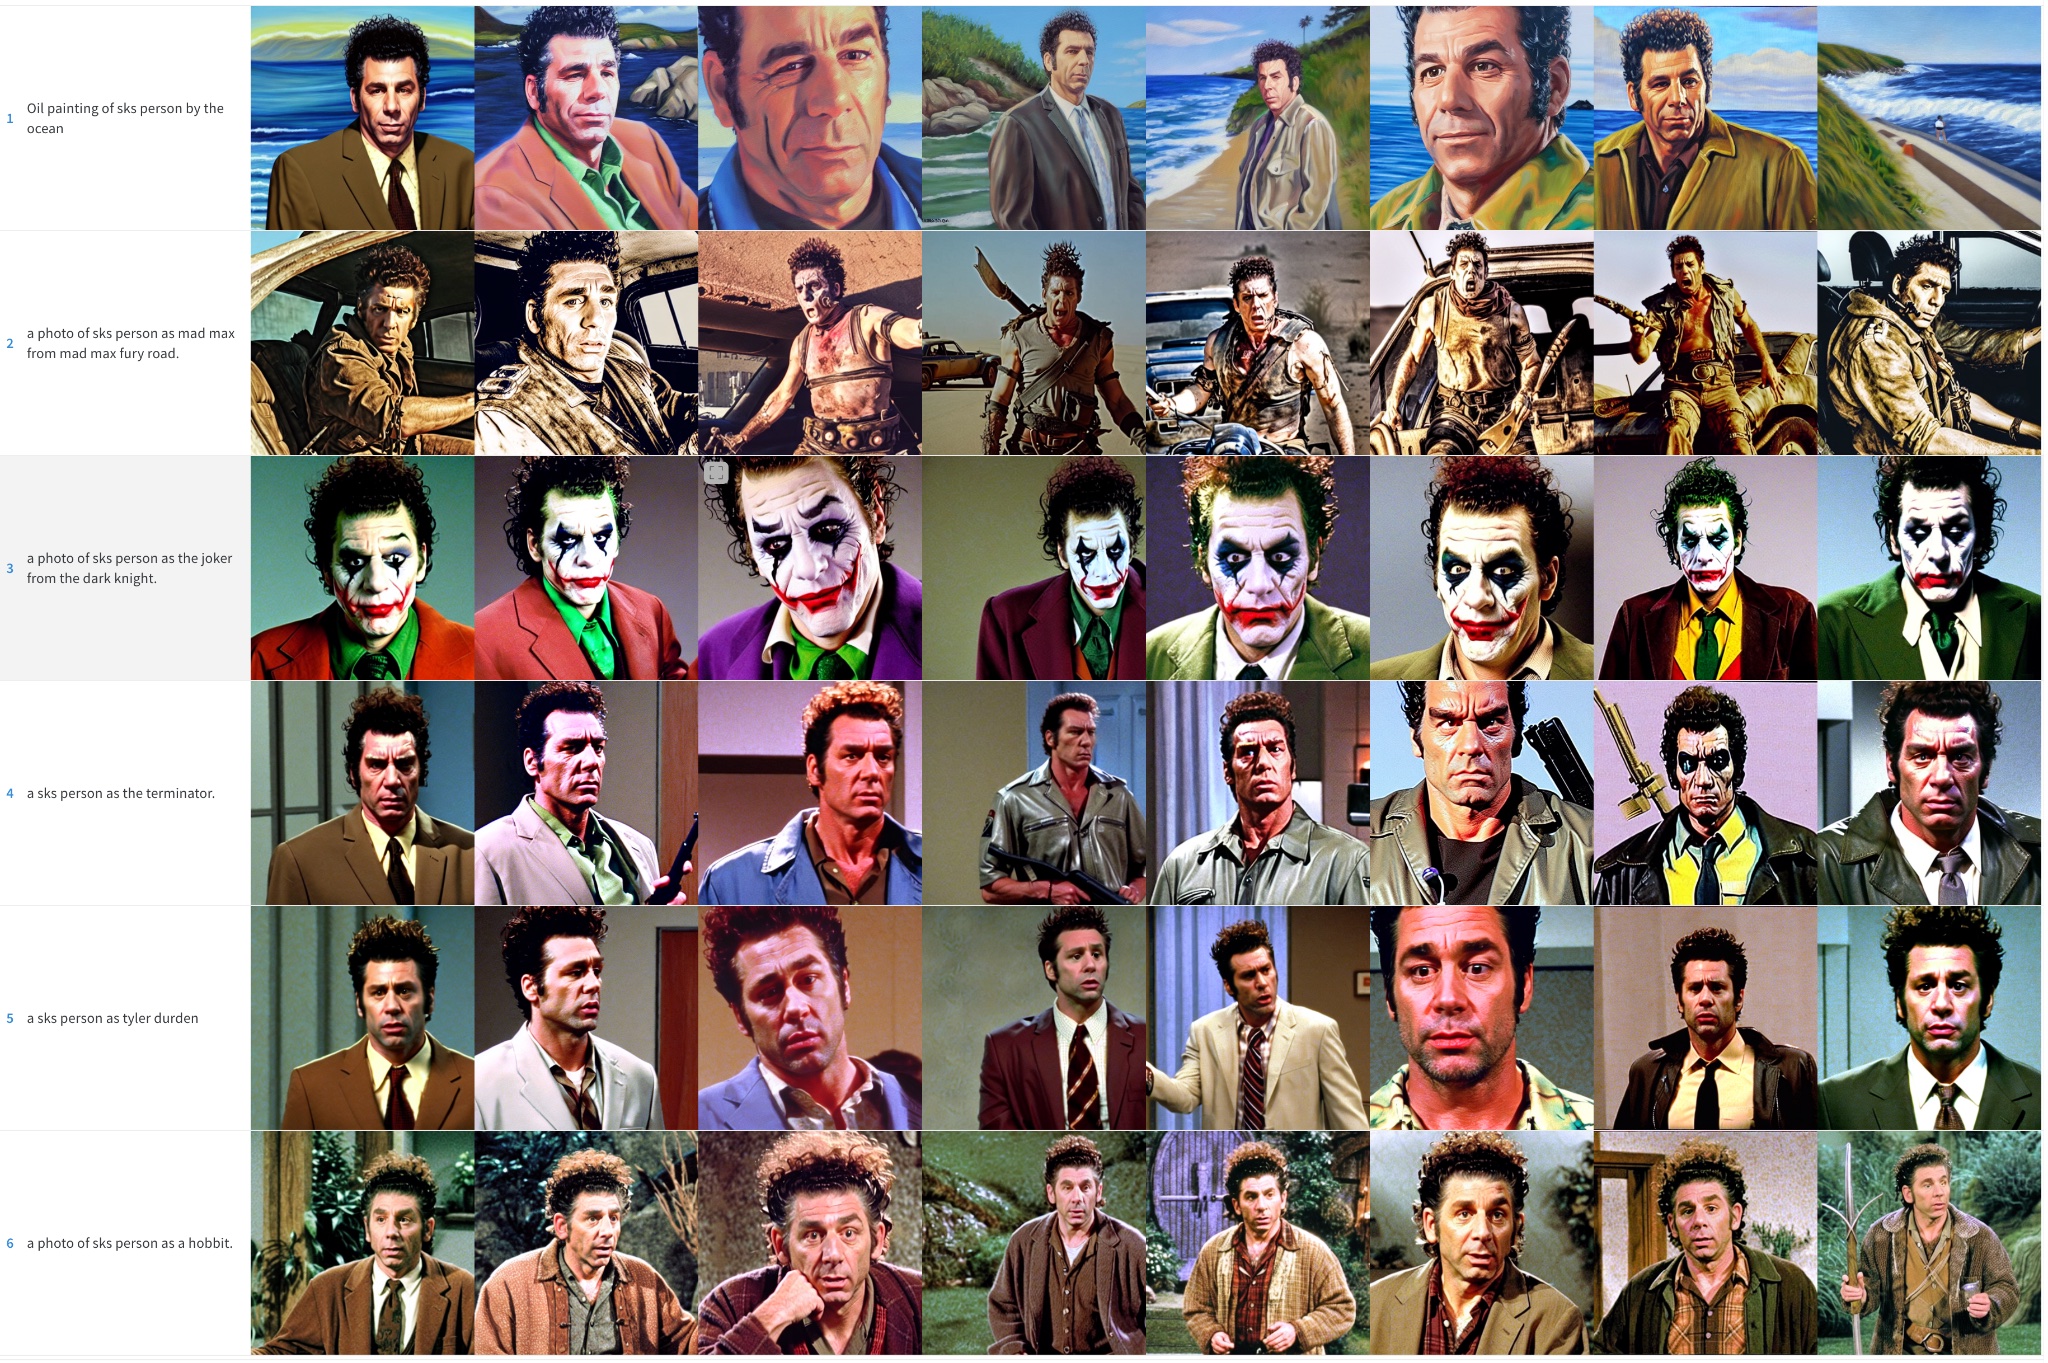
微调文本编码器能产生最佳结果,尤其是对于人脸。它生成的图像更逼真,更不容易过拟合,并且还能实现更好的提示词可解释性,能够处理更复杂的提示词。
尾声:Textual Inversion + Dreambooth
我们还进行了最后一个实验,将 Textual Inversion 与 Dreambooth 结合。这两种技术目标相似,但方法不同。
在这个实验中,我们首先运行了 2000 步的 textual inversion。然后从该模型出发,使用学习率 1e-6 额外运行了 500 步 Dreambooth。结果如下:

我们认为结果比单纯的 Dreambooth 好得多,但不如微调整个文本编码器时那么好。它似乎更多地复制了训练图像的风格,因此可能对它们过拟合了。我们没有进一步探索这种组合,但它可能是一个有趣的替代方案,既能改进 Dreambooth,又能让整个过程适配 16GB GPU。欢迎探索并告诉我们你的结果!
来源:Hugging Face:Blog · huggingface.co