Hugging Face Diffusers 教程:用 JAX/Flax 在 TPU 上运行 Stable Diffusion
🧨 Stable Diffusion in JAX / Flax !
Hugging Face Diffusers 自 0.5.1 版本起支持 Flax,官方博客教程演示如何用 JAX/Flax 在 Google TPU 上运行 Stable Diffusion 推理。
Hugging Face 官方教程,演示在 TPU 上用 JAX/Flax 跑 Stable Diffusion,8 卡并行约 7 秒生成 8 张图,可直接复现。

🤗 Hugging Face Diffusers 从版本 0.5.1 开始支持 Flax!这使得在 Google TPU 上可以进行超快速推理,例如 Colab、Kaggle 或 Google Cloud Platform 中提供的 TPU。
本文介绍如何使用 JAX / Flax 进行推理。如果你想了解 Stable Diffusion 的工作原理或想在 GPU 上运行它,请参考这个 Colab notebook。
如果你想跟着操作,请点击上方的按钮将此文章作为 Colab notebook 打开。
首先,确保你使用的是 TPU 后端。如果你在 Colab 中运行此 notebook,请在上方菜单中选择 Runtime,然后选择“更改运行时类型”选项,再在 Hardware accelerator 设置下选择 TPU。
请注意,JAX 并非 TPU 专属,但它在 TPU 硬件上表现出色,因为每台 TPU 服务器都有 8 个 TPU 加速器并行工作。
设置
import jax
num_devices = jax.device_count()
device_type = jax.devices()[0].device_kind

print(f"Found {num_devices} JAX devices of type {device_type}.")
assert "TPU" in device_type, "Available device is not a TPU, please select TPU from Edit > Notebook settings > Hardware accelerator"
输出:
Found 8 JAX devices of type TPU v2.
确保已安装 diffusers。
!pip install diffusers==0.5.1
然后我们导入所有依赖项。
import numpy as np
import jax
import jax.numpy as jnp

from pathlib import Path
from jax import pmap
from flax.jax_utils import replicate
from flax.training.common_utils import shard
from PIL import Image

from huggingface_hub import notebook_login
from diffusers import FlaxStableDiffusionPipeline
模型加载
在使用模型之前,你需要接受模型许可证才能下载和使用权重。
该许可证旨在减轻如此强大的机器学习系统可能带来的有害影响。 我们要求用户完整且仔细地阅读许可证。以下是我们提供的摘要:
- 你不能使用该模型故意生成或分享非法或有害的输出或内容,
- 我们对您生成的输出不主张任何权利,您可以自由使用它们,并对它们的使用负责,且使用不应违反许可证中的规定,以及
- 您可以重新分发权重,并将模型用于商业用途和/或作为服务。如果这样做,请注意您必须包含与许可证中相同的使用限制,并向所有用户分享一份 CreativeML OpenRAIL-M 的副本。
Flax 权重可在 Hugging Face Hub 上作为 Stable Diffusion 仓库的一部分获取。Stable Diffusion 模型在 CreateML OpenRail-M 许可证下分发。这是一个开放许可证,不对您生成的输出主张任何权利,并禁止您故意生成非法或有害内容。模型卡片提供了更多详细信息,请花点时间阅读它们,并仔细考虑您是否接受该许可证。如果您接受,您需要在 Hub 中注册为用户,并使用访问令牌才能使代码正常工作。您有两种方式提供访问令牌:
- 在终端中使用
huggingface-cli login命令行工具,并在提示时粘贴您的令牌。它将被保存在您计算机上的一个文件中。 - 或者在 notebook 中使用
notebook_login(),效果相同。
以下单元格将显示登录界面,除非您之前已在此计算机上进行过身份验证。您需要粘贴您的访问令牌。
if not (Path.home()/'.huggingface'/'token').exists(): notebook_login()
TPU 设备支持 bfloat16,一种高效的半精度浮点类型。我们将在测试中使用它,但您也可以使用 float32 来使用全精度。
dtype = jnp.bfloat16
Flax 是一个函数式框架,因此模型是无状态的,参数存储在模型外部。加载预训练的 Flax pipeline 将返回 pipeline 本身和模型权重(或参数)。我们使用的是权重的 bf16 版本,这会导致类型警告,您可以安全地忽略它们。
pipeline, params = FlaxStableDiffusionPipeline.from_pretrained(
    "CompVis/stable-diffusion-v1-4",
    revision="bf16",
    dtype=dtype,
)
推理
由于 TPU 通常有 8 个设备并行工作,我们会将提示复制与设备数量相同的次数。然后我们会在 8 个设备上同时执行推理,每个设备负责生成一张图像。这样,我们就能在单个芯片生成一张图像所需的时间内得到 8 张图像。
复制提示后,我们通过调用管道的 prepare_inputs 函数来获得分词后的文本 id。分词文本的长度设置为 77 个 token,这是底层 CLIP 文本模型配置所要求的。
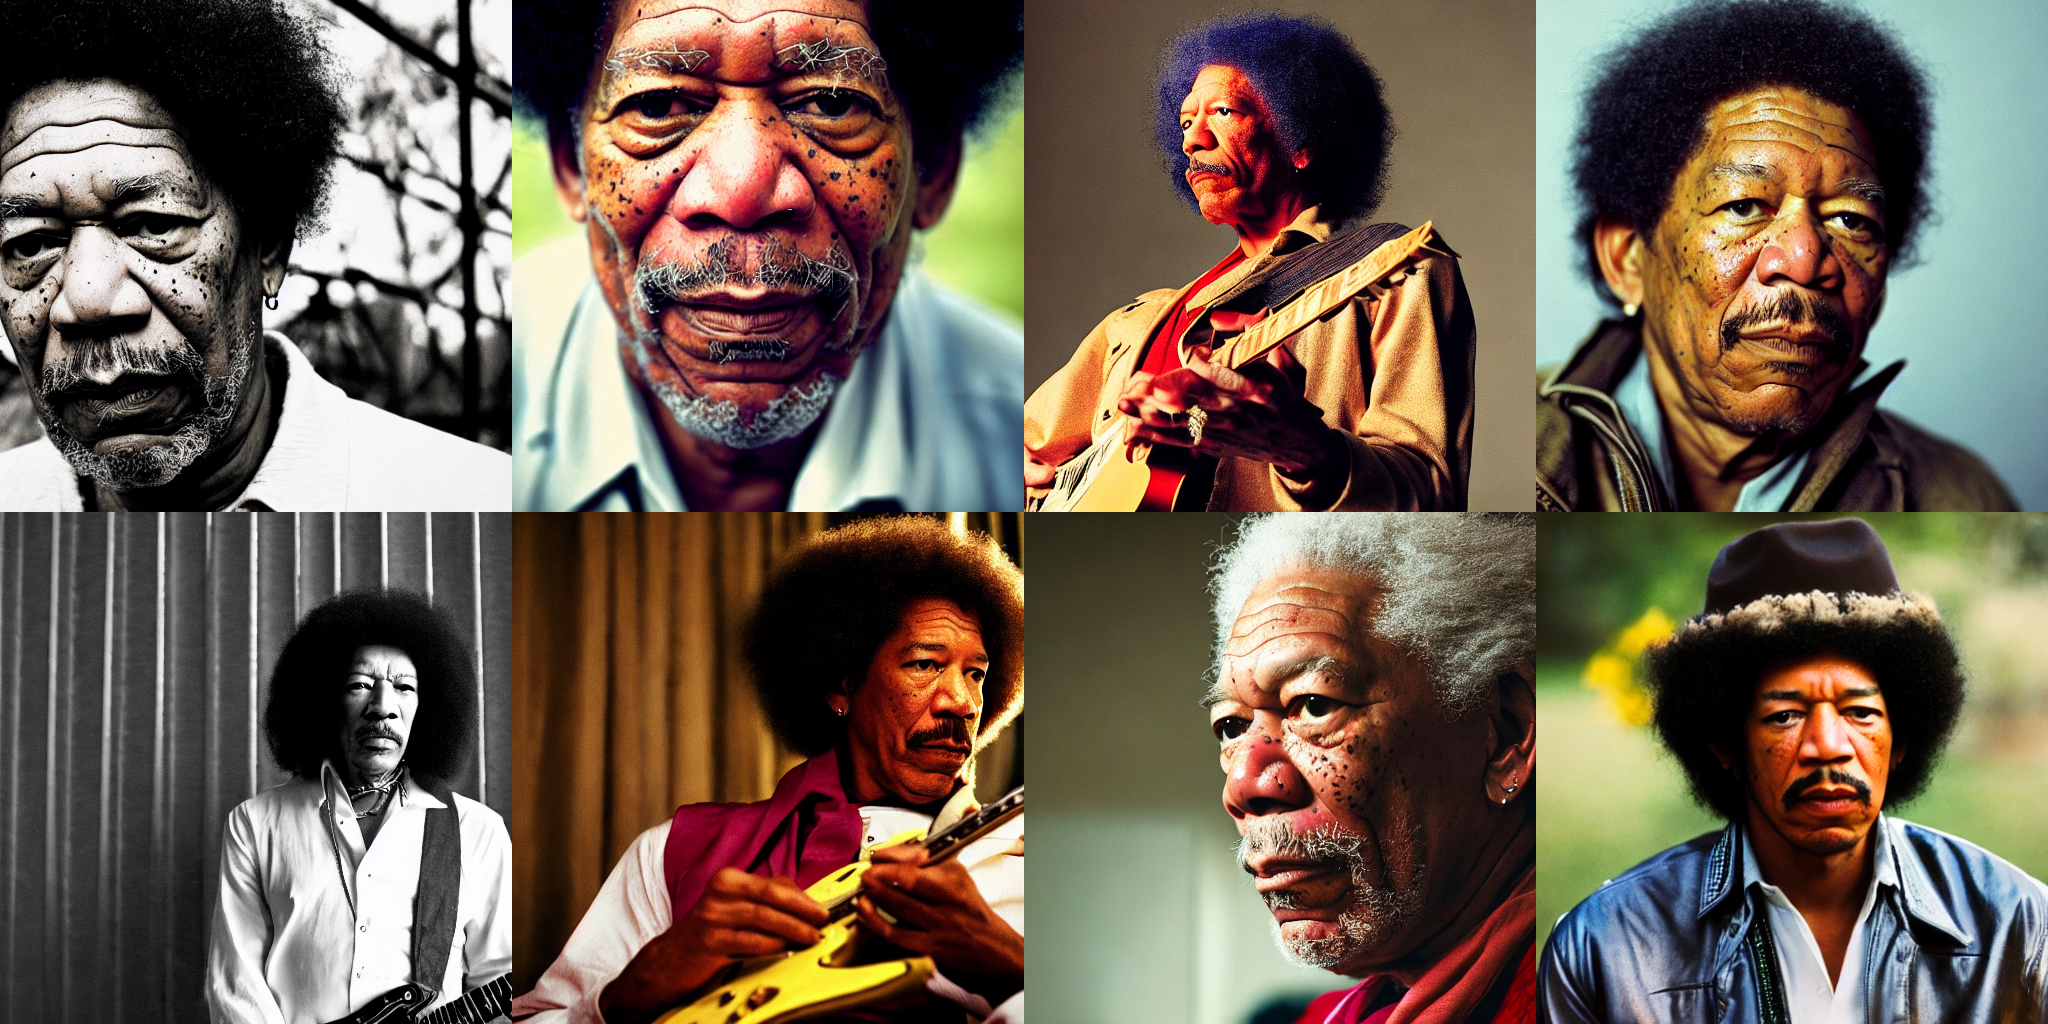
prompt = "A cinematic film still of Morgan Freeman starring as Jimi Hendrix, portrait, 40mm lens, shallow depth of field, close up, split lighting, cinematic"
prompt = [prompt] * jax.device_count()
prompt_ids = pipeline.prepare_inputs(prompt)
prompt_ids.shape
输出:
(8, 77)
复制与并行化
模型参数和输入必须在我们的 8 个并行设备上复制。参数字典使用 flax.jax_utils.replicate 进行复制,它会遍历字典并改变权重的形状,使其重复 8 次。数组使用 shard 进行复制。
p_params = replicate(params)
prompt_ids = shard(prompt_ids)
prompt_ids.shape
输出:
(8, 1, 77)
这个形状意味着 8 个设备中的每一个都将接收一个形状为 (1, 77) 的 jnp 数组作为输入。因此,1 是每个设备的批大小。在内存充足的 TPU 上,如果我们想一次生成多张图像(每个芯片),它可以大于 1。
我们几乎准备好生成图像了!我们只需要创建一个随机数生成器传递给生成函数。这是 Flax 中的标准流程,它对随机数非常严格且有明确要求——所有处理随机数的函数都需要接收一个生成器。这确保了可复现性,即使我们在多个分布式设备上进行训练时也是如此。
下面的辅助函数使用种子来初始化随机数生成器。只要我们使用相同的种子,就会得到完全相同的结果。在 notebook 后面探索结果时,可以随意使用不同的种子。
def create_key(seed=0):
    return jax.random.PRNGKey(seed)
我们获得一个 rng,然后将其“拆分”8 次,以便每个设备接收到不同的生成器。因此,每个设备将创建不同的图像,并且整个过程是可复现的。
rng = create_key(0)
rng = jax.random.split(rng, jax.device_count())
JAX 代码可以编译为运行非常快速的高效表示。然而,我们需要确保后续调用中的所有输入具有相同的形状;否则,JAX 将不得不重新编译代码,我们就无法利用优化后的速度。
如果我们传入 jit = True 作为参数,Flax 管道可以为我们编译代码。它还将确保模型在 8 个可用设备上并行运行。
第一次运行以下单元格时,编译将需要很长时间,但后续调用(即使输入不同)会快得多。例如,我测试时在 TPU v2-8 上编译花了一分多钟,但之后未来的推理运行大约只需要 7s。
images = pipeline(prompt_ids, p_params, rng, jit=True)[0]
输出:
    CPU times: user 464 ms, sys: 105 ms, total: 569 ms
    Wall time: 7.07 s
返回的数组形状为 (8, 1, 512, 512, 3)。我们对其进行重塑以去掉第二个维度,得到 8 张 512 × 512 × 3 的图像,然后将它们转换为 PIL。
images = images.reshape((images.shape[0],) + images.shape[-3:])
images = pipeline.numpy_to_pil(images)
可视化
让我们创建一个辅助函数来在网格中显示图像。
def image_grid(imgs, rows, cols):
    w,h = imgs[0].size
    grid = Image.new('RGB', size=(cols*w, rows*h))
    for i, img in enumerate(imgs): grid.paste(img, box=(i%cols*w, i//cols*h))
    return grid
image_grid(images, 2, 4)
使用不同的提示
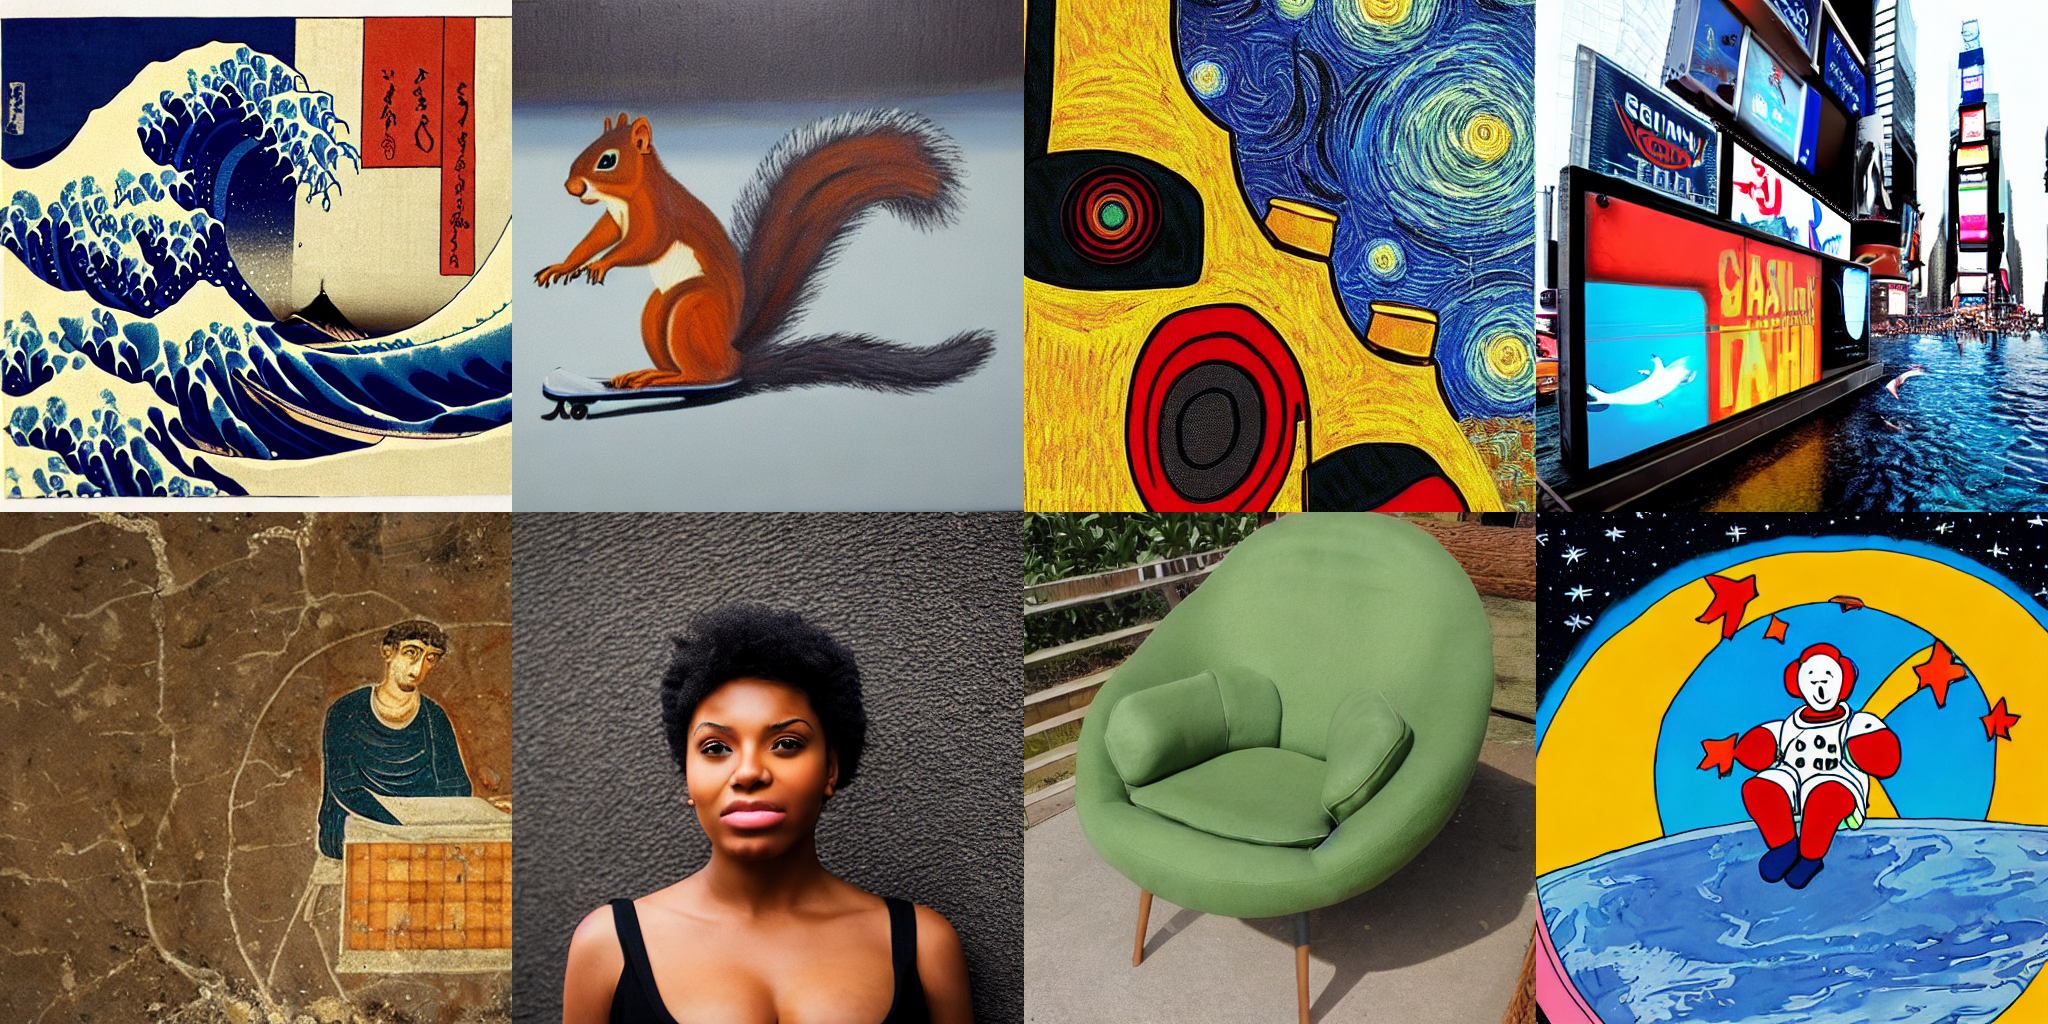
我们不必在所有设备上复制相同的提示。我们可以做任何我们想做的事:生成 2 个提示各 4 次,甚至一次生成 8 个不同的提示。让我们这样做吧!
首先,我们将输入准备代码重构为一个方便的函数:
prompts = [
    "Labrador in the style of Hokusai",
    "Painting of a squirrel skating in New York",
    "HAL-9000 in the style of Van Gogh",
    "Times Square under water, with fish and a dolphin swimming around",
    "Ancient Roman fresco showing a man working on his laptop",
    "Close-up photograph of young black woman against urban background, high quality, bokeh",
    "Armchair in the shape of an avocado",
    "Clown astronaut in space, with Earth in the background",
]
prompt_ids = pipeline.prepare_inputs(prompts)
prompt_ids = shard(prompt_ids)
images = pipeline(prompt_ids, p_params, rng, jit=True).images
images = images.reshape((images.shape[0], ) + images.shape[-3:])
images = pipeline.numpy_to_pil(images)
image_grid(images, 2, 4)
并行化是如何工作的?
我们之前说过,diffusers Flax 流水线会自动编译模型,并在所有可用设备上并行运行。现在我们将简要探究这一过程,以展示其工作原理。
JAX 并行化可以通过多种方式实现。最简单的方式是使用 jax.pmap 函数来实现单程序多数据(SPMD)并行化。这意味着我们将运行同一代码的多个副本,每个副本处理不同的数据输入。还有更复杂的方法,如果你感兴趣,我们邀请你查阅 JAX 文档和 pjit 页面来探索这一主题!
jax.pmap 为我们做了两件事:
- 编译(或
jit)代码,就像我们调用了jax.jit()一样。这不会在我们调用pmap时发生,而是在首次调用 pmapped 函数时发生。 - 确保编译后的代码在所有可用设备上并行运行。
为了展示其工作原理,我们对流水线的 _generate 方法进行 pmap,这是运行生成图像的私有方法。请注意,此方法在未来的 diffusers 版本中可能会被重命名或移除。
p_generate = pmap(pipeline._generate)
在我们使用 pmap 之后,准备好的函数 p_generate 在概念上将执行以下操作:
- 在每个设备上调用底层函数
pipeline._generate的一个副本。 - 向每个设备发送输入参数的不同部分。这就是分片(sharding)的用途。在我们的例子中,
prompt_ids的形状为(8, 1, 77, 768)。这个数组将被拆分为8,每个_generate的副本将接收形状为(1, 77, 768)的输入。
我们可以完全忽略 _generate 将被并行调用这一事实来编写代码。我们只需关心批大小(本例中为 1)以及对我们代码有意义的维度,无需做任何改动即可使其并行工作。
与我们使用流水线调用时一样,第一次运行以下单元格会花费一些时间,但之后会快得多。
images = p_generate(prompt_ids, p_params, rng)
images = images.block_until_ready()
images.shape
输出:
    CPU times: user 118 ms, sys: 83.9 ms, total: 202 ms
    Wall time: 6.82 s

    (8, 1, 512, 512, 3)
我们使用 block_until_ready() 来正确测量推理时间,因为 JAX 使用异步调度,并会尽快将控制权返回给 Python 循环。你不需要在代码中使用它;当你想要使用尚未具体化的计算结果时,阻塞会自动发生。
来源:Hugging Face:Blog · huggingface.co