Hugging Face 发布 Document AI 实践指南:六大用例与开源模型选型
Accelerating Document AI
Hugging Face 发布 Document AI 指南,梳理 OCR、文档图像分类、版面分析、文档解析、表格识别和 DocVQA 六大用例及对应开源模型与指标。
原文系统梳理了 Document AI 六类用例及对应开源模型、指标与许可证,团队可直接按图索骥选型并自建方案。
企业中充斥着包含知识的文档,而这些知识无法通过数字化工作流获取。这些文档可能包括信件、发票、表单、报告到收据等各种形式。随着文本、视觉和多模态 AI 的进步,现在可以解锁这些信息。本文展示了您的团队如何免费使用开源模型构建自定义解决方案!
Document AI 包含许多数据科学任务,从图像分类、图像转文本、文档问答、表格问答到视觉问答。本文首先介绍 Document AI 中用例的分类法以及针对这些用例的最佳开源模型。接下来,本文重点关注许可、数据准备和建模。在本文中,有指向网络演示、文档和模型的链接。
用例
构建文档 AI 解决方案至少有六个通用用例。这些用例在文档输入和输出的类型上有所不同。在解决企业 Document AI 问题时,通常需要结合多种方法。
将打字、手写或印刷文本转换为机器编码文本的过程称为光学字符识别(OCR)。这是一个被广泛研究的问题,有许多成熟的开源和商业产品。图中展示了将手写内容转换为文本的示例。
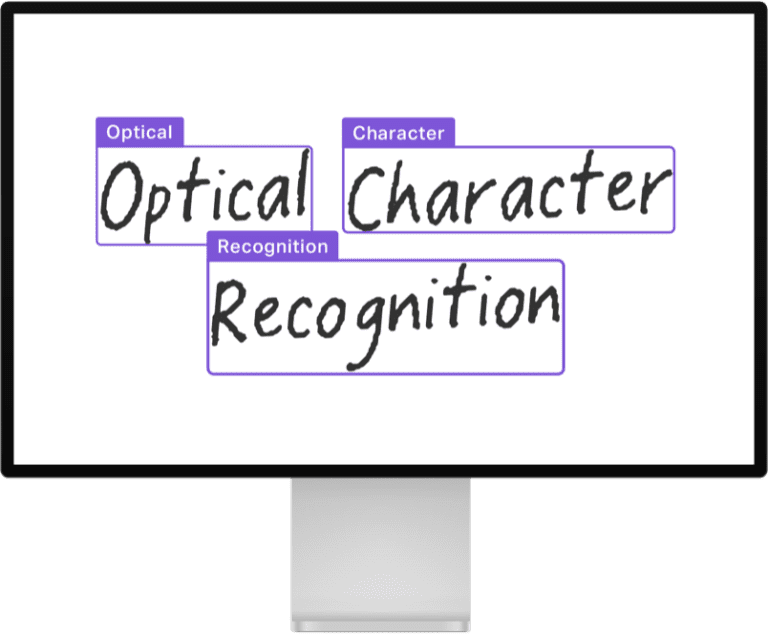
OCR 是 Document AI 用例的支柱,因为它对于将文本转换为计算机可读的内容至关重要。一些广泛可用的、在文档级别运行的 OCR 模型包括 EasyOCR 或 PaddleOCR。还有像 TrOCR: Transformer-based Optical Character Recognition with Pre-trained Models 这样的模型,它在单行文本图像上运行。该模型与文本检测模型(如 CRAFT)配合使用,后者首先以边界框的形式识别文档中各个文本“片段”。OCR 的相关指标是字符错误率(CER)以及词级别的精确率、召回率和 F1。查看这个 Space 以了解 CRAFT 和 TrOCR 的演示。
将文档分类到适当的类别(如表单、发票或信件)称为文档图像分类。分类可以使用文档的图像和文本中的一种或两种。最近新增的多模态模型利用视觉结构和底层文本,显著提高了分类器的性能。
一种基本方法是对文档图像应用 OCR,然后使用类似 BERT 的模型进行分类。然而,仅依赖 BERT 模型不会考虑任何布局或视觉信息。来自 RVL-CDIP 数据集的图展示了不同文档类型的视觉结构差异。
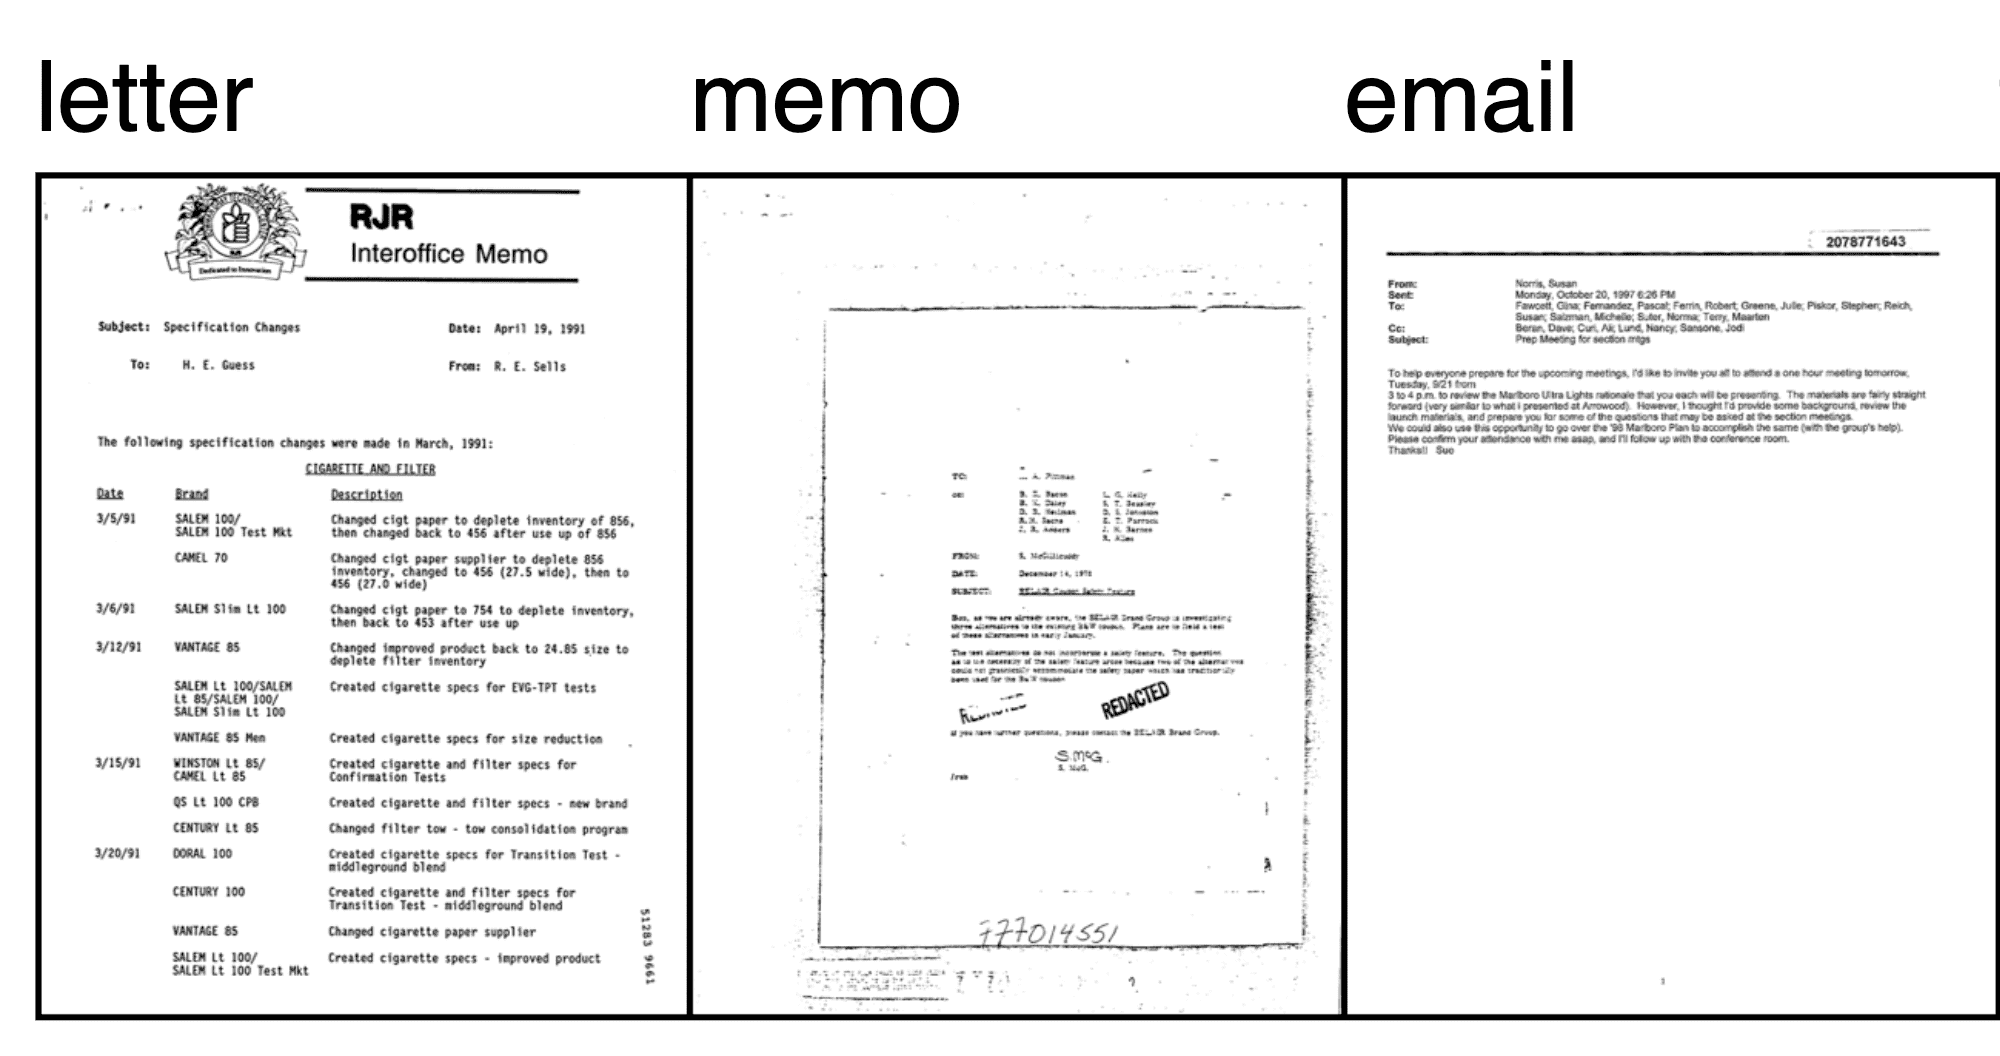
这就是 LayoutLM 和 Donut 这类模型发挥作用的地方。通过不仅纳入文本信息,还纳入视觉信息,这些模型可以大幅提高准确率。作为对比,在 RVL-CDIP 这一文档图像分类的重要基准上,一个 BERT-base 模型仅使用文本就能达到 89% 的准确率。而 DiT(Document Image Transformer)是一个纯视觉模型(即它不以文本作为输入),可以达到 92% 的准确率。但像 LayoutLMv3 和 Donut 这样使用多模态 Transformer 同时利用文本和视觉信息的模型,可以达到 95% 的准确率!这些多模态模型正在改变从业者解决 Document AI 用例的方式。
文档版面分析是确定文档物理结构的任务,即识别构成文档的各个构建块,如文本段、标题和表格。这项任务通常通过将其框定为图像分割/目标检测问题来解决。模型输出一组分割掩码/边界框,以及类别名称。
目前文档版面分析领域最先进的模型是 LayoutLMv3 和 DiT(Document Image Transformer)。这两个模型都使用经典的 Mask R-CNN 目标检测框架作为骨干。这个 文档版面分析 Space 展示了如何使用 DiT 来识别文档中的文本段、标题和表格。这里展示了一个使用 DiT 检测文档不同部分的示例。
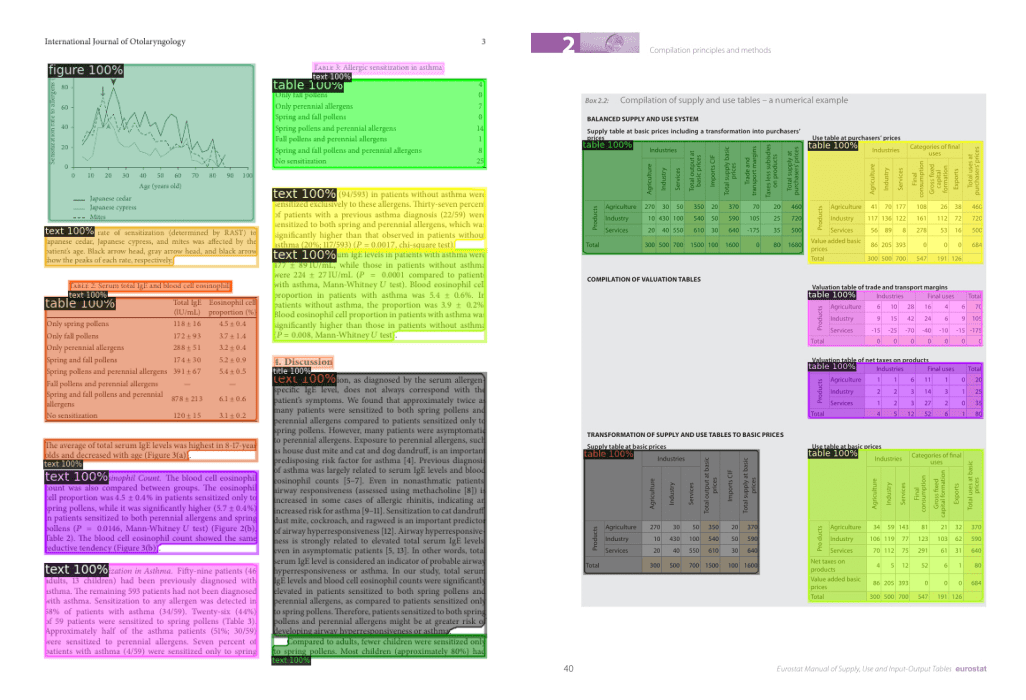
使用 DiT 进行文档版面分析。
文档版面分析通常使用 mAP(平均精度均值)指标,该指标常用于评估目标检测模型。版面分析的一个重要基准是 PubLayNet 数据集。在撰写本文时最先进的 LayoutLMv3 达到了 0.951 的整体 mAP 分数(来源)。
比版面分析更进一步的是文档解析。文档解析是从文档中识别并提取关键信息(通常以键值对的形式),例如从发票表单中提取姓名、项目和总计。这个 LayoutLMv2 Space 展示了如何解析文档以识别问题、答案和标题。
LayoutLM 的第一个版本(现在称为 LayoutLMv1)于 2020 年发布,相比现有基准有了大幅提升,并且它至今仍是 Hugging Face Hub 上最受欢迎的 Document AI 模型之一。LayoutLMv2 和 LayoutLMv3 在预训练期间纳入了视觉特征,从而带来了改进。LayoutLM 系列为 Document AI 性能带来了阶跃式变化。例如,在 FUNSD 基准数据集上,一个 BERT 模型的 F1 分数为 60%,但使用 LayoutLM,可以达到 90%!
LayoutLMv1 现在有许多后继者,包括 ERNIE-Layout,它在这个 Space 中展示了令人期待的结果。对于多语言用例,有 LayoutLM 的多语言变体,如 LayoutXLM 和 LiLT。这张来自 LayoutLM 论文的图展示了 LayoutLM 分析一些不同文档的过程。
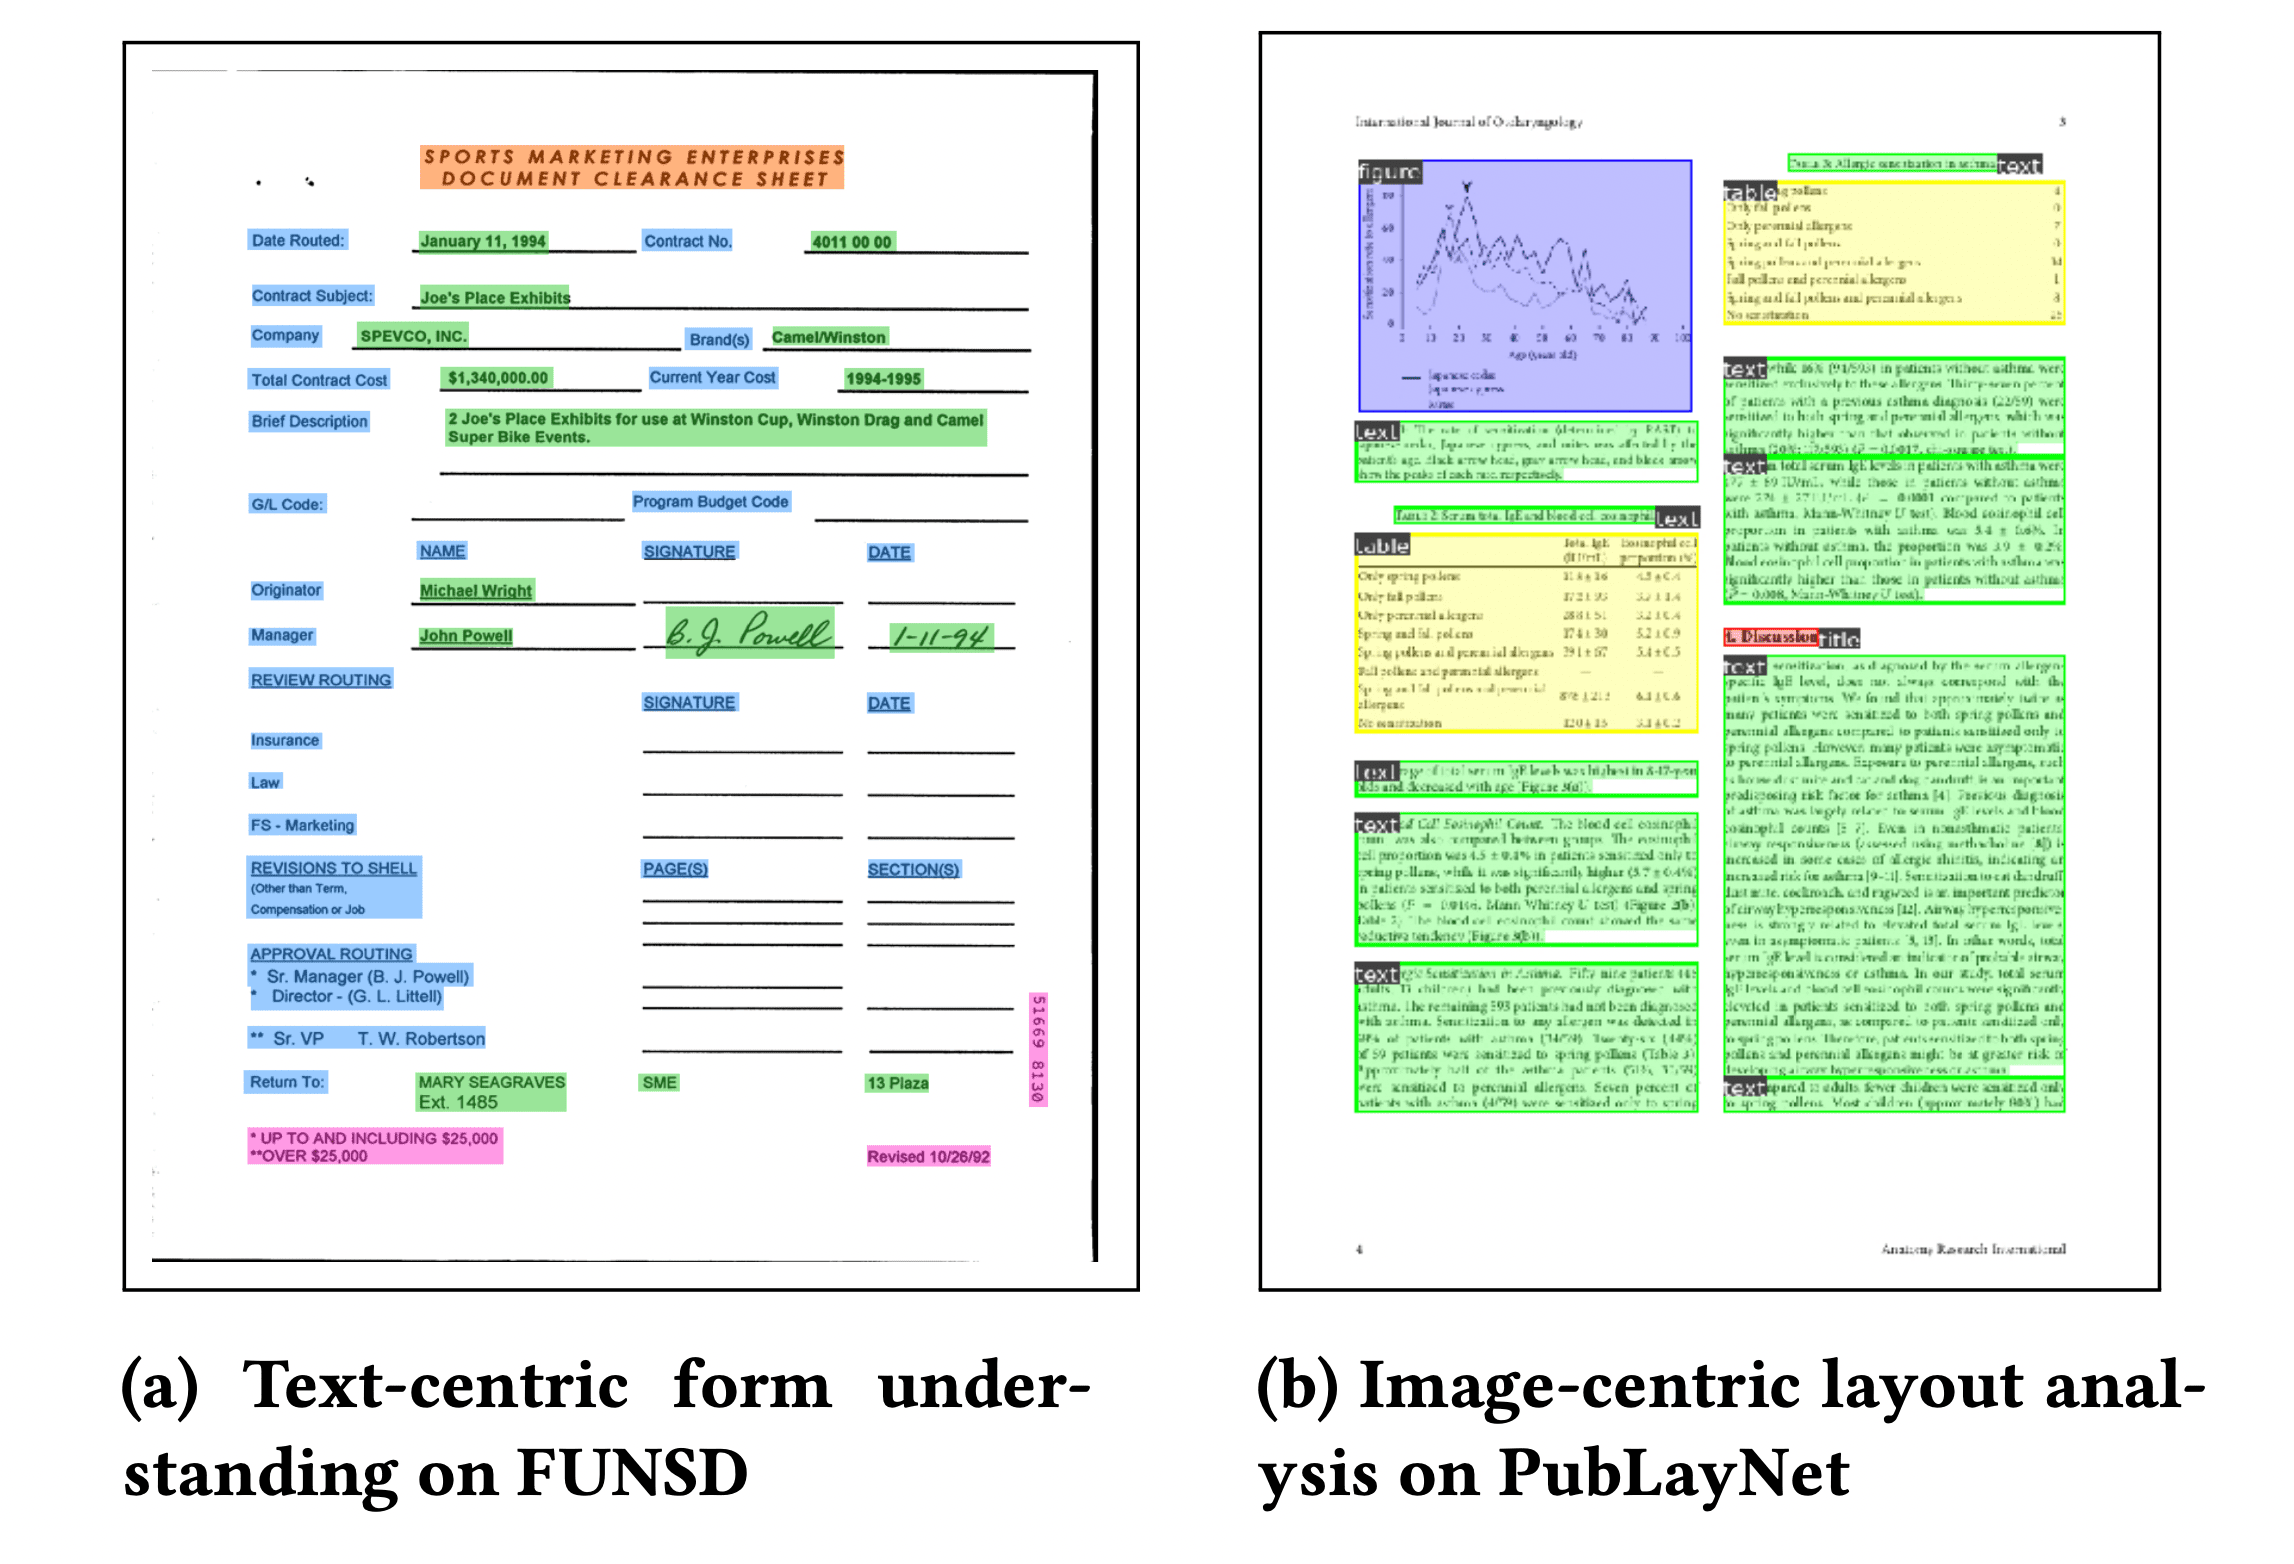
LayoutLM 的许多后继者采用了生成式、端到端的方法。这始于 Donut 模型,它仅将文档图像作为输入并生成文本作为输出,不依赖任何单独的 OCR 引擎。

由编码器-解码器 Transformer 组成的 Donut 模型。取自 Donut 论文。
在 Donut 之后,发布了各种类似的模型,包括 Google 的 Pix2Struct 和 Microsoft 的 UDOP。如今,更大的视觉语言模型如 LLaVa-NeXT 和 Idefics2 可以通过微调以端到端的方式执行文档解析。事实上,这些模型可以微调以执行任何文档 AI 任务,从文档图像分类到文档解析,只要该任务可以定义为图像-文本到文本的任务。例如,参见 教程笔记本 来微调 Google 的 PaliGemma(一个较小的视觉语言模型)以从收据图像返回 JSON。

视觉语言模型如 PaliGemma 可以在任何图像-文本到文本任务上进行微调。参见 教程笔记本。
数据科学家发现文档布局分析和提取是企业关键用例。现有的商业解决方案通常无法处理大多数企业数据的多样性和结构。因此,数据科学团队通常可以通过微调自己的模型来超越商业工具。
文档通常包含表格,而大多数 OCR 工具在表格数据上开箱即用效果不佳。表格检测是识别表格位置的任务,表格提取则创建该信息的结构化表示。表格结构识别是识别构成表格的各个部分的任务,如行、列和单元格。表格功能分析(FA)是识别表格键和值的任务。来自 Table transformer 的图展示了各种子任务之间的区别。
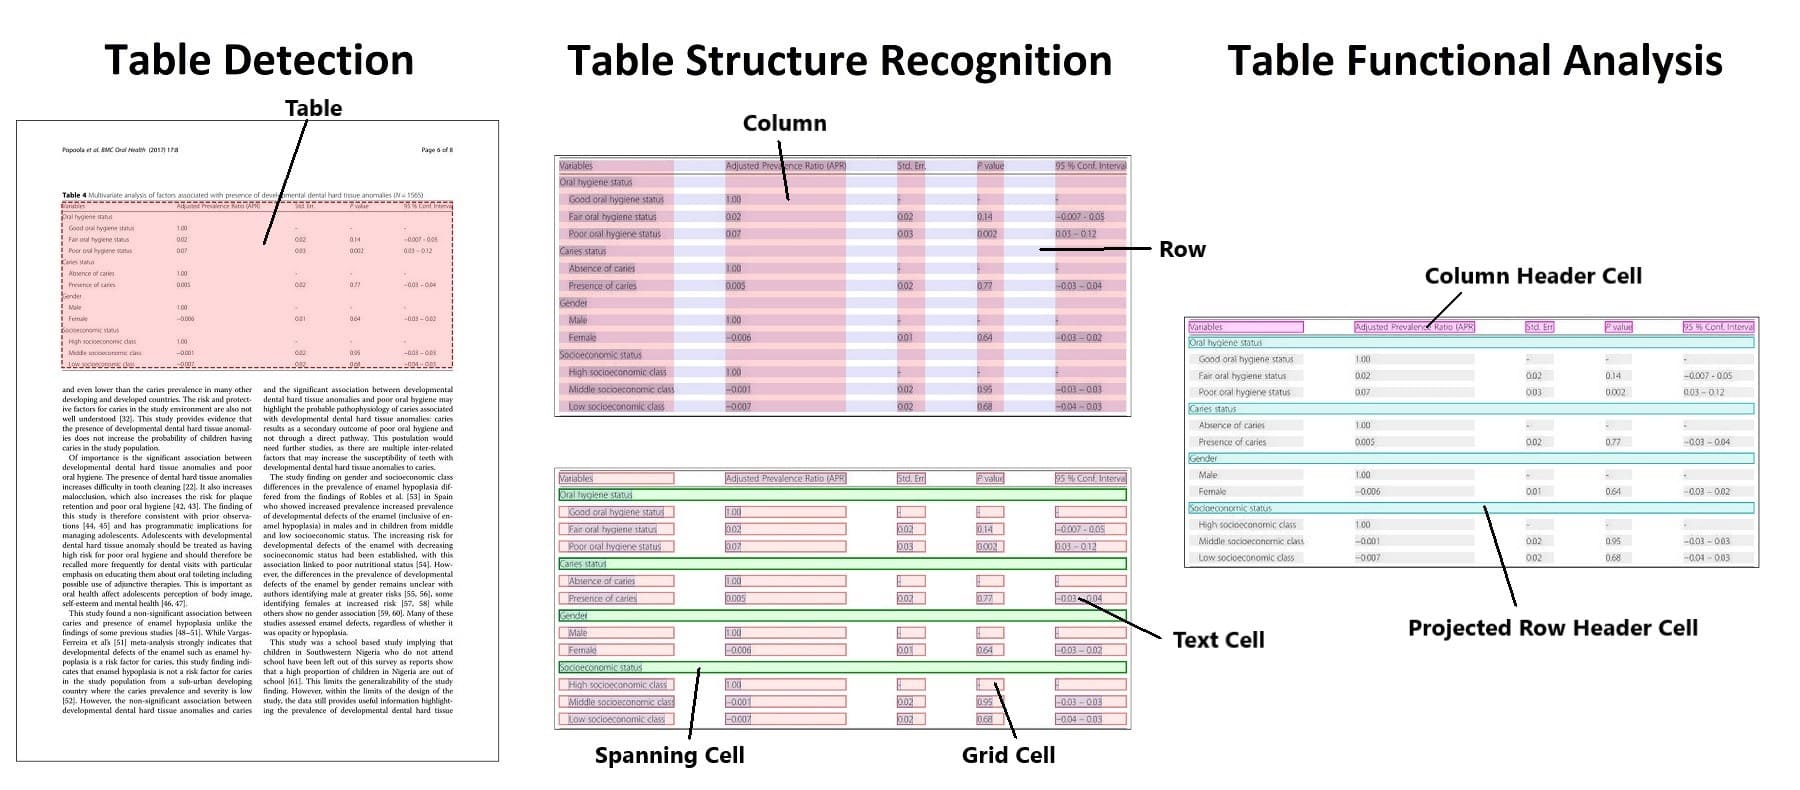
表格检测和结构识别的方法与文档布局分析类似,使用输出一组边界框和对应类别的对象检测模型。
最新的方法,如 Table Transformer,可以使用同一模型实现表格检测和表格结构识别。Table Transformer 是一个类似 DETR 的对象检测模型,在 PubTables-1M(一个包含一百万表格的数据集)上训练。表格检测和结构识别的评估通常使用平均精度(AP)指标。Table Transformer 在 PubTables-1M 上的性能报告为表格检测的 AP 为 0.966,表格结构识别 + 功能分析的 AP 为 0.912。
表格检测和提取是一种令人兴奋的方法,但结果可能在您的数据上有所不同。根据我们的经验,表格的质量和格式差异很大,并可能影响模型的性能。在一些自定义数据上进行额外微调将大大提高性能。
文档问答极大地改变了人们与 AI 交互的方式。近期的进展使得让模型回答关于图像的问题成为可能——这被称为文档视觉问答,简称 DocVQA。在给定一个问题后,模型会分析图像并给出答案。下图展示了来自 DocVQA 数据集的一个示例。用户问:“Mention the ZIP code written?”,模型则给出答案。
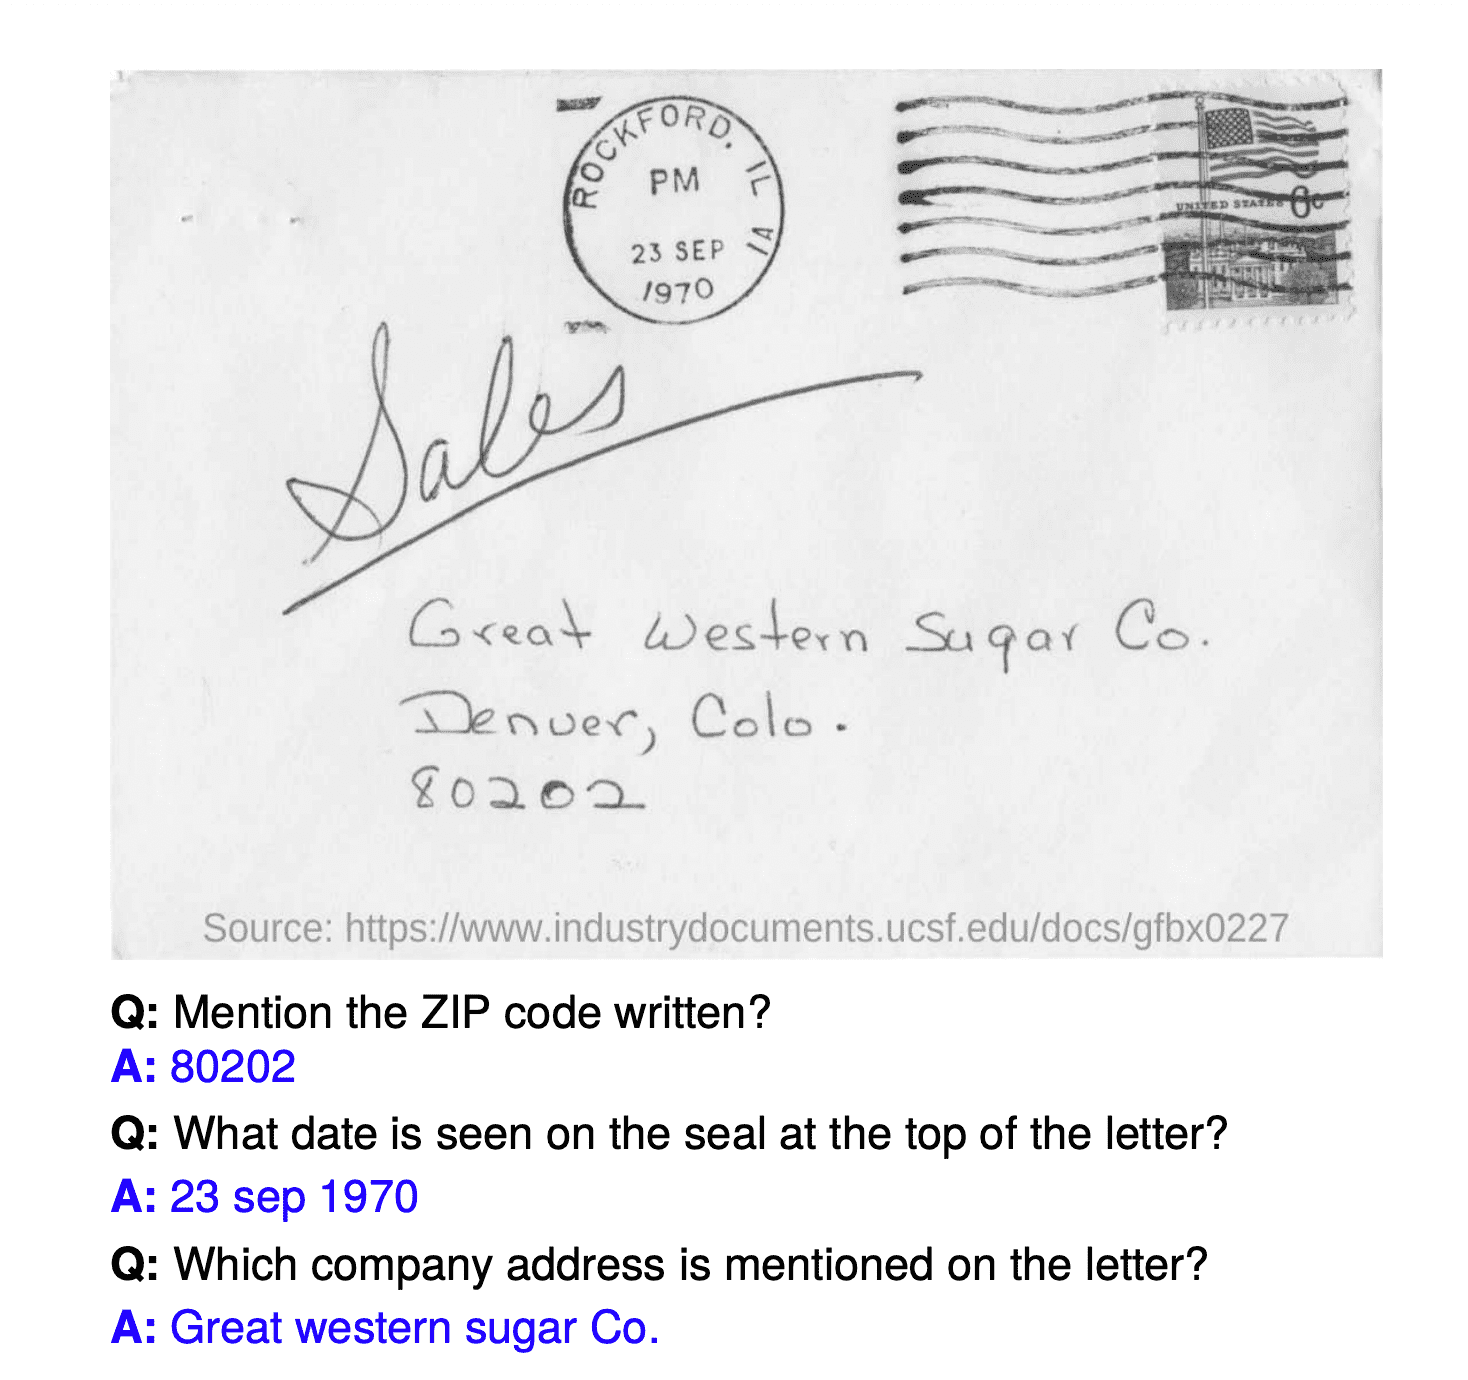
过去,构建一个 DocVQA 系统往往需要多个模型协同工作。 可能会有单独的模型分别用于分析文档布局、执行 OCR、抽取实体,然后再回答问题。最新的 DocVQA 模型能够以端到端的方式进行问答,仅由单个(多模态)模型组成。
DocVQA 通常使用平均归一化 Levenshtein 相似度(ANLS)指标进行评估。关于该指标的更多细节,我们参考本指南。目前在开源 DocVQA 基准上最先进的是 LayoutLMv3,其 ANLS 得分为 83.37。然而,该模型由 OCR + 多模态 Transformer 的流水线组成。
较新的模型,如 Donut、LLaVa-NeXT 和 Idefics2,使用单个基于 Transformer 的神经网络以端到端的方式解决该任务,不依赖 OCR。Impira 托管了一个令人兴奋的 Space,展示了用于 DocVQA 的 LayoutLM 和 Donut。
视觉问答很有吸引力;然而,要成功使用它有许多需要考虑的事项。拥有准确的训练数据、评估指标和后处理至关重要。对于采用这一用例的团队来说,要注意 DocVQA 可能很难正确运行。在某些情况下,回答可能不可预测,模型可能会“幻觉”,给出文档中并未出现的答案。视觉问答模型可能继承数据中的偏见,从而引发伦理问题。确保正确的模型设置和后处理是构建成功的 DocVQA 解决方案不可或缺的一部分。
文档 AI 中的许可问题有哪些?
工业界和学术界为推进文档 AI 做出了巨大贡献。数据科学家可以使用各种各样的模型和数据集。然而,许可问题可能成为构建企业级解决方案的拦路虎。 一些知名模型具有限制性许可证,禁止将模型用于商业目的。最值得注意的是,微软的 LayoutLMv2 和 LayoutLMv3 检查点不能用于商业用途。当你启动一个项目时,我们建议仔细评估候选模型的许可证。从一开始就清楚你想使用哪些模型至关重要,因为这可能会影响数据收集和标注。本文末尾附有流行模型及其许可信息的表格。
文档 AI 中的数据准备问题有哪些?
文档 AI 的数据准备至关重要且充满挑战。拥有正确标注的数据非常关键。以下是我们一路走来学到的一些经验教训,以及应对数据准备的方法。
首先,机器学习依赖于数据的规模和质量。如果你的文档图像质量很差,就不能指望 AI 能够神奇地读取这些文档。同样,如果你的训练数据量小且类别众多,你的性能可能会很差。文档 AI 与机器学习中的其他问题一样,通常数据量越大,性能就越好。
其次,在方法上要灵活。你可能需要测试几种不同的方法才能找到最佳解决方案。一个很好的例子是 OCR,你可以使用像 Tesseract 这样的开源产品、像 Cloud Vision API 这样的商业解决方案,或者像 Donut 这样的开源多模态模型内置的 OCR 能力。
第三,从少量数据标注开始,并明智地选择你的工具。根据我们的经验,几百份文档就能取得不错的效果。所以从小规模开始,仔细评估你的性能。一旦你缩小了整体方法的范围,就可以开始扩大数据规模,以最大化你的预测准确率。在标注时,请记住,像版面识别和文档提取这样的任务需要识别文档中的特定区域。你需要确保你的标注工具支持边界框。
文档 AI 中的建模问题有哪些?
构建模型的灵活性为数据科学家带来了许多选择。我们强烈建议团队从预训练的开源模型开始。这些模型可以针对你的特定文档进行微调,这通常是获得良好模型的最快途径。
对于考虑构建自己的预训练模型的团队,请注意这可能涉及数百万份文档,并且很容易需要数周时间来训练一个模型。构建预训练模型需要大量投入,不建议大多数数据科学团队这样做。相反,从微调一个模型开始,但首先要问自己这些问题。
你希望模型处理 OCR 吗?例如,Donut 不需要对文档进行 OCR,而是直接在全分辨率图像上工作,因此建模前无需 OCR。但是,根据你的问题设置,单独进行 OCR 可能更简单。
你应该使用更高分辨率的图像吗?当使用图像与 LayoutLMv2 时,它会将图像缩小到 224×224,这会破坏图像的原始宽高比。较新的模型如 Donut、Pix2Struct 和 Idefics2 使用完整的高分辨率图像,保持原始宽高比。研究表明,更高的图像分辨率会显著提升性能,因为它让模型能够“看到”更多内容。然而,这也带来了训练和推理所需额外内存的成本。

图像分辨率对下游性能的影响。摘自 Pix2Struct 论文。
你如何评估模型?注意边界框未对齐的问题。你应确保所选 OCR 引擎提供的边界框与模型处理器对齐。验证这一点可以避免意外得到糟糕的结果。其次,让项目需求指导你的评估指标。例如,在标记分类或问答等某些任务中,100% 匹配可能不是最佳指标。像部分匹配这样的指标可以允许考虑更多潜在的标记,例如将“Acme”和“inside Acme”视为匹配。最后,在评估过程中考虑伦理问题,因为这些模型可能处理有偏见的数据,或提供可能对某些人群有偏见的不稳定结果。
后续步骤
你看到 Document AI 的可能性了吗?每天我们都与企业合作,利用最先进的视觉和语言模型解锁有价值的数据。我们在本文中包含了各种演示的链接,因此可以将它们作为起点。文章最后一节包含开始编写自己的模型(如视觉问答)的资源。一旦你准备好开始构建解决方案,Hugging Face 公共 hub 是一个很好的起点。它托管了大量 Document AI 模型。
如果你想加速 Document AI 的工作,Hugging Face 可以提供帮助。通过我们的企业加速计划,我们与企业合作,为 AI 用例提供指导。对于 Document AI,这可能涉及帮助构建预训练模型、提高微调任务的准确性,或为处理你的第一个 Document AI 用例提供总体指导。
我们还可以提供计算积分包,以便大规模使用我们的训练(AutoTrain)或推理(Spaces 或 Inference Endpoints)产品。
资源
许多 Document AI 模型的 notebook 和教程可在以下位置找到:
- Niels 的 Transformers-Tutorials
- Philipp 的 Document AI with Hugging Face Transformers
Document AI 有哪些流行的开源模型?
一个表格,列出了当前可用的、在 Document AI 任务上达到最先进性能的 Transformers 模型。一个重要趋势是,我们看到越来越多的视觉语言模型以端到端方式执行 Document AI 任务,将文档图像作为输入并生成文本作为输出。
此内容最后更新于 2024 年 6 月。
文档 AI 的指标和数据集有哪些?
常见文档 AI 任务的指标和数据集表格。最后更新于 2022 年 11 月。
| 任务 | 典型指标 | 基准数据集 |
|---|---|---|
| 光学字符识别 | 字符错误率(CER) | |
| 文档图像分类 | 准确率、F1 | RVL-CDIP |
| 文档布局分析 | mAP(平均精度均值) | PubLayNet、XFUND(表单) |
| 文档解析 | 准确率、F1 | FUNSD、SROIE、CORD |
| 表格检测与提取 | mAP(平均精度均值) | PubTables-1M |
| 文档视觉问答 | 平均归一化莱文斯坦相似度(ANLS) | DocVQA |
来源:Hugging Face:Blog · huggingface.co