OpenRouter 解析 LangChain 与 CrewAI 编排和 OpenRouter 原生路由的差异
LangChain vs CrewAI: Orchestration Compared to OpenRouter-Native Routing
OpenRouter 发文将多模型编排分为工作流编排、模型路由和提供商路由三层,指出 LangGraph 和 CrewAI 负责工作流编排,OpenRouter 负责模型与提供商路由,二者不互相替代。
原文把多模型编排拆成三层职责,并给出同一管道在直接路由和框架下的对照代码,读者可据此选择自己项目所需的层。
在一个工作流中,你需要不止一个模型。一个成本较低的模型处理常规调用,一个更强的模型处理困难的任务。像 LangChain 和 CrewAI 这样的智能体框架是构建这种工作流的一种方式。两者都提供编排层,但组织方式不同。LangChain 的运行时 LangGraph 为你提供显式的状态和控制流。CrewAI 则将工作组织为基于角色的智能体和事件驱动的流程。
当你构建一个需要规划、保持状态、调用工具或委派工作的智能体时,这两个框架都能提供帮助。如果你只需要为每个步骤选择一个模型,并在某个模型失败时回退,那么完整的编排框架会引入你用不到的部分。
本文按各自承担的任务,比较 LangChain 与 LangGraph、CrewAI 以及 OpenRouter 原生路由。文章展示了同一个两步流水线分别直接针对 OpenRouter 编写和通过 LangChain 编写的版本,说明了我们的 Agent SDK 如何位于两者之间,并展示了当你同时需要编排和路由时,如何将 OpenRouter 置于任一框架之下。
简而言之
- 多模型编排分为三层。工作流编排是规划、状态、记忆和委派。模型路由是为一次调用选择模型,并在返回错误时回退。提供商路由是选择由哪个提供商端点来服务你选定的模型。
- LangGraph 和 CrewAI 负责工作流编排。OpenRouter 负责模型路由和提供商路由。两者不能互相替代。
- OpenRouter 的
models参数是一个有序的回退列表。当第一个模型返回错误时,我们会尝试下一个。回退由错误驱动,不评判回答质量。 - 我们的 Agent SDK 覆盖了中间情况:一个有边界的多轮工具循环,带有验证、流式传输和停止条件,而不需要持久化图或基于角色的团队。
- LangChain 有专门的
ChatOpenRouter集成,CrewAI 通过其LLM类将 OpenRouter 记录为提供商。你可以保留任一框架的编排,并将 OpenRouter 用作底层的模型层。
被混为一谈的三层
“多模型编排”这个说法涵盖了三个不同的决策。将它们分开可以让框架比较变得更简短。
工作流编排是规划、状态、记忆和委派。你将任务分解为步骤,跨轮次和跨运行保持状态,暂停等待人工审核,并将子任务交给其他智能体。LangGraph 和 CrewAI 就是为这一层构建的。
模型路由是选择由哪个模型处理给定的调用,以及当该模型返回错误时会发生什么。OpenRouter 的 models 参数通过一个请求字段处理这一点。
提供商路由是选择由哪个提供商端点来服务你已经选定的模型。OpenRouter 上的许多模型由不止一个提供商提供服务。我们会为每个请求在符合条件的提供商中进行选择,并且在包含工具的请求上,Auto Exacto 会按工具调用性能对这些提供商重新排序。提供商路由绝不会改变你请求的模型。
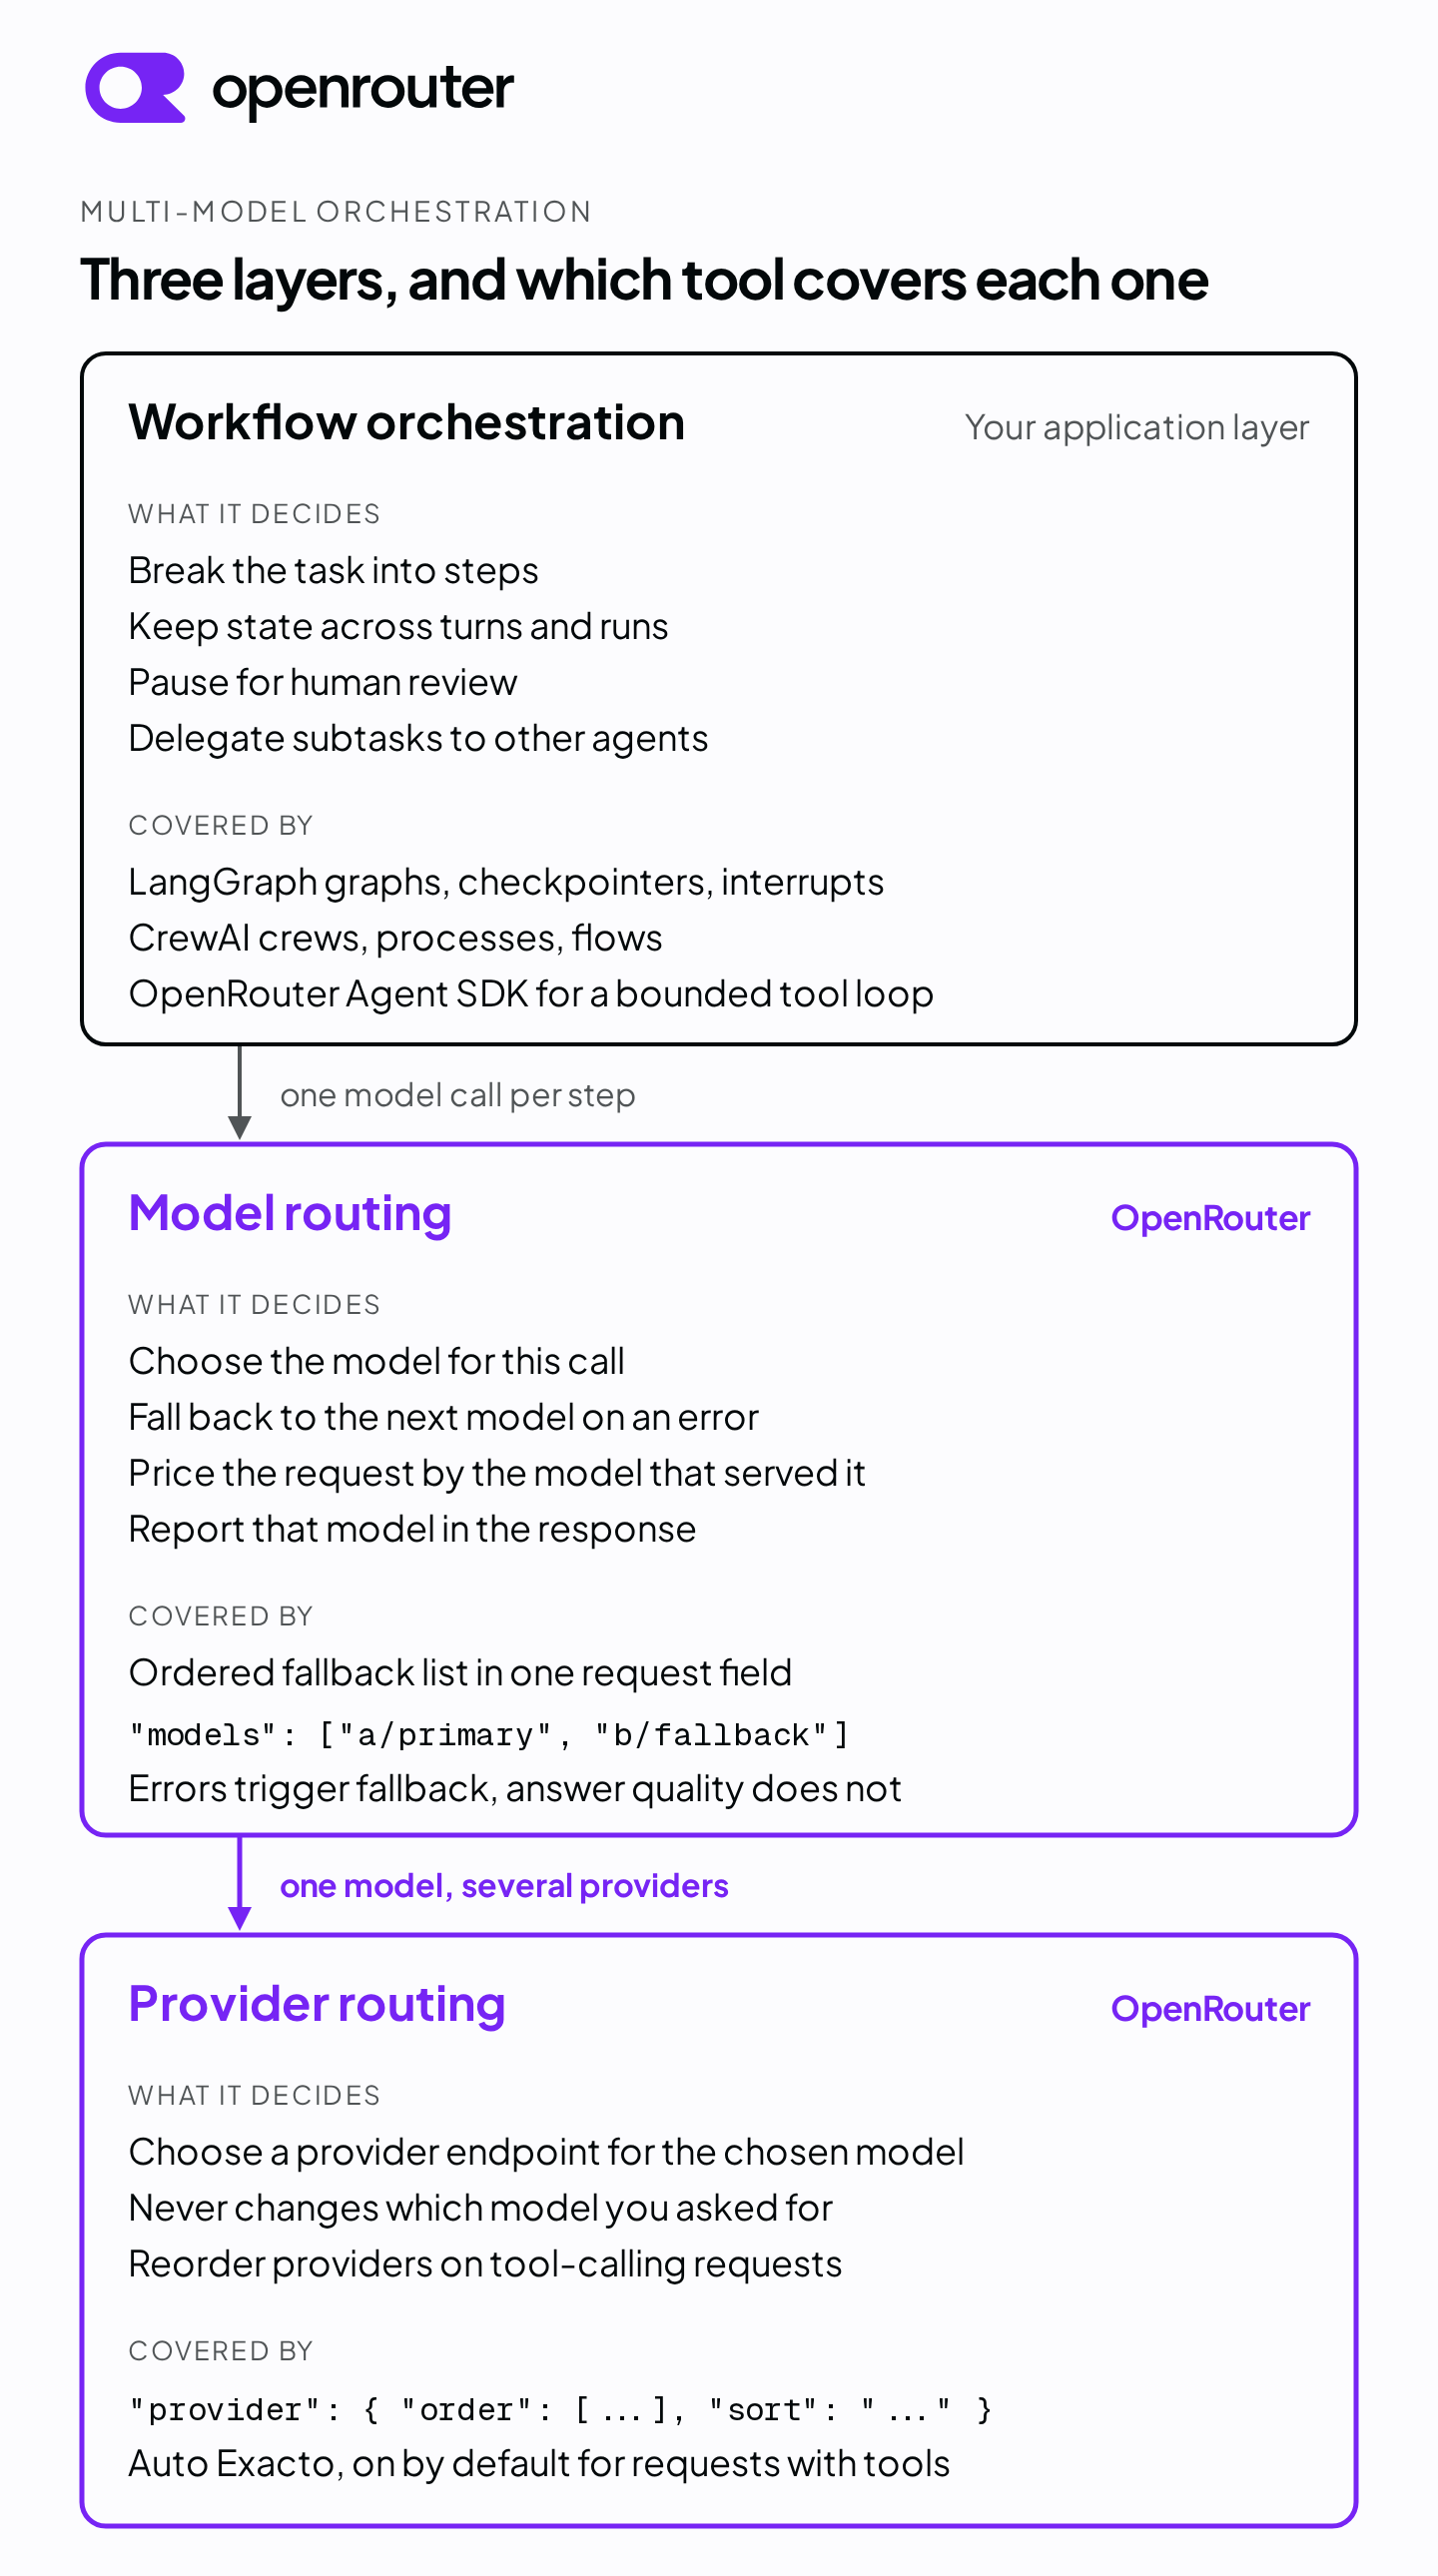
一个工作流可能同时需要这三层。规划逻辑决定下一步做什么,模型路由决定由哪个模型来做,提供商路由决定由哪个端点来服务该模型。你不需要第一层就能获得后两层。一个 models 列表和几条 if 语句就能在没有智能体框架的情况下在模型之间进行路由。
LangChain 与 LangGraph
LangChain 当前的文档描述了两种角色不同的产品。LangChain 是智能体框架,为模型、工具和智能体循环提供抽象和集成。LangGraph 是其底层的低级编排运行时,专注于持久执行、流式传输、人在回路和持久化。你可以在不使用 LangChain 的情况下使用 LangGraph,而 LangChain 的预构建智能体运行在 LangGraph 之上。
LangGraph 将工作流建模为节点图。你可以在同一个图中混合确定性的手写步骤和模型驱动的步骤。持久化来自两个组件。检查点保存器为某个线程保存图状态,从而提供对话连续性、容错、时间旅行以及人工审核的基础。存储则在图状态之外持久化应用数据,用于长期的跨线程记忆。interrupt() 函数可在节点中的任意位置暂停运行,通过检查点保存器保存状态,并等待你用 Command 恢复它,这样在运行继续之前,人可以批准、编辑或拒绝某个步骤。
这种控制力的代价是你需要自己描述控制流。每个节点、边、状态字段、检查点保存器和中断都是你要编写和维护的代码。如果你需要一个多步骤流水线,其中每个节点都可检查、可恢复,LangGraph 为你提供了这种结构。如果你只需要一次带后备的模型调用,那就超出了任务所需。
CrewAI
CrewAI 的文档描述了两种构建块。Crews 是智能体团队,每个智能体都定义了角色、目标和背景故事,它们通过分配的任务协同工作。一个 crew 以顺序流程运行任务,其中每个任务的输出成为下一个任务的上下文;或以分层流程运行任务,由管理者模型或管理者智能体分配和协调任务。当启用 allow_delegation 时,智能体可以相互委派,每个智能体都有一个 max_iter 限制(默认为 20)以及一个可选的 max_execution_time。
Flows 是围绕 crews 的结构化、事件驱动层。一个 flow 定义了步骤、在步骤之间传递的状态以及控制流,包括条件逻辑、循环和分支。每个 flow 实例都携带一个具有唯一 ID 的状态对象,该对象在运行期间持续存在。CrewAI 的简介将 flows 定位为应用的骨干,将 crews 定位为 flow 内的工作单元。
CrewAI 的模型更接近任务描述,而不是图定义。你把更多精力花在角色、目标和任务字符串上,而花在连接节点上的精力更少。这是与 LangGraph 不同的权衡,而不是它的缩小版。Crews 给智能体留出决定如何完成任务的空间,而 flows 则是你收回控制权的地方。
对比
| LangChain 和 LangGraph | CrewAI | OpenRouter 直连 | |
|---|---|---|---|
| 构建目标 | 基于图的编排,具有显式状态、持久化和人工审核 | 事件驱动流程内基于角色的智能体团队 | 每次调用选择模型、错误驱动的后备以及提供商路由 |
| 多模型支持 | 是,每个节点或智能体一个模型对象 | 是,每个智能体、crew 或管理者一个 LLM | 是,每个请求一个 models 列表 |
| 规划、记忆和委派 | 是,在图、检查点保存器和存储中显式体现 | 是,通过智能体、流程和 flow 状态实现 | 否,仅路由 |
| 流式传输 | 是 | 是,在 crew 级别使用 stream=True | 是,按请求 |
| 人工审核 | interrupt() 配合检查点保存器 | 你编写的 flow 逻辑 | 未提供 |
| 你需要编写的内容 | 节点、边、状态模式、持久化配置 | 智能体、任务、crew 和 flow 定义 | 一个请求体 |
OpenRouter 原生路由
这里的“原生”指的是不使用框架。你向https://openrouter.ai/api/v1/chat/completions发送请求,在models参数中按优先级顺序列出你的模型,剩下的交给我们处理。如果第一个模型返回错误,我们会尝试列表中的下一个模型。默认情况下,任何错误都可以触发回退,包括上下文长度验证错误、被过滤模型的审核标记、速率限制和停机。如果回退模型也返回错误,我们就返回该错误。我们按照最终实际服务该请求的模型来计费,响应中的model字段会告诉你具体是哪一个。
回退是对错误做出反应。它不会评估第一个模型的回答是否足够好。如果你想让更强的模型来审查较弱模型的输出,那是你代码中的第二步,而不是models列表替你做的事。
以一个两步流水线为例:用一个模型起草,然后用另一个模型审查草稿,每一步在第一个模型返回错误时回退。直接针对 OpenRouter 编写的话,就是一个函数和两个models列表。
import os

import requests


def route(models: list[str], prompt: str) -> tuple[str, str]:
    response = requests.post(
        "https://openrouter.ai/api/v1/chat/completions",
        headers={"Authorization": f"Bearer {os.environ['OPENROUTER_API_KEY']}"},
        json={"models": models, "messages": [{"role": "user", "content": prompt}]},
        timeout=120,
    )
    response.raise_for_status()
    body = response.json()
    return body["choices"][0]["message"]["content"], body["model"]


draft, draft_model = route(
    ["anthropic/claude-sonnet-5", "openai/gpt-5.6-sol"],
    "Draft a one-paragraph summary of what a model fallback list does.",
)
review, review_model = route(
    ["openai/gpt-5.6-sol", "anthropic/claude-sonnet-5"],
    f"Review this draft for accuracy and suggest one improvement:\n\n{draft}",
)
print(f"draft by {draft_model}, review by {review_model}")
print(review)
要把某一步交给不同的模型,你只需更改列表。因为我们的 API 与 OpenAI 兼容,同样的 chat completions 请求结构适用于目录中的每个聊天模型,更换模型就是更改一个字符串。服务于其他端点的模型,例如 embeddings、视频、文本转语音或语音转文本,使用它们各自的请求结构。
通过 LangChain 实现同样的流水线,则使用专用的ChatOpenRouter模型类。你为每一步创建一个模型对象,用 LangChain 的with_fallbacks包装每一个,这样调用失败时会在下一个模型对象上重试,然后通过invoke调用结果。
from langchain_openrouter import ChatOpenRouter

drafter = ChatOpenRouter(model="anthropic/claude-sonnet-5").with_fallbacks(
    [ChatOpenRouter(model="openai/gpt-5.6-sol")]
)
reviewer = ChatOpenRouter(model="openai/gpt-5.6-sol").with_fallbacks(
    [ChatOpenRouter(model="anthropic/claude-sonnet-5")]
)

draft = drafter.invoke("Draft a one-paragraph summary of what a model fallback list does.")
review = reviewer.invoke(
    f"Review this draft for accuracy and suggest one improvement:\n\n{draft.content}"
)
print(review.content)
两个版本都将同样的两个步骤路由到同样的两个模型,并采用相同的回退顺序。区别在于回退在哪里运行。在直接版本中,我们在服务端于单个请求内运行它。在 LangChain 版本中,框架在你的进程中捕获失败的调用,并发送第二个请求。对于用 LangChain 的create_agent构建的 agent,框架还提供ModelFallbackMiddleware,在主模型失败时尝试替代模型。框架版本为你提供模型对象和共享的invoke接口,一旦有了图、检查点或一组要管理的工具,这就是你想要的结构。如果没有这些,它就是额外的开销。
无论哪个版本,通过我们路由都会带来三件事。每个响应都包含一个usage对象,其中有 token 数量和以 credits 计的成本,无需额外参数,因此你可以在决定分层设置是否值得之前,看到每次调用的成本。受支持模型上的提示缓存可降低重复上下文的成本。当请求包含工具时,Auto Exacto默认运行。它利用吞吐量、工具调用成功率和基准数据,为你所选模型重新排列提供商顺序,因此工具调用会落到具有良好工具调用记录的提供商上,而你无需进行任何配置。Auto Exacto 改变的是提供商顺序,而不是模型。
直接路由不会规划、不会跨轮次保持状态,也不会决定哪个子任务交给哪个 agent。那是工作流编排层的事,而models列表并不提供它。下一步升级并不总是一个完整的框架。
OpenRouter Agent SDK
在直接路由和完整框架之间,是我们的 Agent SDK,即 @openrouter/agent 包。聊天补全是无状态的。你发送消息,得到一次响应。要把它变成智能体,就需要运行一个循环:模型请求工具调用,你的代码验证参数并运行工具,结果返回给模型,循环重复直到工作完成。Agent SDK 把这个循环封装成一个 callModel 函数。
你用 tool() 辅助函数和 Zod schema 定义工具,SDK 负责跨轮次的验证、执行和对话状态。stepCountIs 和 maxCost 等停止条件约束循环。每个条件在步骤完成后检查,因此 maxCost 会在达到阈值的步骤之后停止循环,而不是阻止该步骤,默认情况下 SDK 随后会再进行一次模型轮次以生成最终答案。把 maxCost 视为停止规则,而不是支出上限。流式传输是内置的,你还可以接入远程 MCP 服务器作为工具来源。
import { OpenRouter, tool, stepCountIs, maxCost } from "@openrouter/agent";
import { z } from "zod";

const client = new OpenRouter({ apiKey: process.env.OPENROUTER_API_KEY });

const result = client.callModel({
  model: "anthropic/claude-sonnet-5",
  input: "What time is it in Tokyo?",
  tools: [
    tool({
      name: "get_time",
      description: "Get the current time in a timezone",
      inputSchema: z.object({ timezone: z.string() }),
      execute: async ({ timezone }) => ({
        time: new Date().toLocaleString("en-US", { timeZone: timezone }),
      }),
    }),
  ],
  stopWhen: [stepCountIs(5), maxCost(0.5)],
});

const text = await result.getText();
console.log(text);
该 SDK 用 TypeScript 编写,Python 和 Go 移植版保持同步。它为你提供一个带验证、流式传输和停止条件的有界工具循环。它不提供持久化图、检查点器或基于角色的团队。
对于单个请求内的委派,openrouter:subagent 服务器工具允许模型在生成过程中将自包含任务交给工作模型。工作模型可以是 OpenRouter 上的任何模型。每个任务都是独立的。工作模型只看到任务描述,任务之间不保留记忆。服务器工具处于测试阶段,API 和行为可能会变化。
该 SDK 还涵盖该循环内的人工审批和持久化对话状态。工具可以设置 requireApproval 以在运行前暂停,而 StateAccessor 会在 callModel 调用之间持久化消息、审批和工具结果。它不提供的是具有显式转换和检查点的持久化图,或跨智能体团队的协调。当你需要这些时,那就是升级到 LangGraph 或 CrewAI 的时候。
在 LangChain 或 CrewAI 之下使用 OpenRouter
你不必在框架和网关之间二选一。你可以保留框架的规划、状态和委派,并在其下使用 OpenRouter 作为模型层。
对于 LangChain,我们维护了一个专门的 集成。Python 的 langchain-openrouter 包和 JavaScript 的 @langchain/openrouter 包为你提供了一个 ChatOpenRouter 模型,你可以将智能体和图指向它。LangChain 的文档目前将 Python 集成标记为测试版。
from langchain_openrouter import ChatOpenRouter

model = ChatOpenRouter(
    model="anthropic/claude-sonnet-5",
    temperature=0,
    model_kwargs={"models": ["anthropic/claude-sonnet-5", "openai/gpt-5.6-sol"]},
)
一个 ChatOpenRouter 对象发送一个 model 值。要在 LangChain 下使用我们的服务器端回退,请将 models 列表通过 model_kwargs 传递,该包会将其展开到请求体中。没有它,回退就是框架的职责,如上面的 with_fallbacks 示例所示。
对于 CrewAI,你用我们的端点配置其 LLM 类。CrewAI 的 LLM 文档 将 OpenRouter 列为使用 LiteLLM 的提供商,因此你安装 crewai[litellm] 额外项,在模型 slug 前加上 openrouter/,并传入我们的基础 URL 和你的密钥。
import os

from crewai import LLM

llm = LLM(
    model="openrouter/anthropic/claude-sonnet-5",
    base_url="https://openrouter.ai/api/v1",
    api_key=os.environ["OPENROUTER_API_KEY"],
)
CrewAI 示例配置了一个模型。提供商路由适用于每个请求,而更改处理某个步骤的模型就是更改 slug。服务器端模型回退仅在请求携带 models 列表时适用,而 CrewAI 的文档没有涵盖传递该字段。在这两种情况下,你的图或团队都按设计继续工作,而要使用不同模型只需更改配置,而不是新的提供商集成或为每个模型使用单独的 API 密钥。
选择一层
如果你的直接实现开始积累状态机、可恢复检查点、审批步骤和委派规则,那你就是在手工构建一个工作流编排层,而框架可以替代你原本需要自行设计和维护的代码。这是我们的编辑指导,而非产品保证,它从你的应用必须自己承担的行为出发。
- 当工作流已经清晰,你只需要为每次调用选择模型、添加回退列表或控制提供商路由时,使用 OpenRouter 原生路由。
- 当你需要一个有边界的多轮工具循环,具备验证、流式传输和停止条件,且不需要持久化图或基于角色的团队时,使用 OpenRouter Agent SDK。
- 当你需要显式的状态转换、持久化、恢复、人工审核,或确定性步骤与模型驱动步骤的混合时,使用 LangGraph。
- 当工作可以映射到专家智能体、任务委派以及顺序或层级协作时,使用 CrewAI;当外围应用需要结构化状态和控制时,使用 flows。
- 当你希望框架负责编排、OpenRouter 负责模型访问和提供商路由时,将 OpenRouter 置于 LangGraph 或 CrewAI 之下,并在框架转发
models列表时使用服务端模型回退。
结论
多模型编排分为三层。工作流编排是规划、状态、记忆和委派,LangGraph 和 CrewAI 为此而生,但各有取舍。LangGraph 提供显式的图控制,代价是你需要自己编写这些控制;CrewAI 提供基于角色的智能体和 flows,代价是将更多执行路径交给智能体。模型路由和提供商路由是 OpenRouter 的职责,无论上面是否叠加框架,我们的做法都一样。
如果你不确定你的项目属于哪一边,先尝试较小的投入。在决定需要在上层加框架之前,先用一个 models 列表将两步工作流路由到两个模型上。当你为任一方法选择模型时,模型目录 允许你按支持的参数进行筛选,包括 tools。
常见问题
使用多个模型需要 LangChain 或 CrewAI 吗?
不需要。如果你唯一的需求是为一次调用选择模型,并在第一个模型返回错误时回退到另一个模型,OpenRouter 的 models 参数可以在一个请求中完成。当工作流还需要规划、持久状态、记忆、人工审核或智能体之间的委派时,再选择 LangGraph 或 CrewAI。
如何在一个智能体工作流中编排多个 LLM?
将各层分开。对于跨步骤的规划、状态和委派,使用编排框架,如 LangGraph 或 CrewAI。对于选择哪个模型处理每次调用,向 OpenRouter 发送一个有序的 models 列表,让我们在第一个模型返回错误时回退到下一个模型。我们还会为处理该调用的模型选择提供商端点。一个工作流可以同时使用两者,框架在上,OpenRouter 在下作为模型层。
我可以将 OpenRouter 与 LangChain 或 CrewAI 一起使用,而不是二选一吗?
是的。LangChain 在 Python 的 langchain-openrouter 包和 JavaScript 的 @langchain/openrouter 包中都有专门的 ChatOpenRouter 集成。CrewAI 通过其 LLM 类使用 LiteLLM 将 OpenRouter 记录为提供商。在这两种情况下,框架负责编排,OpenRouter 提供模型访问和提供商路由。我们的服务器端模型回退仅在请求携带 models 列表时运行,ChatOpenRouter 会通过其 model_kwargs 参数转发该列表。
采用 LangChain 或 CrewAI 会让我锁定到单一模型提供商吗?
如果你将框架指向 OpenRouter 而不是单一提供商的 SDK,就不会。两个框架都接受 OpenRouter 作为模型提供商,因此更改处理某个步骤的模型只需更改框架配置中的模型字符串,而无需重写提供商集成。你仍然可以访问 OpenRouter 上的所有模型。
OpenRouter 的模型回退会判断答案的质量吗?
不会。回退是由错误驱动的。当你的 models 列表中的第一个模型返回错误时,例如上下文长度验证错误、审核标记、速率限制或停机,我们会尝试列表中的下一个模型。成功的响应会按原样返回,响应中的 model 字段会告诉你哪个模型生成了它。
参考文献
- 模型回退,OpenRouter
- 提供商路由,OpenRouter
- Auto Exacto,OpenRouter
- 提示缓存,OpenRouter
- 工具调用,OpenRouter
- Agent SDK 和 停止条件,OpenRouter
- 子代理服务器工具,OpenRouter
- LangChain 集成,OpenRouter
- LangGraph 概述、持久化 和 中断,LangChain
- ChatOpenRouter 和 内置中间件,LangChain
- 简介、流程、过程、代理 和 LLM,CrewAI
来源:OpenRouter:Announcements · openrouter.ai